

AlphaGo contra AlphaGo Zero: O Choque dos Titãs da IA
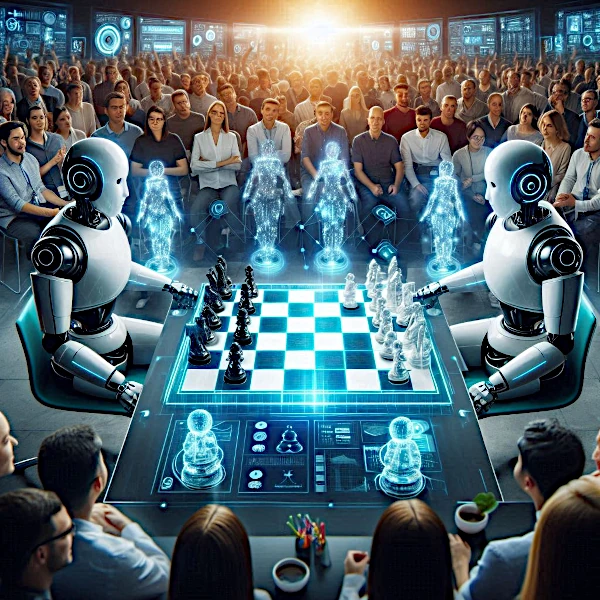
Partida histórica: a IA contra o grande mestre.
Fonte da imagem: astronoo.com (nova janela) — imagem gerada por IA, domínio público.
Resumo científico
O artigo da Astronoo compara AlphaGo (2016) e AlphaGo Zero (2017), dois sistemas de inteligência artificial desenvolvidos pela DeepMind para o jogo de Go. AlphaGo utilizava aprendizagem supervisionada em milhões de jogos humanos, combinada com aprendizagem por reforço. AlphaGo Zero revolucionou esta abordagem ao aprender a partir do zero, apenas com as regras do jogo e jogando contra si mesmo. Em 40 dias, AlphaGo Zero superou todas as versões anteriores, vencendo AlphaGo Master por 100 a 0. Esta demonstração provou que a IA pode atingir o superdesempenho sem depender de dados ou estratégias humanas, abrindo caminho a aplicações em diversos campos como a biologia estrutural (AlphaFold) ou a otimização energética.
Qual é a diferença entre AlphaGo e AlphaGo Zero e porque é que o seu encontro é histórico?
AlphaGo (2016) foi o primeiro programa de IA a vencer um campeão mundial de Go, Lee Sedol, utilizando aprendizagem supervisionada em milhões de jogos humanos, combinada com aprendizagem por reforço contra si mesmo. AlphaGo Zero (2017) revolucionou esta abordagem ao aprender a partir do zero, sem quaisquer dados humanos: apenas as regras do jogo e jogando milhões de jogos contra si mesmo. Em 40 dias, AlphaGo Zero superou todas as versões anteriores de AlphaGo, vencendo-o 100 a 0 em jogos de teste. Esta vitória demonstrou que a IA pode atingir o superdesempenho sem ser limitada pelos dados ou estratégias humanas.
A História do Encontro AlphaGo contra AlphaGo Zero
Um ponto de viragem na inteligência artificial
A história do encontro entre AlphaGo e AlphaGo Zero marca um ponto de viragem significativo no campo da inteligência artificial (IA). Estes dois sistemas, desenvolvidos pela DeepMind, uma subsidiária da Google, não só ultrapassaram os limites do que se pensava ser possível para as máquinas, mas também abriram novas perspetivas para a aprendizagem automática e para a IA em geral.
O contexto da competição
A comparação entre AlphaGo e AlphaGo Zero não se realizou durante um jogo público, mas num ambiente de laboratório na DeepMind, sediada em Londres. Os investigadores utilizaram simulações e referências para medir objetivamente o desempenho dos dois sistemas, demonstrando a superioridade do AlphaGo Zero.
AlphaGo: O Precursor
A primeira vitória contra um campeão mundial
AlphaGo, lançado em 2016, causou sensação ao vencer Lee Sedol, um dos melhores jogadores de Go do mundo, numa série de jogos muito publicitados. O Go, um jogo de estratégia complexo originário da China, era considerado um dos últimos bastiões da superioridade humana em jogos de estratégia. A vitória do AlphaGo demonstrou que as máquinas podiam não só igualar, mas também superar os humanos em tarefas que exigem inteligência e estratégia avançadas.
A arquitetura do AlphaGo: supervisão e reforço
AlphaGo utilizava uma combinação de técnicas de aprendizagem supervisionada e aprendizagem por reforço. Foi treinado em milhões de jogos de Go jogados por humanos, e depois refinou as suas capacidades jogando contra si mesmo. Esta abordagem permitiu ao AlphaGo desenvolver estratégias inovadoras e surpreender até os especialistas humanos.
AlphaGo Zero: A Inovação
A aprendizagem a partir do zero (tabula rasa)
AlphaGo Zero, introduzido em 2017, representou um avanço ainda mais impressionante. Ao contrário de AlphaGo, AlphaGo Zero não foi treinado em jogos de Go jogados por humanos. Em vez disso, aprendeu a jogar Go a partir do zero, utilizando apenas as regras do jogo e jogando milhões de jogos contra si mesmo. Esta abordagem, conhecida como aprendizagem por reforço a partir do zero, permitiu ao AlphaGo Zero desenvolver estratégias totalmente novas e superar o AlphaGo em apenas 40 dias de treino.
Um treino mais eficiente e rápido
AlphaGo Zero utilizou uma única rede neuronal, ao contrário de AlphaGo que utilizava duas (uma para política, outra para valor). Esta simplificação, combinada com um aumento da potência de cálculo, permitiu ao AlphaGo Zero atingir um nível de jogo superior em tempo recorde.
O Encontro Histórico
O jogo teórico: AlphaGo Master vs AlphaGo Zero
O encontro teórico entre AlphaGo e AlphaGo Zero foi um momento chave para avaliar os progressos realizados no campo da IA. Estes jogos decorreram num ambiente de laboratório na DeepMind, sediada em Londres. Foram realizados para fins de investigação e não tiveram lugar perante um público ou num contexto competitivo. Os resultados mostraram um domínio esmagador do AlphaGo Zero, com um rácio de vitórias de 100 a 0 contra o AlphaGo Master (a versão mais avançada do AlphaGo que tinha vencido Lee Sedol).
As lições desta confrontação
Esta vitória demonstrou que os sistemas de IA podiam aprender e melhorar de forma autónoma, sem necessidade de dados humanos para os guiar. Também provou que a aprendizagem por reforço puro, sem supervisão humana, podia conduzir a estratégias mais criativas e eficazes do que as desenvolvidas pelos humanos.
Implicações e Perspetivas
Uma rutura com os dados humanos
A vitória do AlphaGo Zero teve profundas implicações para a IA. Mostrou que os sistemas de aprendizagem automática podiam ser ainda mais potentes e eficazes quando libertados das limitações dos dados humanos. A vitória do AlphaGo Zero reforçou a determinação da China em investir massivamente na investigação e desenvolvimento da IA. O governo chinês já implementou várias iniciativas para se tornar um líder mundial neste campo. Por exemplo, o plano "Made in China 2025" inclui objetivos ambiciosos para a IA, e empresas chinesas como Baidu, Alibaba e Tencent estão a investir milhares de milhões em projetos de IA.
Aplicações para além do jogo de Go
O princípio da aprendizagem por reforço a partir do zero foi alargado a outros campos: resolução de problemas de dobragem de proteínas (AlphaFold), otimização do consumo energético dos centros de dados, descoberta de novos materiais, ou desenvolvimento de estratégias em química e física fundamental. Esta abordagem consiste em definir regras e uma função de recompensa, e depois deixar que a IA explore e otimize por si mesma.
Conclusão
Um momento crucial na história da IA
O encontro teórico entre AlphaGo e AlphaGo Zero ficará nos anais da história da IA como um momento crucial. Não só demonstrou as impressionantes capacidades dos sistemas de aprendizagem automática, mas também abriu novas perspetivas para o futuro da IA.
Rumo a uma IA cada vez mais autónoma
AlphaGo Zero provou que a IA pode atingir o superdesempenho sem depender da experiência humana, abrindo caminho a sistemas de IA capazes de resolver problemas complexos em áreas onde os dados humanos são escassos ou inexistentes.
Referências
- Silver et al. (2017) - Mastering the game of Go without human knowledge (Nature) - AlphaGo Zero (nova janela)
- Silver et al. (2016) - Mastering the game of Go with deep neural networks and tree search (Nature) - AlphaGo (nova janela)
- DeepMind - AlphaGo - Site oficial (nova janela)
- Silver et al. (2017) - Mastering the game of Go without human knowledge (arXiv) (nova janela)
- Jumper et al. (2021) - Highly accurate protein structure prediction with AlphaFold (Nature) (nova janela)
- DeepMind - AlphaFold - Site oficial (nova janela)
FAQ: Tudo o que precisa de saber sobre AlphaGo, AlphaGo Zero e a sua revolução
Porque é que o jogo de Go é um desafio tão difícil para a IA?
O Go é um jogo de estratégia de complexidade combinatória vertiginosa. Enquanto o xadrez tem cerca de 10¹²⁰ posições possíveis, o Go tem aproximadamente 10¹⁷⁰ (mais do que o número de átomos no universo observável). Esta complexidade torna impossível a abordagem de "força bruta" (exploração exaustiva de todos os movimentos). Durante muito tempo, o Go foi considerado um dos últimos bastiões da superioridade humana sobre as máquinas, porque exige intuição estratégica, avaliação de posição e uma visão global difíceis de programar.
Qual é a diferença fundamental entre AlphaGo e AlphaGo Zero?
A diferença chave reside nos seus dados de treino. AlphaGo foi treinado em duas fases: primeiro por aprendizagem supervisionada em milhões de jogos jogados por humanos (para imitar os melhores jogadores), e depois por aprendizagem por reforço jogando contra si mesmo. AlphaGo Zero eliminou a primeira fase: aprendeu a partir do zero (tabula rasa), conhecendo apenas as regras do jogo. Jogou milhões de jogos contra si mesmo, descobrindo sozinho estratégias inovadoras que os humanos nunca tinham imaginado. Esta abordagem não só superou o AlphaGo, como também produziu um jogo mais "criativo" e eficiente.
Quais são as implicações da vitória do AlphaGo Zero para além do jogo de Go?
A vitória do AlphaGo Zero tem implicações importantes: demonstra que a IA pode atingir o superdesempenho sem depender de dados humanos potencialmente enviesados ou subótimos. Este princípio de "aprendizagem por reforço a partir do zero" foi alargado a outros campos: resolução de problemas de dobragem de proteínas (AlphaFold), otimização do consumo energético dos centros de dados, descoberta de novos materiais, ou desenvolvimento de estratégias em química e física fundamental. O método consiste em definir regras e uma função de recompensa, e depois deixar que a IA explore e otimize por si mesma.
Qual tem sido o impacto do AlphaGo e AlphaGo Zero na investigação em IA?
AlphaGo e AlphaGo Zero tiveram um impacto considerável na investigação em IA. Demonstraram o poder da aprendizagem por reforço profundo (deep reinforcement learning) e inspiraram muitas investigações neste campo. Também provaram que é possível desenvolver sistemas de IA capazes de resolver problemas complexos sem necessidade de experiência humana prévia, abrindo caminho a aplicações em áreas onde os dados humanos são escassos ou caros de obter.
O AlphaGo Zero pode ser aplicado a outros jogos ou problemas?
Sim, o princípio do AlphaGo Zero foi aplicado a outros jogos, nomeadamente ao xadrez e ao shogi, com resultados igualmente impressionantes: o AlphaZero (a versão generalizada) venceu os melhores programas de xadrez e shogi em poucas horas de treino. Para além dos jogos, os princípios do AlphaGo Zero são utilizados para resolver problemas científicos complexos, como a previsão de estruturas de proteínas (AlphaFold) ou a otimização de sistemas complexos.
O que é o AlphaFold e qual é a sua relação com o AlphaGo Zero?
AlphaFold é um sistema de IA desenvolvido pela DeepMind para prever a estrutura 3D das proteínas a partir da sua sequência de aminoácidos. Utiliza princípios semelhantes aos do AlphaGo Zero: a aprendizagem por reforço e a exploração autónoma do espaço de soluções. O AlphaFold revolucionou a biologia estrutural ao resolver um problema que permanecera insolúvel durante 50 anos. É considerado uma das aplicações mais importantes das técnicas desenvolvidas com o AlphaGo Zero.
 IA Agêntica: Quando as máquinas se tornam autônomas
 O que a IA não pode fazer
 Inteligência artificial e astronomia: Compreender o papel dos assistentes IA
 Ferramentas de IA: como escolher?
 IA Generativa vs AGI: Onde termina a imitação e onde começa a consciência?
 Redes artificiais vs. redes biológicas: Dois sistemas, uma arquitetura comum
 Cérebro Humano e Inteligências Artificiais: Semelhanças e Diferenças
 AlphaGo contra AlphaGo Zero: Uma Revolução na Inteligência Artificial
 O próximo passo das máquinas inteligentes
 Do Neurônio Biológico ao Neurônio Formal: Simplificação do Cérebro
 Inteligência artificial: a explosão do gigantismo
 Quando a inteligência artificial enlouquece!
 Emergência da inteligência artificial: Ilusão de inteligência ou inteligência?
 Desafio e ameaça da Inteligência Artificial
 Como as máquinas entendem, interpretam e geram linguagem de maneira semelhante aos humanos?
 Como funciona uma rede neural artificial?