

Künstliche Intelligenz: Lärmerzeuger und die Kognitive Blase Steht Vor Dem Platzen
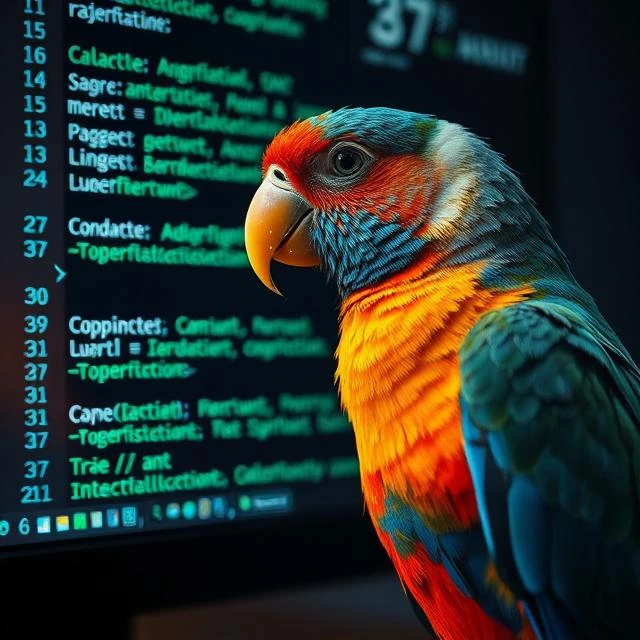
Dieses Bild zeigt einen Papagei vor einem Bildschirm, der mit zufällig zusammengesetzten Wörtern gefüllt ist. Es veranschaulicht den Vergleich zwischen großen Sprachmodellen und einem Papagei: Wie dieser wiederholen diese Tools Sätze, ohne sie wirklich zu verstehen, daher ihr Spitzname "stochastische Papageien".
Quelle: astronoo.com (neues Fenster)
Was sind "stochastische Papageien" und warum gefährdet ihre Vermehrung die Qualität von Online-Informationen?
Der Begriff "stochastischer Papagei" bezieht sich auf große Sprachmodelle (LLMs), die zwar flüssige Sprache produzieren, sie aber nicht "verstehen": Sie reproduzieren statistische Muster aus massiven Daten, ohne Bewusstsein oder Intentionalität. Ihre probabilistische Funktionsweise erzeugt massenhaft hohle Inhalte, die das Web sättigen, in einem Phänomen namens "Verschlimmbesserung" (enshittification): mehr Inhalt, weniger Qualität, eine sich selbst verstärkende Schleife, in der die Menge das Signal erstickt. Diese kognitive Blase ist von einer Implosion bedroht, weil Modelle mit zunehmend durch ihre eigenen Ausgaben verunreinigten Daten trainiert werden, was die Zuverlässigkeit von Suchmaschinen beeinträchtigt und wissenschaftliche Quellen kontaminiert. Der menschliche Rohstoff ist lebenswichtig, und ohne ihn können sich KIs nicht mehr verbessern.
Die stochastischen Papageien
Der Begriff "stochastischer Papagei" wurde von den Forscherinnen Emily Bender (1973-) und Timnit Gebru (1982-) geprägt, um zu betonen, dass LLMs (Large Language Models) die von ihnen verwendete Sprache nicht "verstehen". Sie reproduzieren Muster, die aus massiven Daten gelernt wurden, ohne Bewusstsein oder Intentionalität. Wenn ein Papagei ein Wort wie "Hallo" nachahmt, hat er nicht die Absicht, jemanden zu grüßen. Es ist ein automatisches Verhalten, das durch externe Reize (z. B. die Anwesenheit von Menschen) oder interne Reize (z. B. Langeweile) ausgelöst wird.
Bei KI bezieht sich das Attribut "stochastisch" auf ihre probabilistische Funktionsweise: Jedes Wort wird auf der Grundlage statistischer Berechnungen generiert, wie ein Papagei, der zufällig gelernte Sätze wiederholt, ohne deren Bedeutung zu erfassen.
Die Lehrlinge der Sprache: Medienhype und Implosion
Ein gefährlicher Rückkopplungskreislauf hat sich im Internet etabliert: Je mehr Aufrufe ein Inhalt generiert, desto mehr Einnahmen oder Bekanntheit bringt er, und desto mehr wird zur Produktion von noch mehr inhaltsleerem Content angeregt. Menschen, die klüger sind als Maschinen, haben diese Dynamik schnell verstanden. Sie erkannten, dass sie KI nutzen können, um die Produktion von Online-Inhalten (Texte, Bilder, Videos) zu automatisieren.
Der Motor dieses Kreislaufs ist einfach, aber mächtig
Jeder neue, von KI generierte Inhalt zieht etwas Aufmerksamkeit auf sich, was zur Produktion von immer mehr Inhalten anregt. Mit der Zeit steigt die Gesamtmenge der Inhalte exponentiell an, aber die durchschnittliche Qualität bricht zusammen. Die Feeds sind mit künstlichen Inhalten überflutet, echte Informationen gehen im Rauschen unter, und das Vertrauen der Öffentlichkeit sinkt.
Die Verschlechterung des Internets: Ein Neues Kritisches Konzept der Digitalen Kultur
Der Neologismus "Verschlechterung" (vom englischen "enshittification") ist ein kritischer und soziologischer Begriff, der einen Prozess der schrittweisen Verschlechterung der Qualität von Online-Inhalten zugunsten von Quantität, Sichtbarkeit und sofortigem Profit beschreibt. Verschlechterung bezieht sich auf die massive Flutung des Internets mit minderwertigen, hohlen oder sogar irreführenden Inhalten, die automatisch oder opportunistisch erzeugt werden, um Traffic, Klicks oder Werbeeinnahmen zu generieren.
Verschlechterung: Ein Positiver Rückkopplungskreislauf
Je mehr Klicks minderwertige Inhalte generieren, desto mehr werden sie von Werbetreibenden nachgefragt, was die Nutzer dazu anregt, noch mehr davon zu produzieren. Das System nährt sich selbst, bis es zur Sättigung oder zum Zusammenbruch des globalen Vertrauens kommt. Wenn alle gleichzeitig sprechen, um gesehen zu werden, hört niemand mehr zu, und das Wissen löst sich im digitalen Lärm auf.
Wenn die Blase platzt, wird es nicht nur ein wirtschaftlicher oder medialer Crash sein, sondern ein Zusammenbruch des globalen Informationswerts mit tiefgreifenden Folgen für Plattformen, Schöpfer und das Publikum. Ergebnis: Alle werden verlieren.
Warum das System am Rande der Implosion steht
Wenn der Lärm das Signal erstickt
Das Internet verwandelt sich allmählich in eine riesige Informationsmülldeponie, in der der Lärm das Signal überlagert. Qualität und Wahrheit verschwinden angesichts der Massenproduktion und des Wettbewerbs um Aufmerksamkeit.
Die Abwertung digitaler Inhalte
Digitale Plattformen (Amazon, Spotify, YouTube, TikTok usw.) fördern systematisch KI-generierte "fesselnde" Inhalte wegen ihres Potenzials für Massenpublikum und Werbeeinnahmen. Doch diese Strategie offenbart ein zerstörerisches Paradox: Je mehr Algorithmen diese Produkte begünstigen, desto mehr entwerten sie das gesamte Ökosystem und schaffen eine Informationsblase, in der Quantität die Qualität erstickt. Je mehr KI-Inhalte es gibt, desto weniger ist jeder einzelne wert.
Ein Unhaltbares Technologisches Wettrüsten
Das Wettrüsten um immer leistungsfähigere Modelle erfordert kolossale Ressourcen, die für die meisten Akteure unerschwinglich geworden sind. Investoren riskieren, dass die Renditen auf Investitionen ausbleiben.
Die Sättigung des Systems
Die Sättigung ist bereits erreicht. Google ist das sichtbarste Beispiel: Seine Suchergebnisse, einst nach Relevanz und Zuverlässigkeit der Quellen geordnet, sind nun mit SEO-optimierten, aber wertlosen Inhalten überflutet. Automatisch erstellte Seiten von Online-Content-Farmen oder Sprachmodellen fluten die Suchmaschinenindizes und machen die Suche nach zuverlässigen Informationen zunehmend mühsam. Die Algorithmen der Suchmaschinen haben Mühe, Relevantes von Irrelevantem zu trennen und verstärken unwissentlich diesen digitalen Lärm. Relevanz wird durch Viralität ersetzt, und Wissen löst sich in einer Masse künstlich hohler Inhalte auf. Suchmaschinen, einst Symbole für den Zugang zu Wissen, werden zu einer digitalen Mülldeponie, in der Nutzer Signal und Rauschen nicht mehr unterscheiden können.
Menschliche Rohstoffe sind lebenswichtig
Ohne Rohstoffe (menschliche Werke) können KI-Systeme nicht mehr verbessert werden. Man kann KI nicht weiter mit ihrer tausendfach verdauten eigenen Nahrung füttern.
Lesen Sie den Artikel über: Was ist "Self-Consuming Generative Models Go Mad"? (neues Fenster)
Beispiele für die Produktion viraler Inhalte
| Inhaltstyp | Beispiel | Plattform / Mechanismus | Problem |
|---|---|---|---|
| Automatisierte Bücher | - Romane oder Anleitungen, die von KI generiert und mit Wiederholungen oder trivialen Informationen gefüllt sind - Umverpackte Fälschungen bestehender Bücher | Amazon Kindle Direct Publishing, Lulu, Apple Books, Kobo Writing Life, Google Play Books, JD.com, Dangdang, WeChat Reading | Enorme Menge an hohlen, absurden oder unlesbaren Veröffentlichungen, die automatisch von Software erstellt werden, ohne menschliche Überprüfung oder Autor. |
| Blog-Artikel oder Nachrichten | - Naive Artikel, die automatisch generiert werden, um die Zielgruppe zu optimieren | Google Search / Adsense, Facebook Instant Articles, Apple News, LinkedIn, Medium, WeChat Official Accounts, Toutiao, Baidu Baijia, Weibo | Verschlechterung der Informationsqualität. Vervielfachung oberflächlicher Inhalte, um Traffic zu generieren. Die Hälfte der von KI generierten Nachrichtenseiten enthält falsche Informationen. |
| Bilder | - Stereotype Illustrationen in sozialen Medien, um Klicks zu generieren | ArtStation, Shutterstock, Canva, Getty Images, Adobe Stock, Weibo, Xiaohongshu, Douyin, Baidu Tieba | Sättigung der Bilddatenbanken ohne ursprünglichen Wert. Abnahme der menschlichen Kreativität. Deepfakes sind für 70 % der Internetnutzer nicht erkennbar. |
| Videos | - Kurze, reißerische Clips - Automatisch generierte Animationen oder Deepfakes | YouTube, TikTok, Instagram, Facebook Reels, Douyin, Kuaishou, Bilibili, WeChat Channels | Leere Inhalte, die Aufmerksamkeit erregen sollen. Übertriebene oder irreführende Klickköder. Erhöhte Exposition gegenüber Fehlinformationen. Monetarisierung über Werbung. |
| Musik | - Komplette Playlists von KI-generierten Titeln - Kataloge, die mit synthetischen Kreationen gefüllt sind | Spotify, SoundCloud, Apple Music, YouTube Music, QQ Music, NetEase Cloud Music, Kugou, Kuwo | Bezahlung für Werke ohne echte Kreativität. Sättigung des Musikmarktes. Virtuelle Künstler generieren Millionen von Streams. |
| Virale Aufhänger-Inhalte | - Massenhaft generierte humorvolle Bilder und Texte - Maximierung von Likes durch Fake-Accounts | Facebook, Instagram, Reddit, X (Twitter), WeChat Moments, Douyin, Weibo, Xiaohongshu | Massenproduktion, um Aufmerksamkeit zu generieren. Verwässerung des Originalinhalts. Leicht von anderen Nutzern kopierbar und anpassbar. |
| Produktdesign und 3D-Modelle | - Massenhaft generierte Designs für Objekte, Möbel, Schmuck | Etsy, Thingiverse, Cults3D, MyMiniFactory, Taobao, Tmall, JD.com, 1688.com | Überschwemmung des Marktes mit nicht funktionalen Designs. Abwertung der Arbeit von Designern. |
| Tutorials | - Attraktive, aber fehlerhafte, automatisch generierte Tutorials | Stack Overflow, Quora, Reddit, YouTube, Zhihu, Baidu Zhidao, Bilibili, CSDN | Verschmutzung der Wissensdatenbanken. Großflächige Verbreitung von Fehlern. Verlust des Vertrauens in Informationsquellen. |
| Anwendungen und Code | - Grundlegende Anwendungen - Kopierte, anfällige Skripte - Zweifelhafte Open-Source-Pakete | GitHub, GitLab, App Store, Google Play Store, Gitee, Coding.net, Chinesische App-Stores (Huawei, Xiaomi, Tencent) | Erhöhte Sicherheitsrisiken. Verbreitung von nicht optimiertem oder bösartigem Code. |
Die Kontamination wissenschaftlicher Quellen hat bereits begonnen
In der Forschung deuten mehrere Anzeichen auf eine schrittweise Kontamination des wissenschaftlichen Korpus durch synthetische oder automatisierte Inhalte hin, was die Zuverlässigkeit der Quellen und die Referenzkette beeinträchtigen kann.
Vermehrung der "Paper Mills"
Artikelfabriken produzieren Tausende von pseudowissenschaftlichen Veröffentlichungen, die von KI generiert oder umformuliert werden, manchmal sogar in Zeitschriften akzeptiert. Ihr Inhalt ist oft ohne echte Experimente, aber optimiert, um "wissenschaftlich" zu wirken (oberflächlicher Formalismus, erfundene Zitate, vage Methodiken).
Wiederverwendung synthetischer Artikel
Gestresste oder unzureichend ausgebildete Forscher übernehmen von KI generierte Formulierungen (Einleitungen, Zusammenfassungen, Literaturübersichten) und fügen sie in ihre Arbeiten ein. Dies führt zu subtilen semantischen Fehlern und unentdeckten Ungenauigkeiten, die manchmal den Prüfungsfilter passieren und sich dann in der Literatur verbreiten.
Kontamination bibliografischer Datenbanken
Plattformen wie Google Scholar, ResearchGate oder Semantic Scholar indexieren nun automatisch generierte Papiere. Diese Texte verunreinigen die Empfehlungsalgorithmen und akademischen Suchmaschinen, verfälschen die Relevanzmetriken und erhöhen das Risiko unbegründeter Zitate.
Verlust der Rückverfolgbarkeit von Quellen
Wenn eine KI einen Auszug aus mehreren Papieren umformuliert, ohne die Autoren korrekt zu zitieren, wird die Referenzkette unterbrochen. Der Leser glaubt, eine zuverlässige Zusammenfassung zu lesen, dabei handelt es sich um eine Mischung undifferenzierter Quellen, was der wissenschaftlichen Transparenz schadet und die Überprüfung von Fakten erschwert.
FAQ: Alles über stochastische Papageien
Was ist ein "stochastischer Papagei" und warum ist diese Metapher erhellend?
Die Metapher des "stochastischen Papageien", populär gemacht von Emily Bender und Timnit Gebru, bezieht sich auf große Sprachmodelle, die menschliche Sprache nachahmen, ohne sie zu verstehen. Wie ein Papagei, der "Hallo" wiederholt, ohne zu grüßen, generieren LLMs Wörter basierend auf probabilistischen statistischen Berechnungen über Milliarden von Texten, ohne Bewusstsein, Bedeutung oder Intentionalität. Ihre Funktionsweise ist "stochastisch" (zufällig und probabilistisch): Jedes Wort wird aus einer Wahrscheinlichkeitsverteilung gewählt, was flüssige Sprache ohne echtes Verständnis erzeugt.
Was ist die "Verschlimmbesserung" (enshittification) des Internets und wie verstärkt sie sich selbst?
Die "Verschlimmbesserung" (enshittification) ist ein Phänomen der fortschreitenden Verschlechterung der Online-Inhaltsqualität zugunsten von Quantität, Sichtbarkeit und sofortigem Gewinn. Das Web füllt sich mit mittelmäßigen, hohlen oder irreführenden Inhalten, die massenhaft von KIs oder Content-Farmen produziert werden, um Traffic und Werbeeinnahmen zu generieren. Dieser Prozess verstärkt sich durch eine positive Rückkopplungsschleife: Je mehr mittelmäßiger Inhalt Klicks generiert, desto mehr wird er von Werbetreibenden nachgefragt, was zu noch mehr Produktion anregt. Ergebnis: Suchmaschinen sind mit SEO-optimiertem, aber wertlosem Inhalt gesättigt, Feeds sind mit digitalem Rauschen überflutet und das Vertrauen der Öffentlichkeit bricht zusammen. Relevanz wird durch Viralität ersetzt.
Warum sind wissenschaftliche Quellen durch die Vermehrung stochastischer Papageien bedroht?
Wissenschaftliche Quellen werden durch mehrere Phänomene im Zusammenhang mit stochastischen Papageien kontaminiert. "Paper Mills" produzieren Tausende von pseudowissenschaftlichen Publikationen, die von KI generiert oder umformuliert werden, ohne echte Experimente, aber optimiert, um "wissenschaftlich" zu wirken. Überforderte Forscher verwenden KI-generierte Formulierungen und führen subtilie semantische Fehler ein, die sich dann verbreiten. Plattformen wie Google Scholar indexieren diese automatisch generierten Papiere und verunreinigen so Empfehlungsalgorithmen. Schließlich wird die Referenzkette unterbrochen, wenn eine KI Auszüge umformuliert, ohne Quellen korrekt zu zitieren, was die Faktenüberprüfung erschwert.
 Agentische KI: Wenn Maschinen autonom werden
 Was KI nicht kann
 Künstliche Intelligenz und Astronomie: Die Rolle der KI-Assistenten verstehen
 KI-Tools: Wie wählt man aus?
 Generative KI vs AGI: Wo endet Nachahmung, wo beginnt Bewusstsein?
 Künstliche Netzwerke vs. biologische Netzwerke: Zwei Systeme, eine gemeinsame Architektur
 Menschliches Gehirn und künstliche Intelligenzen: Ähnlichkeiten und Unterschiede
 AlphaGo gegen AlphaGo Zero: Eine Revolution der künstlichen Intelligenz
 Der nächste Schritt intelligenter Maschinen
 Der erste Schritt zur Entstehung des Lebens
 Vom biologischen Neuron zum formalen Neuron: Vereinfachung des Gehirns
 Künstliche Intelligenz: Die Explosion des Gigantismus
 Wenn künstliche Intelligenz verrückt wird!
 Entstehung der künstlichen Intelligenz: Illusion oder echte Intelligenz?
 Wie Maschinen Sprache ähnlich wie Menschen verstehen, interpretieren und erzeugen
 Wie funktioniert ein künstliches neuronales Netzwerk?