

人工知能:ノイズの創造者と弾けようとしている認知バブル
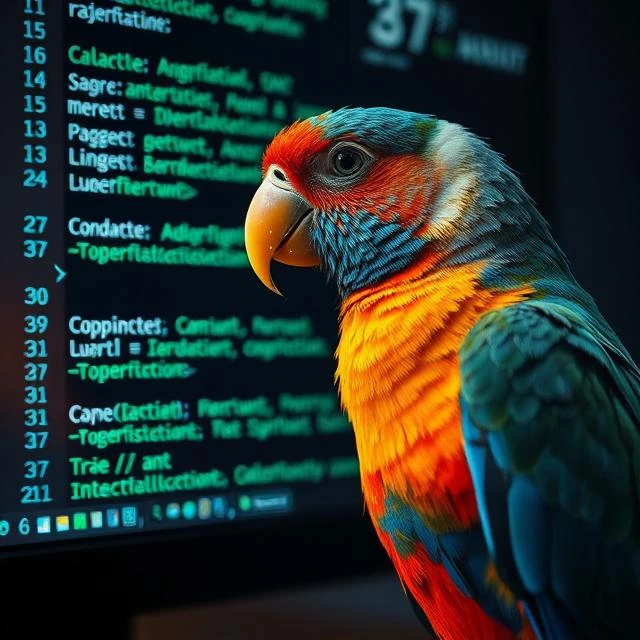
画像の説明: この画像は、ランダムに組み合わされた単語で満たされた画面の前のオウムを示しています。これは、大規模言語モデルとオウムの比較を示しています:オウムと同様に、これらのツールはフレーズを繰り返しますが、本当の意味を理解していないため、「確率論的オウム」というニックネームが付けられています。
出典:astronoo.com (新しいウィンドウ)
「確率的オウム」とは何か、そしてその繁殖はなぜオンライン情報の品質を脅かすのか?
「確率的オウム」という用語は、流暢な言語を生成する一方でそれを「理解」していない大規模言語モデルを指します。彼らは大量のデータから学習した統計的パターンを、意識や意図なしに再現します。その確率的な機能は、ウェブを飽和させる大量の空虚なコンテンツを生成し、これは「エンシッティフィケーション」と呼ばれる現象です。この認知的バブルは、モデルが自身の出力でますます汚染されたデータで訓練されることにより崩壊の危機に瀕しており、検索エンジンの信頼性を損ない、科学的ソースを汚染しています。人間の生データは不可欠であり、それがなければAIは改善できなくなります。
確率論的オウム
「確率論的オウム」という用語は、研究者のエミリー・ベンダー(1973年生)とティムニット・ゲブル(1982年生)によって普及しました。これは、LLM(大規模言語モデル)が使用する言語を「理解」していないことを強調するためです。 LLMは、膨大なデータから学習したパターンを再現しますが、意識や意図はありません。 オウムが「こんにちは」という単語を真似しても、誰かを挨拶する意図はありません。これは、外部の刺激(例えば人間の存在)や内部の刺激(例えば退屈)によって引き起こされる自動的な行動です。
AIに関して、「確率論的」という形容詞は、確率的な動作を指します:各単語は統計的な計算に基づいて生成され、オウムが意味を理解せずに学習したフレーズをランダムに繰り返すようなものです。
言語の見習い魔術師:メディアの過熱と内部崩壊
インターネット上には危険なフィードバックループが形成されています:コンテンツが多くのビューを集めるほど、収益や知名度が増し、さらに多くの中身のないコンテンツを生産するよう促します。 人間は機械よりも賢いため、このダイナミクスをすぐに理解しました。 人間は、AIを使用してオンラインコンテンツ(テキスト、画像、動画)の生産を自動化できることに気づきました。
このループのエンジンはシンプルだが強力
新しいAI生成コンテンツは少しずつ注意を引き、さらに多くのコンテンツを生産するよう促します。 時間の経過とともに、コンテンツの総量は指数関数的に増加しますが、平均的な品質は低下します。 フィードは人工的なコンテンツで飽和し、本当の情報はノイズに埋もれ、公衆の信頼は低下します。
インターネットの劣化:デジタル文化の新しい批判的概念
「劣化」(英語の「enshittification」から)は、オンラインコンテンツの品質が量、可視性、即時利益を優先することで徐々に低下するプロセスを批判的・社会学的に表現するための新語です。 劣化とは、トラフィック、クリック、広告収入を生み出すために、自動的または機会主義的に生成された、平凡で空虚、時には誤解を招くコンテンツでインターネットを埋め尽くすことを指します。
劣化:正のフィードバックループ
低品質なコンテンツがクリックを集めるほど、広告主からの需要が高まり、ユーザーはさらに多くのコンテンツを生産するよう促されます。 システムは自己増殖し、飽和または全体的な信頼の崩壊に至ります。 全員が同時に見られるために話すとき、誰も聞かず、知識はデジタルノイズの中に溶け込みます。
バブルが弾けるとき、それは単なる経済的またはメディア的なクラッシュではなく、グローバルな情報価値の崩壊であり、プラットフォーム、クリエイター、公衆に深刻な影響を与えます。 結果:全員が損をする。
なぜシステムは崩壊の瀬戸際にあるのか
ノイズが信号をかき消すとき
インターネットは徐々に、情報のゴミ捨て場へと変貌しています。ノイズが信号を圧倒し、品質と真実性は大量生産と視聴者獲得競争の前に消え去ります。
デジタルコンテンツの価値低下
デジタルプラットフォーム(Amazon、Spotify、YouTube、TikTokなど)は、AIによって生成された「魅力的な」コンテンツを、その大規模な視聴者獲得と広告収益の可能性のために、体系的に推進しています。 しかし、この戦略は破壊的なパラドックスを明らかにします:アルゴリズムがこれらのコンテンツを優先するほど、エコシステム全体の価値を低下させ、情報バブルを作り出します。そのバブルでは、量が質を圧倒します。 AIコンテンツが増えるほど、各コンテンツの価値は低下します。
持続不可能な技術競争
より強力なモデルを求める競争は、膨大なリソースを必要とし、ほとんどのプレーヤーにとって手の届かないものになっています。 投資家は、投資収益率が期待通りにならないリスクに直面しています。
システムの飽和
飽和はすでに達成されています。 Googleが最も顕著な例です:かつては関連性と情報源の信頼性によってランク付けされていた検索結果は、SEO最適化されたが価値のないコンテンツで飽和しています。 オンラインコンテンツファームや言語モデルによって自動的に生成されたページが検索エンジンのインデックスを埋め尽くし、信頼できる情報の検索をますます困難にしています。 検索エンジンのアルゴリズムは、関連性のあるものとそうでないものを区別するのに苦労し、無意識のうちにこのデジタルノイズを増幅させています。 関連性はウイルス性に置き換えられ、知識は人工的に空虚なコンテンツの山の中に溶け込みます。 検索エンジンはかつて知識へのアクセスの象徴でしたが、今やデジタルゴミ捨て場となり、ユーザーは信号とノイズを区別できなくなっています。
人間の原料が不可欠
原料(人間の作品)がなければ、AIは改善できなくなります。 AIに何度も消化された自分の食べ物を与え続けることはできません。
記事を読む: 「Self-Consuming Generative Models Go Mad」とは? (新しいウィンドウ)
ウイルス性コンテンツ生産の例
| コンテンツの種類 | 例 | プラットフォーム / メカニズム | 問題 |
|---|---|---|---|
| 自動化された書籍 | - AIによって生成された小説やガイド、繰り返しや些細な情報で満たされている - 既存の書籍の偽造品を再包装したもの | Amazon Kindle Direct Publishing, Lulu, Apple Books, Kobo Writing Life, Google Play Books, JD.com, Dangdang, WeChat Reading | ソフトウェアによって自動的に生成された、中身のない、ばかげた、または読めない出版物の膨大な量。人間によるレビューや著者はいない。 |
| ブログ記事やニュース | - 視聴者を最適化するために自動生成された素朴な記事 | Google Search / Adsense, Facebook Instant Articles, Apple News, LinkedIn, Medium, WeChat Official Accounts, Toutiao, Baidu Baijia, Weibo | 情報の品質低下。 トラフィックを獲得するための浅いコンテンツの増加。 AIによって生成されたニュースサイトの半分には、誤った情報が含まれている。 |
| 画像 | - クリックを誘うためのステレオタイプなイラスト | ArtStation, Shutterstock, Canva, Getty Images, Adobe Stock, Weibo, Xiaohongshu, Douyin, Baidu Tieba | 元の価値のない画像バンクの飽和。 人間の創造性の低下。 ディープフェイクは、インターネットユーザーの70%に検出不可能。 |
| 動画 | - センセーショナルな短いクリップ - 自動生成されたアニメーションやディープフェイク | YouTube, TikTok, Instagram, Facebook Reels, Douyin, Kuaishou, Bilibili, WeChat Channels | 注目を集めるために設計された空虚なコンテンツ。 大げさまたは誤解を招くクリックベイト。 誤情報への曝露の増加。 広告による収益化。 |
| 音楽 | - AIによって生成されたトラックの完全なプレイリスト - 合成作品で満たされたカタログ | Spotify, SoundCloud, Apple Music, YouTube Music, QQ Music, NetEase Cloud Music, Kugou, Kuwo | 真の創造性のない作品への報酬。 音楽市場の飽和。 バーチャルアーティストが何百万ものストリームを生成。 |
| ウイルス性のある魅力的なコンテンツ | - 大量に生成されたユーモラスな画像やテキスト - 偽アカウントによる「いいね!」の最大化 | Facebook, Instagram, Reddit, X (Twitter), WeChat Moments, Douyin, Weibo, Xiaohongshu | 注目を集めるための大量生産。 元のコンテンツの希薄化。 他のユーザーによって簡単にコピーおよび適応可能。 |
| 製品デザインと3Dモデル | - 大量に生成されたオブジェクト、家具、宝石のデザイン | Etsy, Thingiverse, Cults3D, MyMiniFactory, Taobao, Tmall, JD.com, 1688.com | 機能しないデザインで市場が氾濫。 デザイナーの仕事の価値低下。 |
| チュートリアル | - 自動生成された魅力的だが誤ったチュートリアル | Stack Overflow, Quora, Reddit, YouTube, Zhihu, Baidu Zhidao, Bilibili, CSDN | ナレッジベースの汚染。 大規模なエラーの拡散。 情報源への信頼喪失。 |
| アプリケーションとコード | - 基本的なアプリケーション - コピー&ペーストされた脆弱なスクリプト - 疑わしいオープンソースパッケージ | GitHub, GitLab, App Store, Google Play Store, Gitee, Coding.net, 中国のアプリストア(Huawei, Xiaomi, Tencent) | セキュリティリスクの増加。 最適化されていない、または悪意のあるコードの増殖。 |
科学的情報源の汚染はすでに始まっている
研究の分野では、合成または自動化されたコンテンツによる科学的コーパスの徐々に進行する汚染の兆候がいくつかあり、情報源の信頼性と参照チェーンを損なう可能性があります。
「ペーパーミル」の増加
論文工場は、AIによって生成または言い換えられた数千の擬似科学的出版物を生産し、時にはジャーナルに受け入れられることもあります。 それらのコンテンツは、実際の実験を伴わないことが多いですが、「科学的」に見えるように最適化されています(表面的な形式主義、でっち上げの引用、曖昧な方法論)。
合成論文の再利用
時間に追われたり、十分な訓練を受けていない研究者は、AIによって生成された定式化(導入、要約、文献レビュー)を自分の研究に挿入します。 これにより、微妙な意味的エラーや検出されない近似が導入され、レビューフィルターを通過し、その後文献に広がることがあります。
書誌データベースの汚染
Google Scholar、ResearchGate、Semantic Scholarなどのプラットフォームは、現在、自動生成された論文をインデックス化しています。 これらのテキストは、推奨アルゴリズムや学術検索エンジンを汚染し、関連性の指標を歪め、根拠のない引用のリスクを高めます。
情報源の追跡可能性の喪失
AIが複数の論文から抜粋を言い換え、著者を適切に引用しない場合、参照チェーンが破られます。 読者は信頼できる要約を読んでいると思いますが、実際には区別のつかない情報源の混合物であり、科学的透明性を損ない、事実確認を複雑にします。
FAQ:確率的オウムに関するすべて
「確率的オウム」とは何か、このメタファーはなぜ示唆に富むのか?
「確率的オウム」というメタファーは、人間の言語を理解せずに模倣する大規模言語モデルを指します。挨拶する意図なく「こんにちは」と繰り返すオウムのように、LLMは数十億のテキストに対する確率的な統計計算に基づいて単語を生成し、意識、意味、意図性を持ちません。その機能は「確率的」であり、各単語は確率分布から選択され、現実の理解を欠いた流暢な言語を生成します。
インターネットの「エンシッティフィケーション」とは何か、それはどのように自己強化されるのか?
「エンシッティフィケーション」は、量、可視性、即時的な利益を優先するオンラインコンテンツの品質の progressive degradation 現象です。ウェブは、トラフィックと広告収入を生み出すためにAIやコンテンツファームによって大量生産された、質の低い、空虚な、または誤解を招くコンテンツで満たされます。このプロセスは正のフィードバックループによって自己強化されます。質の低いコンテンツがクリックを生むほど、広告主に需要され、さらに多くの生産を促進します。結果として、検索エンジンはSEO最適化された無価値なコンテンツで飽和し、フィードはデジタルノイズで溢れ、公共の信頼は崩壊します。関連性はバイラル性に取って代わられます。
なぜ科学的ソースは確率的オウムの繁殖によって脅かされているのか?
科学的ソースは、確率的オウムに関連するいくつかの現象によって汚染されています。「ペーパーミル」は、実際の実験なしにAIによって生成または言い換えられた、何千もの疑似科学的出版物を生産しますが、「科学的」に見えるように最適化されています。急いでいる研究者はAI生成のフレージングを使用し、その後伝播する微妙な意味論的エラーを導入します。Google Scholarのようなプラットフォームはこれらの自動生成論文をインデックスし、レコメンデーションアルゴリズムを汚染します。最後に、AIがソースを適切に引用せずに抜粋を言い換えると、参照チェーンが切断され、ファクトチェックがより困難になります。
 エージェンティックAI:マシンが自律性を獲得するとき
 AIができないこと
 人工知能と天文学:AIアシスタントの役割を理解する
 AIツールの選び方
 生成AI vs AGI:模倣の終わり、意識の始まりはどこか?
 人工ネットワーク vs 生物学的ネットワーク:2つのシステム、共通のアーキテクチャ
 人間の脳と人工知能:類似点と相違点
 AlphaGo vs AlphaGo Zero:人工知能の革命
 知的機械の次のステップ
 生物学的ニューロンから形式ニューロンへ:脳の単純化
 人工知能:巨大化の爆発
 人工知能が狂ったとき!
 人工知能の誕生:知能の幻想か、本当の知能か?
 人工知能の課題と脅威
 機械は人間と同様に言語を理解し、解釈し、生成する方法
 人工ニューラルネットワークの仕組み