


O token: a unidade fundamental dos grandes modelos de linguagem
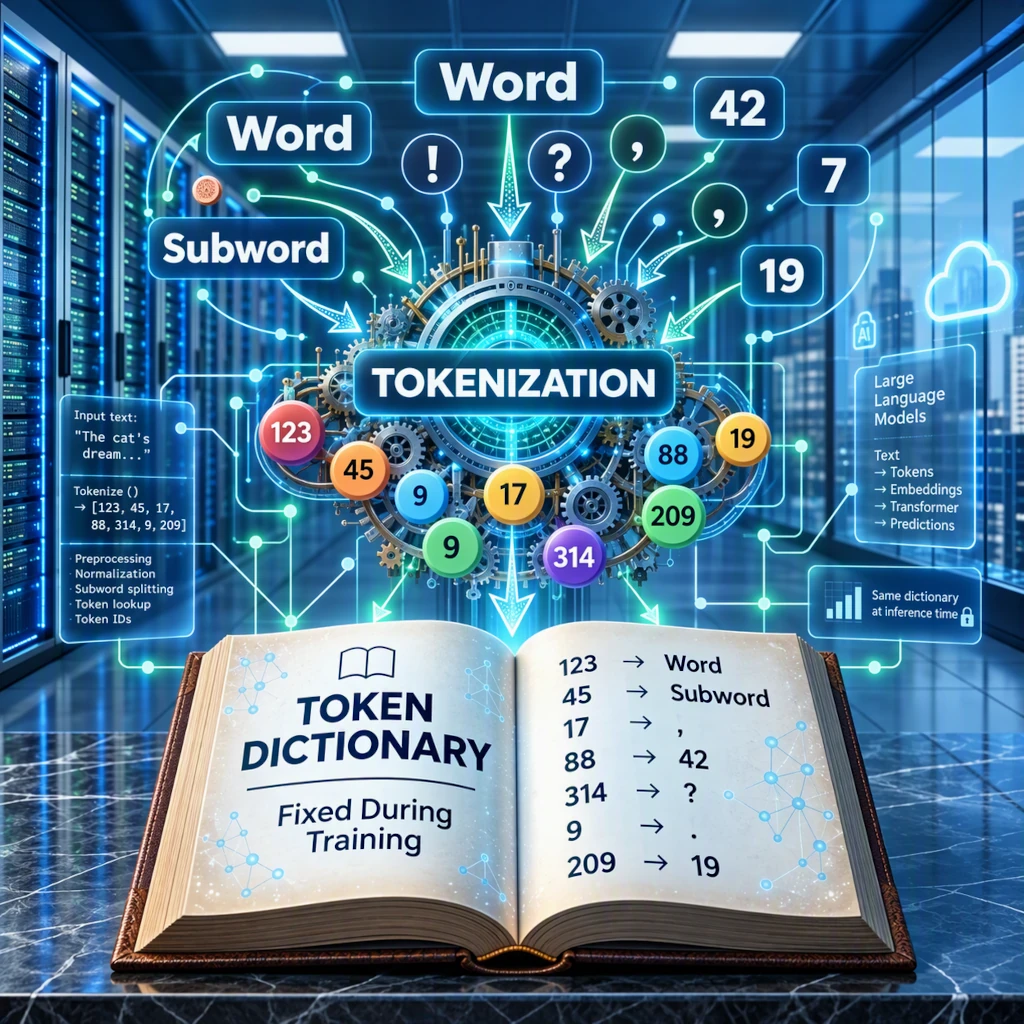
Ilustração do processo de tokenização na nuvem: transformação de palavras, partes de palavras e pontuações em tokens numéricos referenciados num dicionário de treino.
Fonte da imagem: astronoo.com (nova janela): imagem gerada por IA, domínio público.
Resumo científico
Este artigo descreve o token, a unidade elementar de texto manipulada por um grande modelo de linguagem (LLM). Antes de qualquer cálculo, o texto é dividido por um tokenizer em fragmentos (palavras inteiras, pedaços de palavras, pontuação, números), cada um associado a um número num dicionário fixado antes do treino. Este dicionário é construído a partir das frequências observadas num corpus muito grande, por exemplo por byte-pair encoding. O exemplo "Explique-moi la photosynthèse simplement." é dividido em 9 tokens pelo tokenizer Tekken da Mistral e em 13 pelo da Mistral 7B: a divisão depende do modelo. O artigo examina o que revela esta segmentação, o seu papel no comprimento do contexto, o custo de cálculo e os limites do modelo, e depois a passagem do número ao vetor através do embedding.
O que é um token, e por que uma IA não lê palavras?
Um fragmento de texto transformado em número
Um token é um fragmento de texto: uma palavra inteira, uma parte de palavra, um sinal de pontuação ou um número. Um LLM nunca recebe letras nem palavras, mas uma sequência de números, cada um designando um token num dicionário de várias dezenas de milhares de entradas.
Com o tokenizer Tekken da Mistral, a frase "Explique-moi la photosynthèse simplement." torna-se 9 tokens: Expl | ique | -moi | _la | _photos | ynth | èse | _simplement | . (o símbolo _ representa um espaço, ligado ao token que se segue). A palavra rara "photosynthèse" é reconstruída a partir de três fragmentos, enquanto "simplement" forma um único token. O token é, portanto, a unidade de cálculo do modelo, e não a palavra.
Também para descobrir
Continue a sua exploração do Universo com estes temas:
O token: a unidade básica de um LLM
Um pedaço de texto, não uma palavra
Um LLM não lê nem letras nem palavras: lê tokens. Um token é um fragmento de texto, que pode ser uma palavra inteira, uma parte de palavra, um sinal de pontuação ou um número. Cada token corresponde a um número num dicionário fixado antes do treino. Tomemos como prompt a frase "Explique-moi la photosynthèse simplement."
| Tokenizer | Dicionário (tokens) | Tokens para a frase | Divisão de "photosynthèse" |
|---|---|---|---|
| Tekken (Mistral NeMo) | ≈ 131 000 | 9 | 3: _photos + ynth + èse |
| GPT-4o (o200k_base) | ≈ 200 000 | 9 | 3: _photos + ynth + èse |
| Grok (xAI) | não comunicado | 9 | 3: _photos + ynth + èse |
| DeepSeek V3 | ≈ 129 000 | 10 | 3: _photos + ynth + èse |
| Gemma 3 (Google) | ≈ 262 000 | 10 | 3: _photos + ynth + èse |
| GPT-4 (cl100k_base) | ≈ 100 000 | 11 | 4: _photos + ynth + è + se |
| Llama 3 e 3.1 (Meta) | ≈ 128 000 | 11 | 4: _photos + ynth + è + se |
| Qwen3 (Alibaba) | ≈ 152 000 | 11 | 4: _photos + ynth + è + se |
| Mistral 7B (SentencePiece) | 32 768 | 13 | 4: _photos + yn + th + èse |
O símbolo _ representa um espaço, ligado ao token que se segue. Os tamanhos de dicionário estão arredondados. Um dicionário grande tende a encurtar os textos, mas não é sistemático: o Gemma 3 (≈ 262 000 tokens) produz 10 tokens para esta frase, contra 9 do Tekken (≈ 131 000). A divisão depende também das línguas e do corpus utilizados para construir o dicionário.
O que revela a comparação
Os oito tokenizers da tabela leem a mesma frase, mas não a dividem da mesma maneira. Estas diferenças mostram o que é realmente um token.
- "photosynthèse" não tem entrada própria em nenhum dicionário: esta palavra rara é reconstruída a partir de três ou quatro fragmentos. Tekken, GPT-4o, DeepSeek e Gemma 3 cortam-na em três (
_photos,ynth,èse), enquanto GPT-4, Llama 3 e Qwen3 separam também a terminação emèese. - "simplement" forma um único token, incluindo o caráter de espaço, em todos os tokenizers exceto o da Mistral 7B. O seu dicionário, mais pequeno, corta-o em
_simpleement. - "Explique" é cortado em dois (
Expl,ique) por todos os tokenizers, embora se trate de um verbo comum: a divisão segue as estatísticas do corpus, não a gramática. - "-moi" recebe três tratamentos diferentes: um único token no Tekken e no GPT-4o,
-meoino DeepSeek, GPT-4, Llama 3 e Qwen3, ou ainda-emoino Gemma 3. A Mistral 7B divide-o em três tokens. O ponto final, por sua vez, forma sempre um token à parte. - O total varia de 9 a 13 tokens. O tamanho do dicionário não basta para o explicar: o Gemma 3, com o maior dicionário da tabela, produz 10 tokens contra 9 do Tekken.
Um token não é, portanto, uma unidade linguística estável: depende do dicionário de cada modelo. Apenas alguns pontos são constantes, como o espaço ligado à palavra que se segue, a pontuação isolada ou o corte de "Explique" em Expl e ique.
Por que dividir assim?
O dicionário é construído antes do treino por um método como o byte-pair encoding: parte-se dos caracteres e depois fundem-se repetidamente os pares mais frequentes do corpus. As sequências comuns tornam-se tokens inteiros, as sequências raras ficam em pedaços. É um compromisso: um dicionário grande encurta os textos mas sobrecarrega o modelo, um dicionário pequeno alonga as sequências a tratar.
O mesmo texto não é, portanto, dividido da mesma maneira de um modelo para outro. O tokenizer SentencePiece da Mistral 7B, cujo dicionário conta com cerca de 32 000 tokens, produz 13 tokens para a mesma frase em vez de 9. Na prática, a janela de contexto e a faturação dos serviços de IA medem-se em tokens, e as línguas menos presentes no corpus exigem muitas vezes mais para dizer o mesmo.
Do token ao número
O modelo recebe apenas a lista de números: 60 795, 2 508, 33 001, 1 427, 17 159, 20 602, 24 380, 37 507, 1 046. Estes números são simples endereços no dicionário e não têm qualquer sentido por si mesmos. É na etapa seguinte, o embedding, que cada um é substituído por um vetor de milhares de números aprendidos durante o treino. O modelo nunca "vê" portanto as letras de "photosynthèse", o que explica as suas dificuldades em contar as letras de uma palavra.
O embedding: do número ao vetor
Um número não tem sentido
Após a tokenização, o modelo dispõe de uma lista de números. Ora, o número 17 159, que designa o token _photos no nosso exemplo, não é mais do que um endereço no dicionário: não está mais próximo de 17 160 do que de 90 000. Para calcular, o modelo precisa de uma representação em que a proximidade reflita uma semelhança de uso. É o papel do embedding.
Uma tabela de vetores aprendidos
O embedding é uma imensa tabela que contém uma linha por token do dicionário. Cada linha é um vetor, isto é, uma lista de milhares de números. Para passar do número ao vetor, o modelo lê simplesmente a linha correspondente:
_photos (número 17 159) → [0,021 ; −0,134 ; 0,087 ; … ; 0,052]
Estes valores são fictícios e a lista real conta, por exemplo, com 4 096 números. Não são escritos por humanos: são coeficientes ajustados durante o treino, tal como os da atenção. Para um dicionário de 131 072 tokens e vetores de 4 096 números, esta tabela representa por si só cerca de 537 milhões de coeficientes.
Vetores que se aproximam segundo o uso
Ao longo do treino, os tokens empregados em contextos semelhantes recebem vetores vizinhos. O vetor de _simplement encontra-se assim mais próximo do de um advérbio comparável do que do de um nome próprio. Este espaço conta com milhares de dimensões: não se pode desenhar, mas podem medir-se nele distâncias e ângulos.
O vetor de um token é sempre o mesmo, qualquer que seja o seu ambiente. Um fragmento como ynth não tem sentido por si só: é a etapa seguinte, a atenção, que o põe em relação com _photos e èse para reconstituir "photosynthèse".
A ordem dos tokens
Como o mesmo token dá o mesmo vetor em toda a parte, é preciso indicar também a sua posição na frase, pois "o gato come o rato" não significa o mesmo que "o rato come o gato". Segundo os modelos, esta informação é adicionada aos vetores ou, mais frequentemente hoje em dia, aplicada sob a forma de rotação no interior das camadas de atenção.
O que recebe o modelo
Os 9 números do nosso exemplo tornam-se assim 9 vetores, isto é, uma tabela de 9 linhas e 4 096 colunas, ou seja, 36 864 números. É esta matriz, e já não o texto, que entra nos blocos Transformer.
| Classificação | Token | Número | Dim. 1 | Dim. 2 | Dim. 3 | Dim. 4 | … | Dim. 4 096 |
|---|---|---|---|---|---|---|---|---|
| 1 | Expl | 60 795 | 0,0130 | 0,0121 | −0,0297 | −0,0022 | … | 0,0085 |
| 2 | ique | 2 508 | 0,0064 | −0,0154 | −0,0113 | 0,0039 | … | −0,0185 |
| 3 | -moi | 33 001 | −0,0031 | −0,0255 | 0,0001 | −0,0199 | … | 0,0013 |
| 4 | _la | 1 427 | 0,0207 | 0,0212 | 0,0177 | −0,0262 | … | 0,0086 |
| 5 | _photos | 17 159 | −0,0090 | −0,0208 | 0,0028 | 0,0111 | … | 0,0343 |
| 6 | ynth | 20 602 | −0,0043 | 0,0203 | −0,0563 | −0,0060 | … | −0,0005 |
| 7 | èse | 24 380 | −0,0103 | 0,0161 | −0,0043 | 0,0160 | … | 0,0167 |
| 8 | _simplement | 37 507 | −0,0164 | −0,0030 | −0,0016 | −0,0035 | … | −0,0138 |
| 9 | . | 1 046 | −0,0134 | 0,0071 | −0,0151 | −0,0090 | … | 0,0133 |
Apenas 5 colunas de 4 096 são apresentadas, ou seja, 9 × 4 096 = 36 864 números no total. Estes valores são ilustrativos: têm a ordem de grandeza dos de um embedding real (números pequenos, positivos ou negativos, da ordem do centésimo), sem serem extraídos de um modelo preciso. Num modelo real, não estão limitados ao intervalo de −1 a 1.
Referências
- Wikipédia: Byte pair encoding (nova janela)
- Kudo, T. e Richardson, J.: "SentencePiece: A simple and language independent subword tokenizer and detokenizer for Neural Text Processing", EMNLP (System Demonstrations), 2018 (nova janela)
- Mistral AI: "Mistral NeMo", apresentação do tokenizer Tekken, 18 de julho de 2024 (nova janela)
FAQ: o token nos LLM
O que é um token?
Um token é a unidade de texto manipulada por um LLM: uma palavra frequente, um pedaço de palavra, um sinal de pontuação ou um número. Cada token corresponde a um número no dicionário do modelo.
Um token é uma palavra?
Não necessariamente. As palavras muito frequentes formam muitas vezes um único token, enquanto as palavras raras são divididas em fragmentos. No nosso exemplo, "photosynthèse" dá três tokens e "simplement" um. O espaço que precede uma palavra é geralmente incluído no token.
Quantos tokens são necessários para uma palavra ou uma página?
Isso depende da língua, do texto e do tokenizer. Em francês, contam-se frequentemente entre 1,3 e 2 tokens por palavra. A nossa frase de exemplo conta com 5 palavras para 9 tokens com o Tekken, e 13 com o tokenizer da Mistral 7B.
Quem decide a divisão em tokens?
O tokenizer, um componente distinto da rede de neurónios. O seu dicionário é construído antes do treino, por exemplo com o método do byte-pair encoding, que funde repetidamente os pares de caracteres mais frequentes do corpus. Depois permanece fixado.
Por que o mesmo texto não tem o mesmo número de tokens de um modelo para outro?
Porque cada modelo tem o seu próprio dicionário, de tamanho e conteúdo diferentes. Um dicionário maior encurta os textos, um mais pequeno alonga-os. Os números dos tokens não são, portanto, comparáveis de um modelo para outro.
Por que os serviços de IA contam em tokens?
Porque o token é a unidade de cálculo do modelo. A janela de contexto (a quantidade de texto que o modelo pode ler de uma só vez) e a faturação de muitos serviços medem-se em tokens, e o tempo de cálculo aumenta com o seu número.
Um token tem sentido?
Não por si mesmo. O seu número não é mais do que um endereço no dicionário. O sentido aparece na etapa seguinte, o embedding, que substitui cada número por um vetor de milhares de números aprendidos durante o treino, e depois nas camadas de atenção que ligam os tokens entre si.
Por que um LLM tem dificuldade em contar as letras de uma palavra?
Porque não "vê" as letras: manipula tokens. Não tem acesso às letras de "photosynthèse", apenas aos três fragmentos _photos, ynth e èse.
 O percurso do prompt à resposta: nos bastidores de um LLM
 O token: a unidade fundamental dos grandes modelos de linguagem
 Os diferentes tipos de aprendizagem das IA
 IA Agêntica: Quando as máquinas se tornam autônomas
 O que a IA não pode fazer
 Inteligência artificial e astronomia: Compreender o papel dos assistentes IA
 Ferramentas de IA: como escolher?

 IA Generativa vs AGI: Onde termina a imitação e onde começa a consciência?
 Redes artificiais vs. redes biológicas: Dois sistemas, uma arquitetura comum
 Cérebro Humano e Inteligências Artificiais: Semelhanças e Diferenças
 AlphaGo contra AlphaGo Zero: Uma Revolução na Inteligência Artificial
 O próximo passo das máquinas inteligentes
 Do Neurônio Biológico ao Neurônio Formal: Simplificação do Cérebro
 Inteligência artificial: a explosão do gigantismo
 Quando a inteligência artificial enlouquece!
 Como as máquinas se tornam inteligentes
 Inteligência artificial: ameaça real ou oportunidade para a humanidade?
 Como as máquinas entendem, interpretam e geram linguagem de maneira semelhante aos humanos?
 Como funciona uma rede neural artificial?