


Token:大型语言模型的基本单位
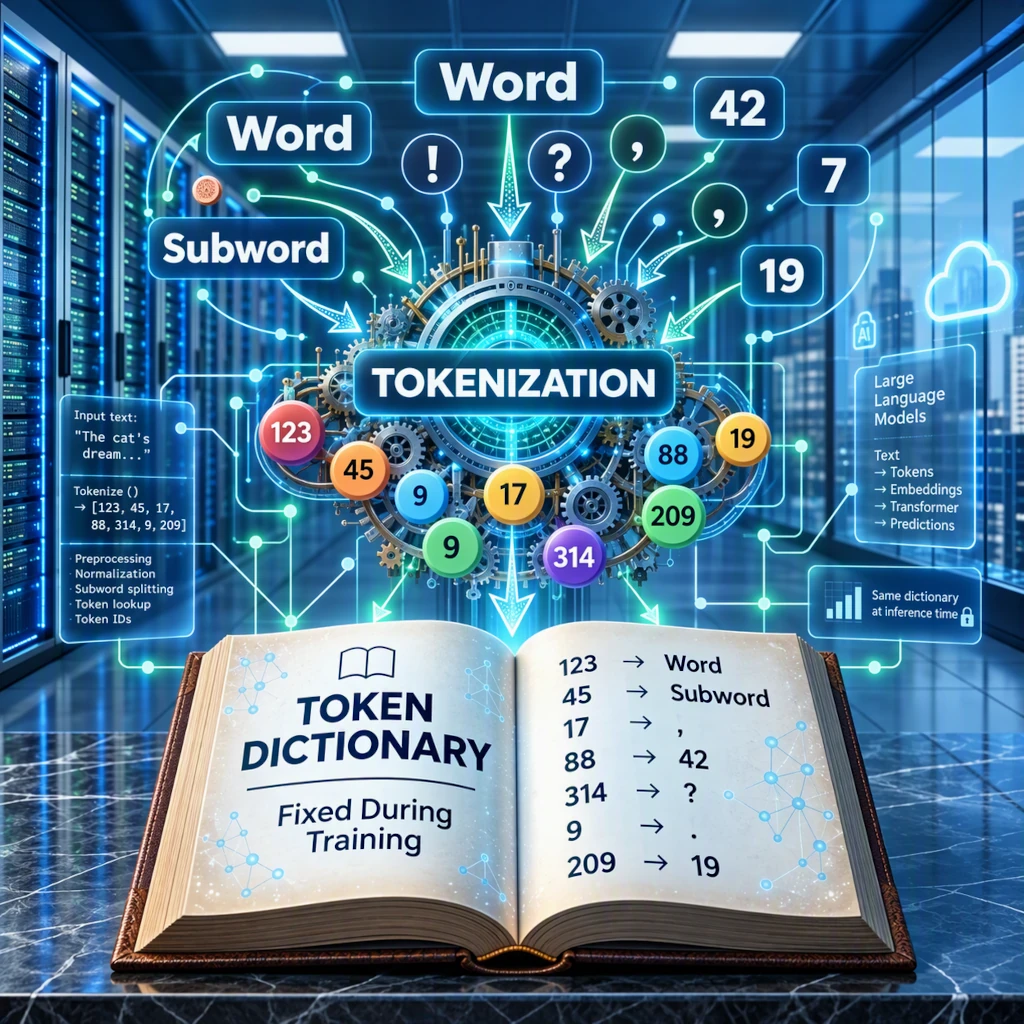
云端 token 化过程示意图:将单词、词的部分和标点转换为训练字典中引用的数字 token。
图片来源:astronoo.com(新窗口):AI 生成图像,公有领域。
科学摘要
本文介绍token,即大型语言模型(LLM)所操作文本的基本单位。在任何计算之前,文本由分词器切分为片段(完整单词、词的部分、标点、数字),每个片段对应训练前固定字典中的一个编号。该字典依据在超大型语料库中观察到的频率构建,例如通过字节对编码。示例"Explique-moi la photosynthèse simplement."被 Mistral 的 Tekken 分词器切分为 9 个 token,而被 Mistral 7B 的分词器切分为 13 个 token:切分取决于模型。本文考察这种切分所揭示的内容、它在上下文长度、计算成本以及模型局限中的作用,随后讨论通过嵌入从编号到向量的转变。
什么是 token,为什么 AI 不读单词?
转换为数字的文本片段
token 是文本的一个片段:一个完整单词、词的一部分、一个标点符号或一个数字。LLM 从不接收字母或单词,而是接收一串数字,每个数字在数万条目的字典中指定一个 token。
使用 Mistral 的 Tekken 分词器,句子"Explique-moi la photosynthèse simplement."变为 9 个 token:Expl | ique | -moi | _la | _photos | ynth | èse | _simplement | .(符号 _ 表示一个空格,附加在其后的 token 上)。罕见单词"photosynthèse"由三个片段重建,而"simplement"则构成单个 token。因此,token 是模型的计算单位,而非单词。
值得一看
继续探索宇宙的这些主题:
Token:LLM 的基本单位
文本的片段,而非单词
LLM既不读字母也不读单词:它读的是token。 token 是文本的一个片段,可以是完整单词、词的一部分、标点符号或数字。 每个 token 对应训练前固定字典中的一个编号。 让我们以句子"Explique-moi la photosynthèse simplement."作为提示。
| 分词器 | 字典(token) | 句子的 token 数 | "photosynthèse"的切分 |
|---|---|---|---|
| Tekken(Mistral NeMo) | ≈ 131,000 | 9 | 3:_photos + ynth + èse |
| GPT-4o(o200k_base) | ≈ 200,000 | 9 | 3:_photos + ynth + èse |
| Grok(xAI) | 未公布 | 9 | 3:_photos + ynth + èse |
| DeepSeek V3 | ≈ 129,000 | 10 | 3:_photos + ynth + èse |
| Gemma 3(Google) | ≈ 262,000 | 10 | 3:_photos + ynth + èse |
| GPT-4(cl100k_base) | ≈ 100,000 | 11 | 4:_photos + ynth + è + se |
| Llama 3 和 3.1(Meta) | ≈ 128,000 | 11 | 4:_photos + ynth + è + se |
| Qwen3(阿里巴巴) | ≈ 152,000 | 11 | 4:_photos + ynth + è + se |
| Mistral 7B(SentencePiece) | 32,768 | 13 | 4:_photos + yn + th + èse |
符号 _ 表示一个空格,附加在其后的 token 上。字典大小已四舍五入。大字典倾向于缩短文本,但并非总是如此:Gemma 3(≈ 262,000 个 token)对此句产生 10 个 token,而 Tekken(≈ 131,000)产生 9 个。切分还取决于构建字典所用的语言和语料库。
比较所揭示的内容
表中的八个分词器读取同一个句子,但切分方式不同。这些差异展示了 token 的真正含义。
- "photosynthèse"在任何字典中都没有自己的条目:这个罕见词由三或四个片段重建。Tekken、GPT-4o、DeepSeek 和 Gemma 3 将其切为三个(
_photos、ynth、èse),而 GPT-4、Llama 3 和 Qwen3 还将词尾分为è和se。 - "simplement"在除 Mistral 7B 之外的所有分词器中构成单个 token(包括空格字符)。Mistral 7B 的字典较小,将其切为
_simple和ment。 - "Explique"被所有分词器切为两个(
Expl、ique),尽管这是一个常用动词:切分遵循语料库的统计规律,而非语法。 - "-moi"受到三种不同处理:Tekken 和 GPT-4o 中为单个 token,DeepSeek、GPT-4、Llama 3 和 Qwen3 中为
-m和oi,Gemma 3 中为-和moi。Mistral 7B 将其切为三个 token。句末的句点则始终构成单独的 token。 - 总数在 9 到 13 个 token 之间变化。字典大小本身无法解释这一点:表中字典最大的 Gemma 3 产生 10 个 token,而 Tekken 为 9 个。
因此,token 不是稳定的语言单位:它取决于每个模型的字典。只有少数几个点是恒定的,如附加在后继单词上的空格、孤立的标点,或"Explique"被切为Expl和ique。
为什么要这样切分?
字典在训练前通过字节对编码等方法构建:从字符开始,然后反复合并语料库中最频繁的字符对。常见序列成为完整 token,罕见序列保持为片段。这是一种折衷:大字典缩短文本但加重模型负担,小字典加长待处理的序列。
因此,同一文本在不同模型中的切分方式不同。Mistral 7B 的 SentencePiece 分词器,其字典约含 32,000 个 token,对同一句子产生 13 个 token而非 9 个。实际上,上下文窗口和 AI 服务的计费以 token 计量,而语料库中出现较少的语言通常需要更多 token 来表达相同内容。
从 token 到数字
模型只接收数字列表:60,795、2,508、33,001、1,427、17,159、20,602、24,380、37,507、1,046。这些数字只是字典中的地址,本身没有任何含义。在下一步嵌入中,每个数字被替换为训练期间学到的数千个数字组成的向量。因此,模型从不"看到""photosynthèse"的字母,这解释了它难以数出单词字母数的原因。
嵌入:从数字到向量
数字没有意义
分词后,模型持有一个数字列表。然而,在我们示例中指定 token _photos 的数字 17,159 只是字典中的一个地址:它既不比 17,160 更近,也不比 90,000 更近。为了计算,模型需要一种接近性反映使用相似性的表示。这就是嵌入的作用。
学到的向量表
嵌入是一个巨大的表格,包含字典中每个 token 一行。每一行是一个向量,即数千个数字的列表。要从数字到向量,模型只需读取相应的行:
_photos(编号 17,159)→ [0.021 ; −0.134 ; 0.087 ; … ; 0.052]
这些值是虚构的,真实列表例如包含 4,096 个数字。它们不是人类编写的:它们是训练期间调整的系数,与注意力系数一样。对于含 131,072 个 token 的字典和 4,096 个数字的向量,此表本身就代表约 5.37 亿个系数。
随使用而靠近的向量
在训练过程中,用于相似上下文的 token 获得相邻的向量。_simplement的向量因此更接近可比副词而非专有名词的向量。这个空间有数千个维度:无法绘制,但可以测量距离和角度。
一个 token 的向量在其任何环境中总是相同的。ynth这样的片段本身没有意义:是下一步——注意力——将其与_photos和èse关联,以重建"photosynthèse"。
token 的顺序
由于相同的 token 在任何地方都给出相同的向量,还必须指示其在句中的位置,因为"猫吃老鼠"与"老鼠吃猫"含义不同。根据模型不同,这些信息或被添加到向量中,或(如今最常见)以旋转形式在注意力层内部应用。
模型接收的内容
我们示例中的 9 个数字因此变为 9 个向量,即 9 行 4,096 列的表,也就是 36,864 个数字。正是这个矩阵,而非文本,进入 Transformer 模块。
| 序号 | Token | 编号 | 维度 1 | 维度 2 | 维度 3 | 维度 4 | … | 维度 4,096 |
|---|---|---|---|---|---|---|---|---|
| 1 | Expl | 60,795 | 0.0130 | 0.0121 | −0.0297 | −0.0022 | … | 0.0085 |
| 2 | ique | 2,508 | 0.0064 | −0.0154 | −0.0113 | 0.0039 | … | −0.0185 |
| 3 | -moi | 33,001 | −0.0031 | −0.0255 | 0.0001 | −0.0199 | … | 0.0013 |
| 4 | _la | 1,427 | 0.0207 | 0.0212 | 0.0177 | −0.0262 | … | 0.0086 |
| 5 | _photos | 17,159 | −0.0090 | −0.0208 | 0.0028 | 0.0111 | … | 0.0343 |
| 6 | ynth | 20,602 | −0.0043 | 0.0203 | −0.0563 | −0.0060 | … | −0.0005 |
| 7 | èse | 24,380 | −0.0103 | 0.0161 | −0.0043 | 0.0160 | … | 0.0167 |
| 8 | _simplement | 37,507 | −0.0164 | −0.0030 | −0.0016 | −0.0035 | … | −0.0138 |
| 9 | . | 1,046 | −0.0134 | 0.0071 | −0.0151 | −0.0090 | … | 0.0133 |
4,096 列中仅显示了 5 列,即总共 9 × 4,096 = 36,864 个数字。这些值是示例性的:它们具有真实嵌入的数量级(小的正或负数,约为百分之一),但并非取自某个特定模型。在真实模型中,它们不限于 −1 到 1 的区间。
参考文献
FAQ:LLM 中的 token
什么是 token?
token 是 LLM 所操作文本的单位:频繁单词、词的一部分、标点符号或数字。每个 token 对应模型字典中的一个编号。
token 是一个单词吗?
不一定。非常频繁的单词通常构成单个 token,而罕见单词则被切分为片段。在我们的示例中,"photosynthèse"给出三个 token,"simplement"给出一个。单词前的空格通常包含在 token 中。
一个单词或一页需要多少 token?
这取决于语言、文本和分词器。在法语中,通常每词计算 1.3 到 2 个 token。我们的示例句在 Tekken 下为 5 词 9 token,在 Mistral 7B 的分词器下为 13 个 token。
谁决定 token 的切分?
分词器,一个独立于神经网络的组件。其字典在训练前构建,例如使用字节对编码方法,反复合并语料库中最频繁的字符对。此后保持固定。
为什么同一文本在不同模型中的 token 数不同?
因为每个模型都有自己的字典,大小和内容不同。较大的字典缩短文本,较小的字典加长文本。因此,token 编号在不同模型之间不可比较。
为什么 AI 服务以 token 计费?
因为 token 是模型的计算单位。上下文窗口(模型一次能读取的文本量)和许多服务的计费以 token 计量,计算时间随其数量增加而增长。
token 有意义吗?
本身没有意义。其编号只是字典中的一个地址。意义出现在下一步嵌入中,它将每个编号替换为训练期间学到的数千个数字组成的向量,随后出现在将 token 相互关联的注意力层中。
为什么 LLM 难以数出单词的字母数?
因为它不"看到"字母:它操作 token。它无法访问"photosynthèse"的字母,只能访问三个片段_photos、ynth和èse。
 从提示词到回答的旅程:LLM的幕后
 Token:大型语言模型的基本单位
 AI的不同学习类型
 自主人工智能:当机器变得自主
 AI做不到的事情
 人工智能与天文学:理解AI助手的角色
 AI工具:如何选择?

 生成式人工智能
vs 通用人工智能:模仿的终点与意识的起点在哪里?
 人工网络 vs 生物网络:两个系统,一种共同架构
 人脑与人工智能:相似与差异
 AlphaGo vs AlphaGo Zero:人工智能的一场革命
 智能机器的下一步
 生命涌现的第一步
 从生物神经元到形式神经元:大脑的简化
 人工智能:巨人主义的爆炸
 当AI模型用自己的数据训练时,它们会发疯!
 机器如何变得智能
 人工智能:人类的真正威胁还是机遇?
 机器如何以类似人类的方式理解、解释和生成语言?
 人工神经网络是如何工作的?