从提示词到回答的旅程:LLM的幕后
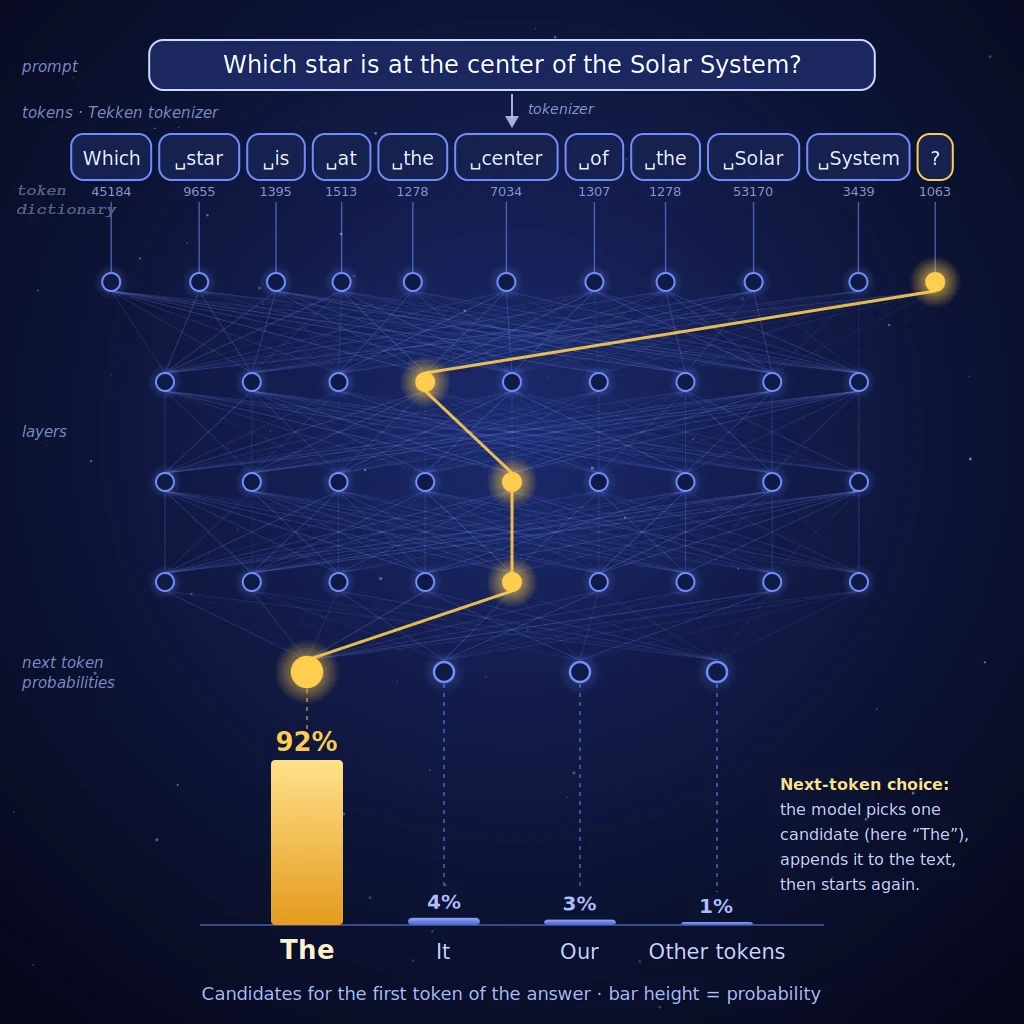
一幅艺术化的可视化图像:被切成词元的文本穿过人工神经网络的各层,展示了大语言模型(LLM)逐词生成回答的概率计算过程。
图片来源:astronoo.com(新窗口):AI生成图像,公有领域。
科学摘要
本文逐步描述了向对话式人工智能提出的问题,从用户的键盘到显示的回答之间的旅程。大语言模型(LLM)并不查询事实数据库:它使用训练过程中调整的数千亿个系数,逐词元计算下一个词的概率。两幅注释图将系数诞生的训练阶段与系数被使用的推理阶段分开。第二幅图定位了每个组件:浏览器、AI服务、云和图形处理器(GPU)。文章区分了逻辑(代码)与系数(模型),明确了模型不再包含的内容(训练数据),并说明了图示的简化之处。
你的问题和AI的回答之间发生了什么?
概率计算,而非知识库
当你向Claude、ChatGPT或Gemini这样的助手提问时,你的文本会经过三个不同的地方:你的设备、提供商的服务器,以及配备GPU的数据中心。正是在最后这个地方,LLM在运行,这是一个使用巨大的数字表——即模型——来预测下一个词元的程序。
词元是文本的片段:一个词、词的一部分、一个标点符号或一个数字。整个回答就是这样构建的,一次一个词元,每个新词元都是从模型计算了概率的候选中选出的。下面的两幅图首先展示这些数字是如何制造的,然后展示它们是如何被使用的。
第一阶段:训练,系数诞生的地方
╔══════════════════════════════════════════════════════════════╗
║ 训练阶段 ║
╚══════════════════════════════════════════════════════════════╝
书籍 维基百科 文章 网站 代码
│ │ │ │ │
└─────────────┴─────────────┴─────────────┴────────────┘
│
▼
≈ 10¹³ 至 10¹⁴ 词元(数量级)
(单词、词片段、
标点、数字)
│
▼
╔══════════════════╗
║ 训练 ║
║ 调整系数 ║
╚══════════════════╝
│
▼
数十亿次修正
│
▼
╔══════════════════════════════════════════════════════════════╗
║ LLM模型 ║
║--------------------------------------------------------------║
║ 系数 1 = 0.28471 ║
║ 系数 2 = -1.94822 ║
║ 系数 3 = 3.70015 ║
║ 系数 4 = -0.01054 ║
║ ... ║
║ 系数 N = 1.58291 ║
║ ║
║ 1000亿至1万亿个系数 ║
║ (= 模型参数) ║
║ ║
║ - 模型的记忆 - ║
╚══════════════════════════════════════════════════════════════╝
注:
训练阶段:将切分为词元的文本语料库用于调整模型的系数。数量级仅供参考。
来源:庞大的文本语料库
书籍、维基百科、文章、网站、计算机代码:训练语料库首先被切成词元。对于公布了数字的模型,数量级达到数十万亿词元:Meta的Llama 3(2024年)约为15万亿。最新的商业模型的提供商通常不公开这些数值。
训练:调整系数
原理很简单。向模型展示一段文本的开头,它预测下一个词元,将其预测与真实后续进行比较,然后非常轻微地修正系数,使正确答案变得稍微更可能。这种修正通过梯度反向传播计算,在数千个GPU上重复数十亿次,持续数周或数月。
之后,一次更短的二次训练引导模型的行为:回答问题、遵循指令、拒绝某些请求、采用某种语气。它部分依赖人工评估。
训练后剩下什么
只剩下系数,也称为模型的参数:今天的大模型有1000亿到1万亿个数字。文本并非像图书馆那样存放在模型中:它们只是塑造了这些值。模型可以复现某些非常广泛传播的段落(部分记忆),但无法“重读”一本书。
第二阶段:推理,从提示词到回答
┌─ [1] 你的设备:网页浏览器或移动应用 ────────────────────────────┐
│ │
│ ┌────────────────────────────────────────────────────┐ │
│ │ 你输入你的问题(“提示词”): │ │
│ │ “太阳系的中心是” │ │
│ └────────────────────────────────────────────────────┘ │
│ │
│ 作用:输入文本并显示回答。 │
│ 这里没有AI计算(除非本地安装了小型模型)。 │
│ │
└──────────────────────────────────────────────────────────────────┘
│
│ 互联网(HTTPS):
│ 发送文本
▼
┌─ [2] 提供商的AI服务:应用服务器(API) ──────────────────────────┐
│ │
│ 你的问题 会话历史 系统指令 │
│ (提示词) │
│ │ │ │ │
│ └───────────────────┴───────────────────┘ │
│ │ │
│ ▼ │
│ ╔════════════════════════════════════════════════════╗ │
│ ║ 网关与编排 ║ │
│ ║ 认证、配额、安全过滤器 ║ │
│ ║ 组装完整提示词 ║ │
│ ╚════════════════════════════════════════════════════╝ │
│ │
│ 作用:这就是通常被称为“AI”的服务 │
│ (助手),LLM只是其中的一个组件。 │
│ │
└──────────────────────────────────────────────────────────────────┘
│
│ 云内部网络
│ (通往GPU服务器)
▼
┌─ [3] 云:数据中心,GPU / TPU 服务器 ─────────────────────────────┐
│ │
│ ┌────────────────────────────────────────────────────┐ │
│ │ LLM = 推理程序 + 模型 │ │
│ │ (系数文件)加载到GPU内存中 │ │
│ └────────────────────────────────────────────────────┘ │
│ │
│ │ │
│ ▼ │
│ ╔══════════════════════════════════════════════╗ │
│ ║ 词元化 ║ │
│ ║ 将文本切分为词元, ║ │
│ ║ 每个词元一个编号(词典) ║ │
│ ╚══════════════════════════════════════════════╝ │
│ │
│ 太阳 │ 系 │ 的 │ 中心 │ 是 │ ... │
│ 412 │3871│ 95 │15204 │8830│ ... │
│ (编号仅为示例) │
│ │
│ │ │
│ ▼ │
│ ╔══════════════════════════════════════════════╗ │
│ ║ 嵌入(Embedding) ║ │
│ ║ 每个词元变成一个向量 ║ │
│ ║ 由数千个数字 + 其位置组成 ║ │
│ ╚══════════════════════════════════════════════╝ │
│ │
│ │ │
│ ▼ │
│ ╔══════════════════════════════════════════════════════════════╗ │
│ ║ Transformer块,重复约80至120次 ║ │
│ ║ 每层逻辑相同,系数不同 ║ │
│ ╟──────────────────────────────────────────────────────────────╢ │
│ ║ ┌────────────────────────────────────────────────────────┐ ║ │
│ ║ │ 注意力 │ ║ │
│ ║ │ 逻辑(人类编写的代码): │ ║ │
│ ║ │ 比较词元之间、加权、混合 │ ║ │
│ ║ │ 系数(学习得到): │ ║ │
│ ║ │ 矩阵 Q、K、V、O:它们决定关注什么 │ ║ │
│ ║ └────────────────────────────────────────────────────────┘ ║ │
│ ║ │ ║ │
│ ║ ▼ ║ │
│ ║ ┌────────────────────────────────────────────────────────┐ ║ │
│ ║ │ 前馈网络 │ ║ │
│ ║ │ 逻辑(人类编写的代码): │ ║ │
│ ║ │ 乘以矩阵,应用激活函数 │ ║ │
│ ║ │ 系数(学习得到): │ ║ │
│ ║ │ 矩阵 W1 和 W2:模型的“知识”大部分 │ ║ │
│ ║ │ 就存在这里 │ ║ │
│ ║ └────────────────────────────────────────────────────────┘ ║ │
│ ╟──────────────────────────────────────────────────────────────╢ │
│ ║ 系数 = 模型(1000亿至1万亿) ║ │
│ ║ 从200GB到数TB,加载到GPU内存中, ║ │
│ ║ 在回答期间从不修改。 ║ │
│ ║ 训练数据(10¹³至10¹⁴词元)已不在那里: ║ │
│ ║ 只有这些系数保留了它们的痕迹。 ║ │
│ ╚══════════════════════════════════════════════════════════════╝ │
│ │
│ │ │
│ ▼ │
│ ╔══════════════════════════════════════════════╗ │
│ ║ 分数(Logits) ║ │
│ ║ 词汇表中每个词元一个分数 ║ │
│ ║ (约10万个可能的词元) ║ │
│ ╚══════════════════════════════════════════════╝ │
│ │
│ │ │
│ ▼ │
│ ╔══════════════════════════════════════════════╗ │
│ ║ Softmax ║ │
│ ║ 将分数转换为概率 ║ │
│ ╚══════════════════════════════════════════════╝ │
│ │
│ 太阳 = 92% │
│ 月亮 = 4% │
│ 木星 = 3% │
│ 其他 = 1% │
│ │
│ │ │
│ ▼ │
│ ╔══════════════════════════════════════════════╗ │
│ ║ 采样 ║ │
│ ║ 根据概率选择词元 ║ │
│ ║ (设置:温度、top-p) ║ │
│ ╚══════════════════════════════════════════════╝ │
│ │
│ │ │
│ ▼ │
│ 选中的词元:“太阳” │
│ │
│ │ │
│ ▼ │
│ ┌────────────────────────────────────────────────────────┐ │
│ │ 生成循环 │ │
│ │ 词元被添加到文本中,循环重新开始计算下一个词元, │ │
│ │ 直到“结束”词元。 │ │
│ └────────────────────────────────────────────────────────┘ │
│ │
└──────────────────────────────────────────────────────────────────┘
│
│ 流式传输:每个词元
│ 一经计算就返回
│ (AI服务,然后是互联网)
▼
┌─ [4] 你的设备:显示回答 ─────────────────────────────────────────┐
│ │
│ ╔══════════════════════════════════════════════════════════╗ │
│ ║ 回答逐词显示 ║ │
│ ║ “太阳系的中心是太阳。” ║ │
│ ╚══════════════════════════════════════════════════════════╝ │
│ │
└──────────────────────────────────────────────────────────────────┘
╔══════════════════════════════════════════════════════════════╗
║ 图例 ║
╟──────────────────────────────────────────────────────────────╢
║ 模型 = 系数文件(“记忆”) ║
║ LLM = 模型 + 运行它的程序 ║
║ AI = 完整服务:应用、API、过滤器、 ║
║ 会话历史 ║
║ 云 = 托管GPU的数据中心 ║
╚══════════════════════════════════════════════════════════════╝
注:
推理阶段:四个区域,从你的设备到云,然后返回。词元编号和概率仅为示例。
图示分为四个彩色区域,指示每个组件位于何处。区域1和4(蓝色)在你的设备上,区域2(橙色)是提供商的AI服务,区域3(绿色)是云,即数据中心。
区域1:你的设备
浏览器或移动应用只是收集你的文本并显示回答。对于大模型,这里不进行AI计算,因为系数占用数百GB。只有小型紧凑的模型才能在最近的计算机或手机上本地运行。
区域2:提供商的AI服务
你的文本通过互联网(HTTPS协议)到达提供商的应用服务器。网关验证你的身份和配额,应用安全过滤器,然后组装完整提示词:系统指令、会话历史和你最后的问题。
这个细节至关重要:模型不保留会话的任何记忆。是服务在每次提问时把全部历史发回给它,限于上下文窗口之内,即模型一次能读取的最大词元数。这个服务,连同它的应用、过滤器和历史,就是通常所说的“AI”。LLM只是其中的一个组件。
区域3:云及其GPU
完整提示词通过数据中心的内部网络传送到配备GPU或TPU的服务器,这些芯片专为并行执行巨大的矩阵乘法而设计。占用200GB到数TB的模型分布在多个芯片的内存中。这里就是严格意义上的LLM所在之处:与模型关联的推理程序。
云中:七个计算步骤
1. 词元化
文本使用训练前固定的词典(即字节对编码方法)切分为词元。每个词元获得一个编号。高频词形成一个词元;稀有词被切成片段。词汇量约为10万到20万词元。
2. 嵌入(Embedding)
每个词元编号被替换为一个向量,即数千个数字的列表(最大的Llama 3模型为16,384)。由于词序改变意义,位置信息被加入。这些向量本身也是训练中学习到的系数。
3. Transformer块:注意力
模型的核心是Transformer块的堆叠,这是2017年提出的架构。大模型约有80到130个。在每个块中,注意力机制将每个词元与前面的词元比较,计算它们的相对重要性:在“太阳系的中心是”中,“中心”和“太阳系”对预测后续影响很大。决定关注什么的矩阵(记为Q、K、V和O)是系数。
4. Transformer块:前馈网络
每个块还包含一个前馈网络,通过两个由激活函数分隔的大矩阵乘法变换每个向量。可解释性研究表明,这些层在很大程度上作为学习到的关联的记忆,但这种解释仍是研究假设。
在这两个步骤中,逻辑在每个块中相同,因为是同样的代码。只有系数因块而异。
5. 分数和概率
在最后一个块的输出处,模型为词汇表中的每个词元分配一个分数(logit)。Softmax函数将这些分数转换为总和为100%的概率。在图示的例子中,“太阳”获得92%,“月亮”4%,“木星”3%,所有其他词元合计1%。
6. 采样
词元并不总是最可能的那个。一个称为温度的设置会削平或强化概率,top-p方法将抽取限制在最可能的候选中。温度非常低时,回答几乎是确定性的;温度较高时,每次都会变化。这就是为什么同一个问题不总是产生相同的回答。
7. 生成循环
选中的词元,这里是“太阳”,被添加到文本中,整个循环重新开始计算下一个词元,直到模型产生一个特殊的结束词元。因此,一段300词的回答需要数百次连续通过模型。
区域4:回到你的屏幕
词元并非全部一起等待:每个词元一经计算就被返回(流式传输),再次经过AI服务,然后通过互联网。你的设备在它们到达时显示,这给人一种回答“实时书写”的印象。
逻辑与系数:模型真正包含什么?
人们常常混淆三样东西:执行计算的代码、决定结果的系数,以及用于确定这些系数的数据。下表将它们分开。
LLM中的逻辑、系数和数据
| 要素 | 性质 | 来源 | 回答期间存在吗? |
|---|
| 逻辑 | 代码和架构(注意力、前馈、softmax) | 由人类编写 | 是,每个词元都执行 |
|---|
| 系数 | 1000亿至1万亿个数字 | 通过训练调整 | 是,从GPU内存读取,从不修改 |
|---|
| 训练数据 | 书籍、网页、代码 | 训练前收集 | 否,只有系数中的痕迹保留下来 |
|---|
| 提示词和历史 | 会话文本 | 你和AI服务 | 是,每次提问都完整重读 |
|---|
每个组件在哪里?
图示组件的位置和作用
| 组件 | 位置 | 作用 |
|---|
| 浏览器或应用 | 你的设备 | 输入提示词,显示回答 |
|---|
| 网关与编排 | AI服务的服务器 | 认证、配额、过滤器、组装提示词 |
|---|
| 推理程序 | 云的GPU服务器 | 执行七个计算步骤 |
|---|
| 模型 | GPU的内存 | 提供决定概率的系数 |
|---|
| 训练数据 | 回答回路之外 | 仅用于训练 |
|---|
图示的局限
一个有意简化的图示
图示省略了若干要素:每个词元只激活一部分系数的专家混合;注意力计算的缓存内存,避免每个词元都重新计算一切;块内部的归一化和残差连接;AI服务可以调用的外部工具(网络搜索、代码执行);以及图像或声音的处理。根据提供商的不同,词元化也可能在AI服务中而非GPU服务器上进行。
为什么AI能自信地犯错
由于模型选择的是看似合理的词元,而非经过验证的事实,它可以产生流畅但虚假的句子,这被称为幻觉。计算中没有任何东西能区分学到的事实和看似合理的词序:只有概率起作用。因此,与外部来源的连接和人工验证仍然不可或缺。
需要记住的要点
LLM首先是一个乘以矩阵的程序,与一个模型相关联,后者是一个巨大的系数表。这些系数通过在庞大文本语料库上的训练固定下来,然后被冻结。每次提问时,文本从你的设备旅行到数据中心,经过七个计算步骤,产生一个词元,然后重新开始。
这一机制既解释了这些系统的强大,也解释了它们的局限:它们擅长以看似合理的方式延续文本,既没有会话的自身记忆,也没有真实性的保证。理解每个组件的位置,也就是理解计算、能源和机密性的问题所在。
FAQ:LLM如何工作
什么是词元?
词元是模型处理的文本单位:一个高频词、词的一部分、一个标点符号或一个数字。中文文本通常词元数比字数多。
LLM理解它所说的话吗?
从机械上看,它计算下一个词元的概率。但它的内部表征捕捉了概念之间的许多关系,这是否构成某种形式的理解,在AI和认知科学中仍在争论。
模型会从我的会话中学习吗?
会话期间,系数不被修改:模型是冻结的。但服务可能保留历史以返还给你,某些提供商可能根据其政策和你的设置,使用会话为未来版本做准备。
为什么GPU不可或缺?
一个词元的计算归结为巨大的矩阵乘法。GPU可以并行执行数千个,并具有存储系数的快速内存,这是经典处理器在这个规模上无法做到的。
可以在自己的计算机上运行LLM吗?
可以,对于缩小规模的模型,通常经过量化(系数以较低精度存储)。然而,最大的模型需要多个GPU,超出个人计算机的能力。
为什么回答每次都会变化?
因为采样步骤根据概率随机抽取词元。温度非常低时,回答在每次运行之间几乎相同。
什么是幻觉?
它是一种看似合理但虚假的回答。它之所以发生,是因为模型选择可能的词元,而不验证它们所陈述的事实。



 从提示词到回答的旅程:LLM的幕后
 Token:大型语言模型的基本单位
 AI的不同学习类型
 自主人工智能:当机器变得自主
 AI做不到的事情
 人工智能与天文学:理解AI助手的角色
 AI工具:如何选择?

 生成式人工智能
vs 通用人工智能:模仿的终点与意识的起点在哪里?
 人工网络 vs 生物网络:两个系统,一种共同架构
 人脑与人工智能:相似与差异
 AlphaGo vs AlphaGo Zero:人工智能的一场革命
 智能机器的下一步
 生命涌现的第一步
 从生物神经元到形式神经元:大脑的简化
 人工智能:巨人主义的爆炸
 当AI模型用自己的数据训练时,它们会发疯!
 机器如何变得智能
 人工智能:人类的真正威胁还是机遇?
 机器如何以类似人类的方式理解、解释和生成语言?
 人工神经网络是如何工作的?