


Der Weg vom Prompt zur Antwort: hinter den Kulissen eines LLM
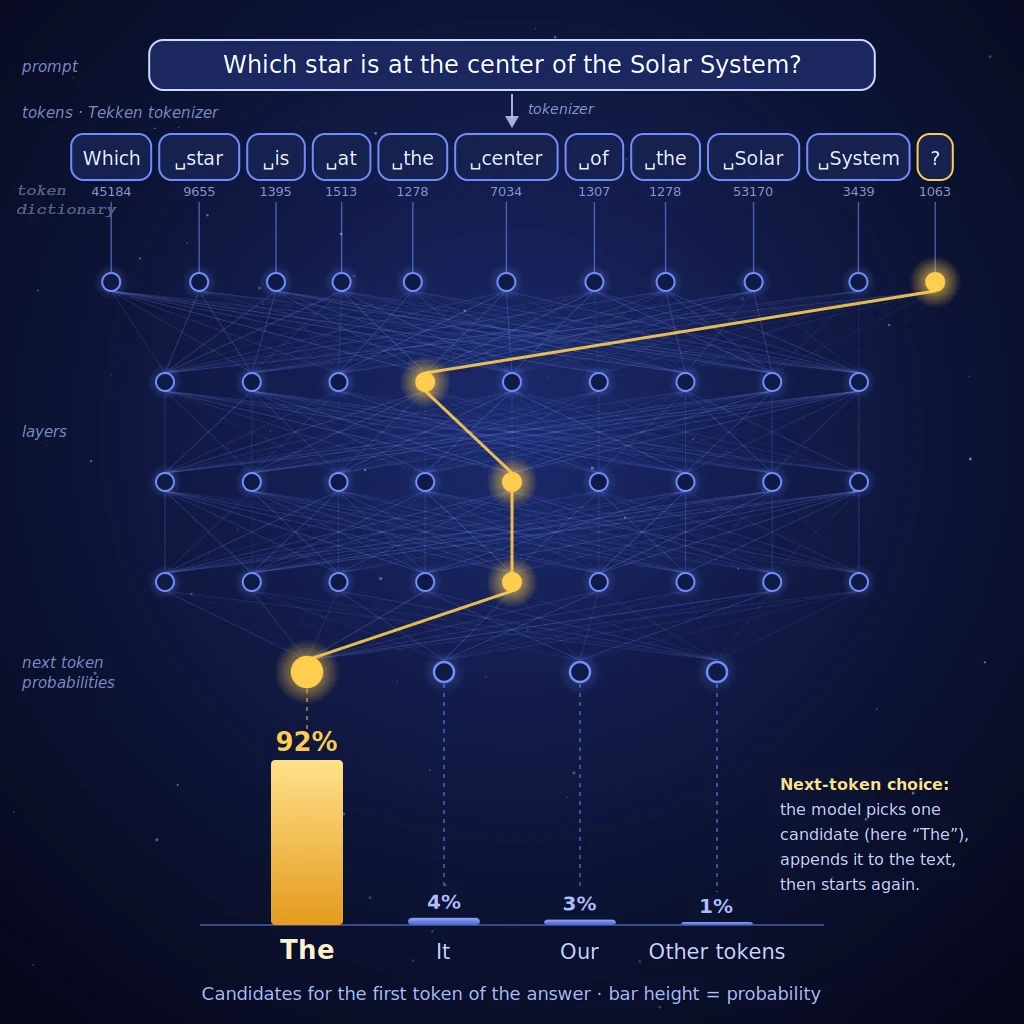
Künstlerische Visualisierung eines in Tokens zerlegten Textes, der die Schichten eines künstlichen neuronalen Netzes durchquert und die Wahrscheinlichkeitsberechnung veranschaulicht, mit der ein großes Sprachmodell (LLM) seine Antwort Wort für Wort erzeugt.
Bildquelle: astronoo.com (neues Fenster): KI-generiertes Bild, gemeinfrei.
Wissenschaftliche Zusammenfassung
Dieser Artikel beschreibt Schritt für Schritt den Weg einer Frage, die an eine konversationelle künstliche Intelligenz gestellt wird, von der Tastatur des Nutzers bis zur angezeigten Antwort. Ein großes Sprachmodell (LLM) konsultiert keine Faktenbank: Es berechnet Token für Token die Wahrscheinlichkeit des nächsten Wortes mithilfe von Hunderten von Milliarden von Koeffizienten, die während des Trainings angepasst wurden. Zwei kommentierte Schemata trennen die Trainingsphase, in der die Koeffizienten entstehen, von der Inferenzphase, in der sie verwendet werden. Das zweite Schema verortet jede Komponente: Browser, KI-Dienst, Cloud und Grafikprozessoren (GPU). Der Artikel unterscheidet die Logik (den Code) von den Koeffizienten (dem Modell), präzisiert, was das Modell nicht mehr enthält (die Trainingsdaten), und erinnert an die Vereinfachungen der Schemata.
Was geschieht zwischen Ihrer Frage und der Antwort einer KI?
Eine Wahrscheinlichkeitsberechnung, keine Wissensdatenbank
Wenn Sie einem Assistenten wie Claude, ChatGPT oder Gemini eine Frage stellen, durchläuft Ihr Text drei verschiedene Orte: Ihr Gerät, die Server des Anbieters und schließlich ein mit GPUs ausgestattetes Rechenzentrum. In Letzterem läuft das LLM, ein Programm, das eine riesige Tabelle von Zahlen, das Modell, verwendet, um das nächste Token vorherzusagen.
Ein Token ist ein Textstück: ein Wort, ein Wortteil, ein Satzzeichen oder eine Zahl. Die gesamte Antwort wird so aufgebaut, ein Token nach dem anderen, wobei jedes neue Token unter Kandidaten ausgewählt wird, deren Wahrscheinlichkeit das Modell berechnet hat. Die beiden folgenden Schemata zeigen zunächst, wie diese Zahlen hergestellt werden, und dann, wie sie verwendet werden.
Auch interessant
Setzen Sie Ihre Erkundung des Universums mit diesen Themen fort:
Phase 1: Das Training, in dem die Koeffizienten entstehen
Anm.:
Trainingsphase: Ein in Tokens zerlegter Textkorpus dient dazu, die Koeffizienten des Modells anzupassen. Die Größenordnungen sind Richtwerte.
Die Quellen: ein immenser Textkorpus
Bücher, Wikipedia, Artikel, Websites, Computerquellcode: Der Trainingskorpus wird zunächst in Tokens zerlegt. Bei Modellen, deren Zahlen veröffentlicht sind, liegt die Größenordnung bei Zehntausenden von Milliarden Tokens: etwa 15.000 Milliarden für Llama 3 von Meta (2024). Die Anbieter der neuesten kommerziellen Modelle geben diese Werte im Allgemeinen nicht bekannt.
Das Training: Koeffizienten anpassen
Das Prinzip ist einfach. Dem Modell wird der Anfang eines Textes gezeigt, es sagt das nächste Token voraus, seine Vorhersage wird mit der tatsächlichen Fortsetzung verglichen, und dann werden die Koeffizienten sehr leicht korrigiert, damit die richtige Antwort etwas wahrscheinlicher wird. Diese Korrektur, die durch Gradientenrückpropagation berechnet wird, wird Milliarden Mal auf Tausenden von GPUs wiederholt, über Wochen oder Monate.
Ein zweites, kürzeres Training lenkt anschließend das Verhalten des Modells: Fragen beantworten, Anweisungen befolgen, bestimmte Anfragen ablehnen, einen Ton annehmen. Es stützt sich teilweise auf menschliche Bewertungen.
Was nach dem Training bleibt
Es bleiben nur die Koeffizienten, auch Parameter des Modells genannt: 100 bis 1000 Milliarden Zahlen bei den heutigen großen Modellen. Die Texte werden nicht wie in einer Bibliothek im Modell aufbewahrt: Sie haben diese Werte lediglich geformt. Ein Modell kann bestimmte sehr verbreitete Passagen wiedergeben (teilweise Memorierung), aber es kann kein Buch „nachlesen“.
Phase 2: Die Inferenz, vom Prompt zur Antwort
Anm.:
Inferenzphase: vier Zonen, von Ihrem Gerät zur Cloud und zurück. Die Token-Nummern und Wahrscheinlichkeiten sind als Beispiele angegeben.
Das Schema ist in vier farbige Zonen unterteilt, die angeben, wo sich jede Komponente befindet. Die Zonen 1 und 4 (blau) sind auf Ihrem Gerät, Zone 2 (orange) ist der KI-Dienst des Anbieters, Zone 3 (grün) ist die Cloud, das heißt ein Rechenzentrum.
Zone 1: Ihr Gerät
Der Browser oder die mobile Anwendung sammelt nur Ihren Text und zeigt die Antwort an. Bei großen Modellen findet hier keine KI-Berechnung statt, da die Koeffizienten Hunderte von Gigabyte belegen. Nur kleine kompakte Modelle können lokal auf einem neueren Computer oder Telefon laufen.
Zone 2: der KI-Dienst des Anbieters
Ihr Text reist über das Internet (HTTPS-Protokoll) zu den Anwendungsservern des Anbieters. Ein Gateway prüft Ihre Identität und Ihre Kontingente, wendet Sicherheitsfilter an und setzt dann den vollständigen Prompt zusammen: die Systemanweisungen, den Verlauf der Unterhaltung und Ihre letzte Frage.
Dieses Detail ist wesentlich: Das Modell behält keinerlei Gedächtnis der Unterhaltung. Der Dienst ist es, der ihm bei jeder Frage den gesamten Verlauf zurücksendet, innerhalb der Grenze des Kontextfensters, das heißt der maximalen Anzahl von Tokens, die das Modell auf einmal lesen kann. Dieser Dienst mit seiner Anwendung, seinen Filtern und seinem Verlauf ist es, was man gemeinhin „die KI“ nennt. Das LLM ist nur eine ihrer Komponenten.
Zone 3: die Cloud und ihre GPUs
Der vollständige Prompt wird über das interne Netzwerk des Rechenzentrums an Server übertragen, die mit GPUs oder TPUs ausgestattet sind, Chips, die dafür ausgelegt sind, enorme Matrixmultiplikationen parallel auszuführen. Das Modell, das 200 GB bis mehrere Terabyte belegt, ist auf den Speicher mehrerer Chips verteilt. Hier findet sich das LLM im engeren Sinne: ein Inferenzprogramm in Verbindung mit dem Modell.
In der Cloud: sieben Berechnungsschritte
1. Tokenisierung
Der Text wird mithilfe eines vor dem Training festgelegten Wörterbuchs in Tokens zerlegt (das sogenannte Byte-Pair-Encoding). Jedes Token erhält eine Nummer. Häufige Wörter bilden ein einziges Token; seltene Wörter werden in Stücke zerlegt. Das Vokabular umfasst in der Größenordnung 100 000 bis 200 000 Tokens.
2. Einbettung (Embedding)
Jede Token-Nummer wird durch einen Vektor ersetzt, eine Liste von Tausenden von Zahlen (16 384 beim größten Llama-3-Modell). Die Positionsinformation wird hinzugefügt, denn die Wortreihenfolge verändert den Sinn. Diese Vektoren sind selbst Koeffizienten, die während des Trainings gelernt wurden.
3. Die Transformer-Blöcke: die Attention
Das Herz des Modells ist ein Stapel von Transformer-Blöcken, eine 2017 vorgeschlagene Architektur. Große Modelle haben in der Größenordnung 80 bis 130 davon. In jedem Block vergleicht der Attention-Mechanismus jedes Token mit den vorhergehenden Tokens und berechnet ihre relative Wichtigkeit: In „Im Zentrum des Sonnensystems befindet sich die“ wiegen die Wörter „Zentrum“ und „Sonnensystems“ schwer für die Vorhersage der Fortsetzung. Die Matrizen, die entscheiden, worauf Aufmerksamkeit gerichtet wird (mit Q, K, V und O bezeichnet), sind Koeffizienten.
4. Die Transformer-Blöcke: das Feed-Forward-Netz
Jeder Block enthält außerdem ein Feed-Forward-Netz, das jeden Vektor durch zwei große Matrixmultiplikationen transformiert, getrennt durch eine Aktivierungsfunktion. Arbeiten zur Interpretierbarkeit legen nahe, dass diese Schichten zu großen Teilen als Gedächtnis für gelernte Assoziationen dienen, doch diese Interpretation bleibt eine Forschungshypothese.
In diesen beiden Schritten ist die Logik in jedem Block identisch, denn es ist derselbe Code. Nur die Koeffizienten unterscheiden sich von Block zu Block.
5. Scores und Wahrscheinlichkeiten
Am Ausgang des letzten Blocks weist das Modell jedem der Tokens des Vokabulars einen Score (Logit) zu. Die Softmax-Funktion wandelt diese Scores in Wahrscheinlichkeiten um, deren Summe 100 % beträgt. Im Beispiel des Schemas erhält „Sonne“ 92 %, „Mond“ 4 %, „Jupiter“ 3 % und alle anderen Tokens zusammen 1 %.
6. Stichprobenentnahme
Das Token ist nicht immer das wahrscheinlichste. Eine Einstellung namens Temperatur flacht die Wahrscheinlichkeiten ab oder verstärkt sie, und die Top-p-Methode begrenzt die Ziehung auf die wahrscheinlichsten Kandidaten. Bei sehr niedriger Temperatur ist die Antwort nahezu deterministisch; bei höherer variiert sie von Mal zu Mal. Deshalb liefert dieselbe Frage nicht immer dieselbe Antwort.
7. Die Generierungsschleife
Das gewählte Token, hier „Sonne“, wird dem Text hinzugefügt, und der gesamte Zyklus beginnt von vorn, um das nächste Token zu berechnen, bis das Modell ein spezielles End-Token erzeugt. Eine Antwort von 300 Wörtern erfordert daher mehrere Hundert aufeinanderfolgende Durchläufe durch das Modell.
Zone 4: die Rückkehr zu Ihrem Bildschirm
Die Tokens werden nicht alle gemeinsam abgewartet: Jedes wird zurückgesendet, sobald es berechnet ist (Streaming), wobei es erneut den KI-Dienst und dann das Internet durchläuft. Ihr Gerät zeigt sie nach und nach an, was den Eindruck einer „live geschriebenen“ Antwort erweckt.
Logik und Koeffizienten: Was enthält ein Modell wirklich?
Oft werden drei Dinge verwechselt: der Code, der die Berechnungen ausführt, die Koeffizienten, die das Ergebnis bestimmen, und die Daten, die zur Festlegung dieser Koeffizienten dienten. Die folgende Tabelle trennt sie.
| Element | Natur | Ursprung | Während der Antwort vorhanden? |
|---|---|---|---|
| Logik | Code und Architektur (Attention, Feed-Forward, Softmax) | Von Menschen geschrieben | Ja, bei jedem Token ausgeführt |
| Koeffizienten | 100 bis 1000 Milliarden Zahlen | Durch Training angepasst | Ja, aus dem GPU-Speicher gelesen, nie verändert |
| Trainingsdaten | Bücher, Webseiten, Code | Vor dem Training gesammelt | Nein, nur Spuren in den Koeffizienten bleiben |
| Prompt und Verlauf | Text der Unterhaltung | Sie und der KI-Dienst | Ja, bei jeder Frage vollständig neu gelesen |
Wo befindet sich jede Komponente?
| Komponente | Ort | Rolle |
|---|---|---|
| Browser oder Anwendung | Ihr Gerät | Eingabe des Prompts, Anzeige der Antwort |
| Gateway und Orchestrierung | Server des KI-Dienstes | Authentifizierung, Kontingente, Filter, Zusammenbau des Prompts |
| Inferenzprogramm | GPU-Server der Cloud | Führt die sieben Berechnungsschritte aus |
| Modell | Speicher der GPUs | Liefert die Koeffizienten, die die Wahrscheinlichkeiten bestimmen |
| Trainingsdaten | Außerhalb des Antwortkreislaufs | Dienten ausschließlich dem Training |
Die Grenzen des Schemas
Ein bewusst vereinfachtes Schema
Die Schemata lassen mehrere Elemente beiseite: die Expertenmischungen, bei denen für jedes Token nur ein Teil der Koeffizienten aktiviert wird; den Cache-Speicher der Attention-Berechnungen, der vermeidet, bei jedem Token alles neu zu berechnen; die Normalisierungen und Restverbindungen innerhalb der Blöcke; die externen Werkzeuge (Websuche, Codeausführung), die der KI-Dienst aufrufen kann; und die Verarbeitung von Bildern oder Tönen. Je nach Anbieter kann die Tokenisierung auch im KI-Dienst statt auf dem GPU-Server erfolgen.
Warum eine KI sich mit Überzeugung irren kann
Da das Modell plausible Tokens wählt und nicht überprüfte Fakten, kann es einen flüssigen, aber falschen Satz erzeugen, den man eine Halluzination nennt. Nichts in der Berechnung unterscheidet einen gelernten Fakt von einer wahrscheinlichen Wortfolge: Nur die Wahrscheinlichkeit zählt. Verbindungen zu externen Quellen und menschliche Überprüfung bleiben daher unverzichtbar.
Was man sich merken sollte
Ein LLM ist zuallererst ein Programm, das Matrizen multipliziert, verbunden mit einem Modell, das eine immense Tabelle von Koeffizienten ist. Diese Koeffizienten wurden durch Training auf enormen Textkorpora festgelegt und dann eingefroren. Bei jeder Frage reist der Text von Ihrem Gerät zu einem Rechenzentrum, durchläuft sieben Berechnungsschritte, erzeugt ein Token und beginnt dann von vorn.
Dieser Mechanismus erklärt sowohl die Leistungsfähigkeit dieser Systeme als auch ihre Grenzen: Sie sind hervorragend darin, einen Text plausibel fortzusetzen, und haben weder ein eigenes Gedächtnis der Unterhaltung noch eine Garantie der Wahrheit. Zu verstehen, wo sich jede Komponente befindet, heißt auch zu verstehen, wo die Fragen von Rechenleistung, Energie und Vertraulichkeit liegen.
Referenzen
FAQ: Wie ein LLM funktioniert
Was ist ein Token?
Ein Token ist die vom Modell verarbeitete Texteinheit: ein häufiges Wort, ein Wortteil, ein Satzzeichen oder eine Zahl. Ein deutscher Text hat im Allgemeinen etwas mehr Tokens als Wörter.
Versteht ein LLM, was es sagt?
Mechanisch berechnet es die Wahrscheinlichkeit des nächsten Tokens. Seine internen Repräsentationen erfassen jedoch zahlreiche Beziehungen zwischen den Begriffen, und die Frage, ob dies eine Form des Verstehens darstellt, wird in der KI und in den Kognitionswissenschaften weiterhin diskutiert.
Lernt das Modell aus meiner Unterhaltung?
Während der Unterhaltung werden die Koeffizienten nicht verändert: Das Modell ist eingefroren. Der Dienst kann jedoch den Verlauf speichern, um ihn Ihnen zurückzugeben, und manche Anbieter können Unterhaltungen nutzen, um künftige Versionen vorzubereiten, je nach ihrer Politik und Ihren Einstellungen.
Warum sind GPUs unverzichtbar?
Die Berechnung eines Tokens läuft auf enorme Matrixmultiplikationen hinaus. GPUs führen Tausende davon parallel aus und verfügen über einen schnellen Speicher für die Koeffizienten, was klassische Prozessoren in diesem Maßstab nicht leisten können.
Kann man ein LLM auf dem eigenen Computer laufen lassen?
Ja, für Modelle reduzierter Größe, oft quantisiert (Koeffizienten mit geringerer Genauigkeit gespeichert). Die größten Modelle erfordern dagegen mehrere GPUs und übersteigen die Möglichkeiten eines Personal Computers.
Warum ändert sich die Antwort von Mal zu Mal?
Weil der Schritt der Stichprobenentnahme das Token nach den Wahrscheinlichkeiten zufällig zieht. Bei einer sehr niedrigen Temperatur wird die Antwort von einem Durchlauf zum nächsten nahezu identisch.
Was ist eine Halluzination?
Es ist eine plausible, aber falsche Antwort. Sie entsteht, weil das Modell wahrscheinliche Tokens wählt, ohne die von ihnen genannten Fakten zu überprüfen.
 Der Weg vom Prompt zur Antwort: hinter den Kulissen eines LLM
 Das Token: die grundlegende Einheit großer Sprachmodelle
 Die verschiedenen Lernarten der KI
 Agentische KI: Wenn Maschinen autonom werden
 Was KI nicht kann
 Künstliche Intelligenz und Astronomie: Die Rolle der KI-Assistenten verstehen
 KI-Tools: Wie wählt man aus?

 Generative KI vs AGI: Wo endet Nachahmung, wo beginnt Bewusstsein?
 Künstliche Netzwerke vs. biologische Netzwerke: Zwei Systeme, eine gemeinsame Architektur
 Menschliches Gehirn und künstliche Intelligenzen: Ähnlichkeiten und Unterschiede
 AlphaGo gegen AlphaGo Zero: Eine Revolution der künstlichen Intelligenz
 Der nächste Schritt intelligenter Maschinen
 Der erste Schritt zur Entstehung des Lebens
 Vom biologischen Neuron zum formalen Neuron: Vereinfachung des Gehirns
 Künstliche Intelligenz: Die Explosion des Gigantismus
 Wenn künstliche Intelligenz verrückt wird!
 Wie Maschinen intelligent werden
 Künstliche Intelligenz: reale Bedrohung oder Chance für die Menschheit?
 Wie Maschinen Sprache ähnlich wie Menschen verstehen, interpretieren und erzeugen
 Wie funktioniert ein künstliches neuronales Netzwerk?