


O percurso do prompt à resposta: nos bastidores de um LLM
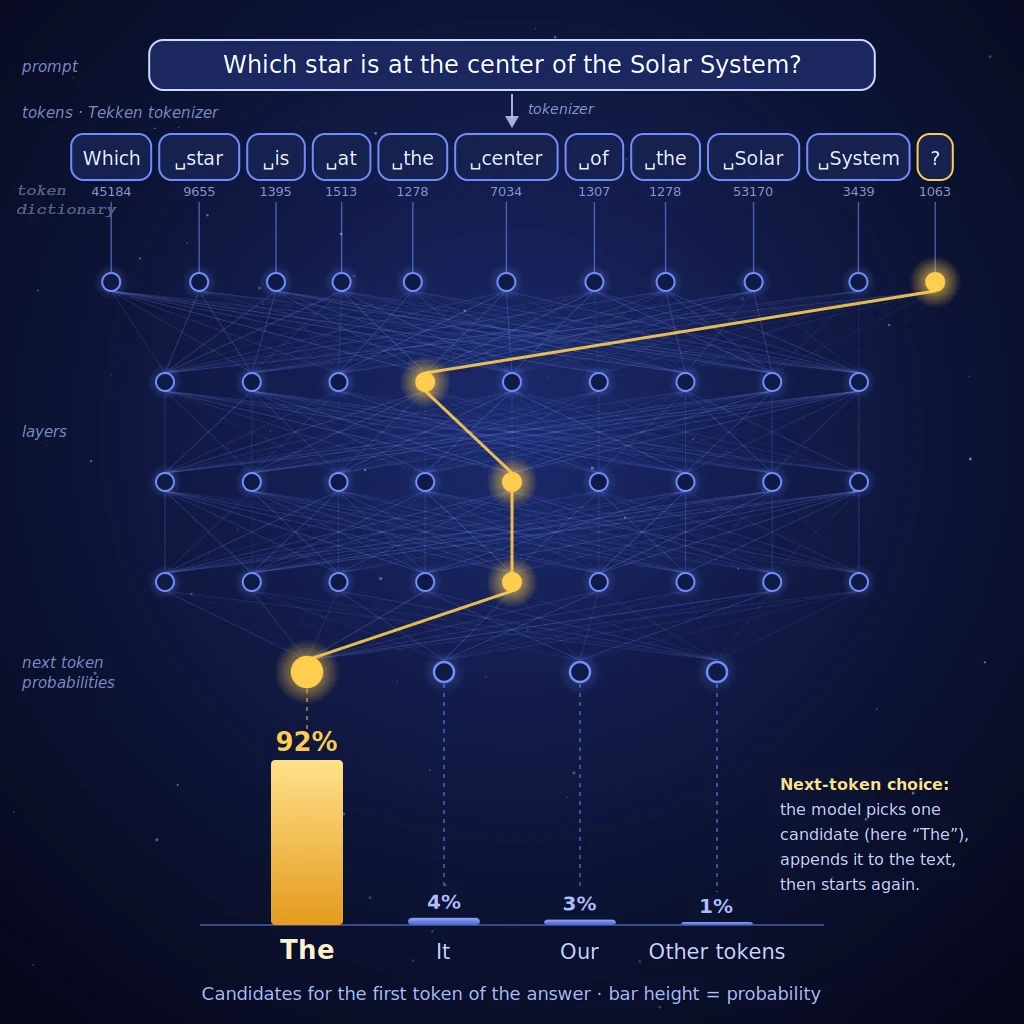
Visualização artística de um texto cortado em tokens que atravessa as camadas de uma rede de neurónios artificiais, ilustrando o cálculo de probabilidades pelo qual um grande modelo de linguagem (LLM) produz a sua resposta palavra a palavra.
Fonte da imagem: astronoo.com (nova janela): imagem gerada por IA, domínio público.
Resumo científico
Este artigo descreve passo a passo o percurso de uma pergunta feita a uma inteligência artificial conversacional, do teclado do utilizador à resposta apresentada. Um grande modelo de linguagem (LLM) não consulta uma base de factos: calcula, token a token, a probabilidade da palavra seguinte com a ajuda de centenas de milhares de milhões de coeficientes ajustados durante o treino. Dois esquemas comentados separam a fase de aprendizagem, onde nascem os coeficientes, da fase de inferência, onde são utilizados. O segundo esquema localiza cada componente: navegador, serviço de IA, nuvem e unidades de processamento gráfico (GPU). O artigo distingue a lógica (o código) dos coeficientes (o modelo), precisa o que o modelo já não contém (os dados de treino) e recorda as simplificações dos esquemas.
O que acontece entre a sua pergunta e a resposta de uma IA?
Um cálculo de probabilidades, não uma base de conhecimentos
Quando faz uma pergunta a um assistente como Claude, ChatGPT ou Gemini, o seu texto atravessa três locais diferentes: o seu dispositivo, os servidores do editor e, em seguida, um centro de dados equipado com GPU. É neste último que corre o LLM, um programa que utiliza uma imensa tabela de números, o modelo, para prever o token seguinte.
Um token é um fragmento de texto: uma palavra, parte de uma palavra, um sinal de pontuação ou um número. Toda a resposta é construída assim, um token de cada vez, sendo cada novo token escolhido entre candidatos cuja probabilidade o modelo calculou. Os dois esquemas abaixo mostram primeiro como estes números são fabricados e depois como são utilizados.
Também para descobrir
Continue a sua exploração do Universo com estes temas:
Fase 1: a aprendizagem, onde nascem os coeficientes
N.B.:
Fase de aprendizagem: um corpus de texto, cortado em tokens, serve para ajustar os coeficientes do modelo. As ordens de grandeza são indicativas.
As fontes: um imenso corpus de texto
Livros, Wikipédia, artigos, sites, código informático: o corpus de treino é primeiro cortado em tokens. Para os modelos cujos números são publicados, a ordem de grandeza conta-se em dezenas de milhares de milhares de milhões de tokens: cerca de 15.000 mil milhões para o Llama 3, da Meta (2024). Os editores dos modelos comerciais mais recentes geralmente não comunicam estes valores.
O treino: ajustar coeficientes
O princípio é simples. Apresenta-se ao modelo o início de um texto, ele prevê o token seguinte, compara-se a sua previsão com a continuação real e depois corrigem-se muito ligeiramente os coeficientes para que a resposta correta se torne um pouco mais provável. Esta correção, calculada por retropropagação do gradiente, é repetida milhares de milhões de vezes em milhares de GPU, durante semanas ou meses.
Um segundo treino, mais curto, orienta depois o comportamento do modelo: responder a perguntas, seguir instruções, recusar certos pedidos, adotar um tom. Baseia-se em parte em avaliações humanas.
O que resta após o treino
Restam apenas os coeficientes, também chamados parâmetros do modelo: de 100 a 1000 mil milhões de números para os grandes modelos atuais. Os textos não são guardados no modelo como numa biblioteca: apenas moldaram estes valores. Um modelo pode reproduzir certas passagens muito difundidas (memorização parcial), mas não pode "reler" um livro.
Fase 2: a inferência, do prompt à resposta
N.B.:
Fase de inferência: quatro zonas, do seu dispositivo à nuvem, e depois regresso. Os números de tokens e as probabilidades são dados a título de exemplo.
O esquema está dividido em quatro zonas coloridas que indicam onde se encontra cada componente. As zonas 1 e 4 (azul) estão no seu dispositivo, a zona 2 (laranja) é o serviço de IA do editor, a zona 3 (verde) é a nuvem, ou seja, um centro de dados.
Zona 1: o seu dispositivo
O navegador ou a aplicação móvel limita-se a recolher o seu texto e a apresentar a resposta. Para os grandes modelos, aqui não tem lugar qualquer cálculo de IA, pois os coeficientes ocupam centenas de gigabytes. Apenas os pequenos modelos compactos podem correr localmente num computador ou telemóvel recente.
Zona 2: o serviço de IA do editor
O seu texto viaja pela Internet (protocolo HTTPS) até aos servidores de aplicação do editor. Um portal verifica a sua identidade e as suas quotas, aplica filtros de segurança e depois monta o prompt completo: as instruções do sistema, o histórico da conversa e a sua última pergunta.
Este detalhe é essencial: o modelo não guarda qualquer memória da conversa. É o serviço que lhe devolve todo o histórico a cada pergunta, dentro do limite da janela de contexto, isto é, do número máximo de tokens que o modelo pode ler de uma vez. Este serviço, com a sua aplicação, os seus filtros e o seu histórico, é o que se chama habitualmente "a IA". O LLM é apenas um componente dela.
Zona 3: a nuvem e as suas GPU
O prompt completo é transmitido pela rede interna do centro de dados a servidores equipados com GPU ou TPU, chips concebidos para efetuar em paralelo enormes multiplicações de matrizes. O modelo, que ocupa de 200 GB a vários terabytes, é repartido pela memória de vários chips. É aqui que se encontra o LLM em sentido estrito: um programa de inferência associado ao modelo.
Na nuvem: sete etapas de cálculo
1. Tokenização
O texto é cortado em tokens com a ajuda de um dicionário fixado antes do treino (método designado byte-pair encoding). Cada token recebe um número. As palavras frequentes formam um único token; as palavras raras são cortadas em fragmentos. O vocabulário conta com a ordem de 100.000 a 200.000 tokens.
2. Embedding (incorporação)
Cada número de token é substituído por um vetor, uma lista de milhares de números (16.384 para o maior modelo Llama 3). Acrescenta-se a informação de posição, pois a ordem das palavras altera o sentido. Estes vetores são eles próprios coeficientes aprendidos durante o treino.
3. Os blocos Transformer: a atenção
O coração do modelo é uma pilha de blocos Transformer, arquitetura proposta em 2017. Os grandes modelos contam com a ordem de 80 a 130. Em cada bloco, o mecanismo de atenção compara cada token com os tokens precedentes e calcula a sua importância relativa: em "No centro do Sistema Solar encontra-se o", as palavras "centro" e "Solar" pesam muito para prever a continuação. As matrizes que decidem a que prestar atenção (denotadas Q, K, V e O) são coeficientes.
4. Os blocos Transformer: a rede feed-forward
Cada bloco contém também uma rede feed-forward, que transforma cada vetor por duas grandes multiplicações de matrizes separadas por uma função de ativação. Trabalhos de interpretabilidade sugerem que estas camadas servem em grande parte de memória para associações aprendidas, mas esta interpretação continua a ser uma hipótese de investigação.
Nestas duas etapas, a lógica é idêntica em cada bloco, pois é o mesmo código. Apenas os coeficientes diferem de um bloco para outro.
5. Pontuações e probabilidades
À saída do último bloco, o modelo atribui uma pontuação (logit) a cada um dos tokens do vocabulário. A função softmax converte estas pontuações em probabilidades cuja soma vale 100%. No exemplo do esquema, "Sol" obtém 92%, "Lua" 4%, "Júpiter" 3% e todos os outros tokens juntos 1%.
6. Amostragem
O token não é sempre o mais provável. Um ajuste chamado temperatura achata ou acentua as probabilidades, e o método top-p limita o sorteio aos candidatos mais prováveis. A temperatura muito baixa, a resposta é quase determinista; mais alta, varia de uma vez para outra. É por isso que a mesma pergunta nem sempre produz a mesma resposta.
7. O ciclo de geração
O token escolhido, aqui "Sol", é acrescentado ao texto, e todo o ciclo recomeça para calcular o token seguinte, até que o modelo produza um token especial de fim. Uma resposta de 300 palavras exige, portanto, várias centenas de passagens sucessivas pelo modelo.
Zona 4: o regresso ao seu ecrã
Os tokens não são esperados todos juntos: cada um é devolvido assim que é calculado (streaming), passando de novo pelo serviço de IA e depois pela Internet. O seu dispositivo apresenta-os à medida que chegam, o que dá a impressão de uma resposta "escrita em direto".
Lógica e coeficientes: o que contém realmente um modelo?
Confundem-se frequentemente três coisas: o código que efetua os cálculos, os coeficientes que determinam o resultado e os dados que serviram para fixar esses coeficientes. A tabela abaixo separa-as.
| Elemento | Natureza | Origem | Presente durante a resposta? |
|---|---|---|---|
| Lógica | Código e arquitetura (atenção, feed-forward, softmax) | Escrita por humanos | Sim, executada em cada token |
| Coeficientes | 100 a 1000 mil milhões de números | Ajustados pelo treino | Sim, lidos em memória GPU, nunca modificados |
| Dados de treino | Livros, páginas web, código | Recolhidos antes do treino | Não, apenas subsistem os rastos nos coeficientes |
| Prompt e histórico | Texto da conversa | Você e o serviço de IA | Sim, relido por inteiro a cada pergunta |
Onde se encontra cada componente?
| Componente | Localização | Função |
|---|---|---|
| Navegador ou aplicação | O seu dispositivo | Introdução do prompt, apresentação da resposta |
| Portal e orquestração | Servidores do serviço de IA | Autenticação, quotas, filtros, montagem do prompt |
| Programa de inferência | Servidores GPU da nuvem | Executa as sete etapas de cálculo |
| Modelo | Memória das GPU | Fornece os coeficientes que determinam as probabilidades |
| Dados de treino | Fora do circuito de resposta | Serviram apenas para o treino |
Os limites do esquema
Um esquema deliberadamente simplificado
Os esquemas deixam de lado vários elementos: as misturas de especialistas, em que apenas uma parte dos coeficientes é ativada para cada token; a memória cache dos cálculos de atenção, que evita recalcular tudo a cada token; as normalizações e ligações residuais no interior dos blocos; as ferramentas externas (pesquisa web, execução de código) que o serviço de IA pode chamar; e o tratamento de imagens ou sons. Segundo os editores, a tokenização também pode efetuar-se no serviço de IA em vez de no servidor GPU.
Por que uma IA pode enganar-se com aplomb
Como o modelo escolhe tokens plausíveis, e não factos verificados, pode produzir uma frase fluente mas falsa, a que se chama uma alucinação. Nada no cálculo distingue um facto aprendido de uma sequência de palavras verosímil: só conta a probabilidade. As ligações a fontes externas e a verificação humana continuam, por isso, a ser indispensáveis.
O que é preciso reter
Um LLM é antes de mais um programa que multiplica matrizes, associado a um modelo que é uma imensa tabela de coeficientes. Estes coeficientes foram fixados pelo treino sobre enormes corpus de texto, e depois congelados. A cada pergunta, o texto viaja do seu dispositivo até um centro de dados, atravessa sete etapas de cálculo, produz um token e depois recomeça.
Este mecanismo explica ao mesmo tempo a potência destes sistemas e os seus limites: são excelentes a continuar um texto de forma plausível, e não têm memória própria da conversa nem garantia de verdade. Compreender onde se encontra cada componente é também compreender onde se situam as questões de cálculo, de energia e de confidencialidade.
Referências
FAQ: Como funciona um LLM
O que é um token?
Um token é a unidade de texto manipulada pelo modelo: uma palavra frequente, um fragmento de palavra, um sinal de pontuação ou um número. Um texto em português tem geralmente um pouco mais de tokens do que de palavras.
Um LLM compreende o que diz?
Mecanicamente, calcula a probabilidade do token seguinte. As suas representações internas captam, no entanto, numerosas relações entre os conceitos, e a questão de saber se isso constitui uma forma de compreensão continua a ser debatida em IA e em ciências cognitivas.
O modelo aprende com a minha conversa?
Durante a conversa, os coeficientes não são modificados: o modelo está congelado. O serviço pode, porém, conservar o histórico para o devolver, e alguns editores podem utilizar conversas para preparar futuras versões, segundo a sua política e os seus ajustes.
Por que são as GPU indispensáveis?
O cálculo de um token resume-se a enormes multiplicações de matrizes. As GPU efetuam milhares em paralelo e dispõem de uma memória rápida para armazenar os coeficientes, o que os processadores clássicos não permitem a esta escala.
Pode-se executar um LLM no próprio computador?
Sim, para modelos de tamanho reduzido, muitas vezes quantizados (coeficientes armazenados com menos precisão). Os maiores modelos exigem, em contrapartida, várias GPU e ultrapassam as capacidades de um computador pessoal.
Por que muda a resposta de uma vez para outra?
Porque a etapa de amostragem sorteia o token ao acaso segundo as probabilidades. Com uma temperatura muito baixa, a resposta torna-se quase idêntica de uma execução para outra.
O que é uma alucinação?
É uma resposta plausível mas falsa. Surge porque o modelo escolhe tokens verosímeis, sem verificar os factos que enunciam.
 O percurso do prompt à resposta: nos bastidores de um LLM
 O token: a unidade fundamental dos grandes modelos de linguagem
 Os diferentes tipos de aprendizagem das IA
 IA Agêntica: Quando as máquinas se tornam autônomas
 O que a IA não pode fazer
 Inteligência artificial e astronomia: Compreender o papel dos assistentes IA
 Ferramentas de IA: como escolher?

 IA Generativa vs AGI: Onde termina a imitação e onde começa a consciência?
 Redes artificiais vs. redes biológicas: Dois sistemas, uma arquitetura comum
 Cérebro Humano e Inteligências Artificiais: Semelhanças e Diferenças
 AlphaGo contra AlphaGo Zero: Uma Revolução na Inteligência Artificial
 O próximo passo das máquinas inteligentes
 Do Neurônio Biológico ao Neurônio Formal: Simplificação do Cérebro
 Inteligência artificial: a explosão do gigantismo
 Quando a inteligência artificial enlouquece!
 Como as máquinas se tornam inteligentes
 Inteligência artificial: ameaça real ou oportunidade para a humanidade?
 Como as máquinas entendem, interpretam e geram linguagem de maneira semelhante aos humanos?
 Como funciona uma rede neural artificial?