


プロンプトから応答までの道のり:LLMの舞台裏
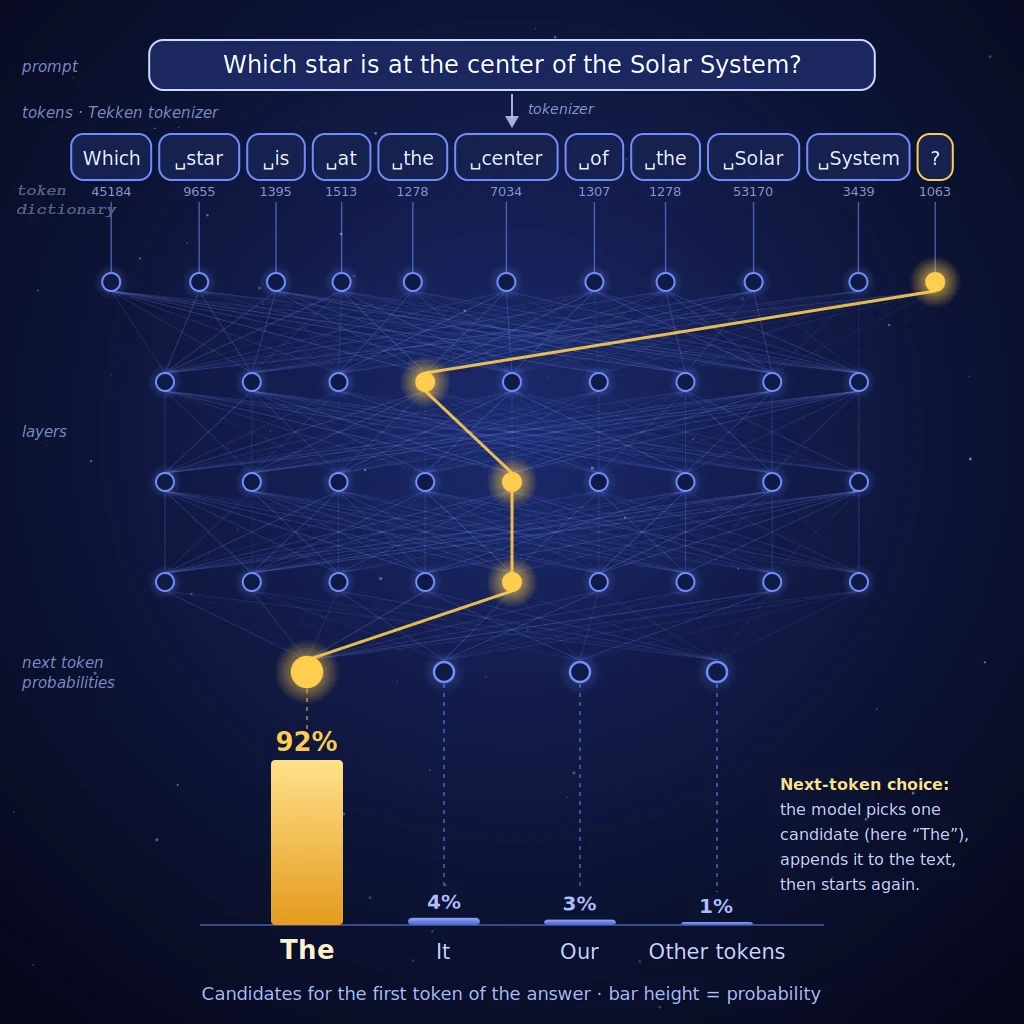
トークンに分割されたテキストが人工ニューラルネットワークの層を通過し、大規模言語モデル(LLM)が単語ごとに応答を生成する確率計算を描いたアーティスティックな可視化。
画像出典:astronoo.com(新しいウィンドウ):AI生成画像、パブリックドメイン。
科学的要旨
本記事は、対話型人工知能に投げかけられた質問が、ユーザーのキーボードから表示される応答までの道のりを順を追って説明する。大規模言語モデル(LLM)は事実のデータベースを参照するのではなく、学習中に調整された数千億の係数を用いて、トークンごとに次の単語の確率を計算する。2つの解説図が、係数が生まれる学習フェーズと、それらが使われる推論フェーズを分けている。2番目の図は、ブラウザ、AIサービス、クラウド、GPU(グラフィックス処理装置)という各構成要素の位置を示す。本記事はロジック(コード)と係数(モデル)を区別し、モデルがもはや含まないもの(学習データ)を明確にし、図の簡略化についても述べる。
あなたの質問とAIの応答の間には何が起きているのか?
知識ベースではなく確率の計算
Claude、ChatGPT、Geminiなどのアシスタントに質問すると、あなたのテキストは3つの異なる場所を通過する。あなたの端末、提供元のサーバー、そしてGPUを備えたデータセンターである。最後の場所でLLMが動作しており、これは膨大な数値の表であるモデルを使って次のトークンを予測するプログラムである。
トークンとはテキストの断片である。単語、単語の一部、句読点、数字などである。応答全体はこのように、一度に1トークンずつ構築され、新しいトークンはそれぞれ、モデルが確率を計算した候補の中から選ばれる。以下の2つの図は、まずこれらの数値がどのように作られるかを示し、次にそれらがどのように使われるかを示す。
こちらもおすすめ
宇宙の探検をさらに深めるためのテーマをご紹介します:
フェーズ1:学習、係数が生まれる場所
注:
学習フェーズ:トークンに分割されたテキストコーパスが、モデルの係数を調整するために使われる。桁の目安は参考値である。
情報源:膨大なテキストコーパス
書籍、ウィキペディア、記事、ウェブサイト、コンピュータコード。学習コーパスはまずトークンに分割される。数値が公開されているモデルでは、桁の目安は数兆から数十兆トークンにのぼる。MetaのLlama 3(2024年)では約15兆トークンである。最新の商用モデルの提供元は、一般にこれらの値を公表していない。
学習:係数を調整する
原理は単純である。モデルにテキストの冒頭を見せ、モデルが次のトークンを予測し、その予測を実際の続きと比較し、正しい答えが少しだけ確率が高くなるように係数をごくわずかに修正する。この修正は勾配逆伝播によって計算され、数千のGPU上で数十億回、数週間から数ヶ月にわたって繰り返される。
その後、より短い第二の学習がモデルの振る舞いを方向づける。質問に答える、指示に従う、特定の要求を断る、口調を取る、といったことである。これは一部、人間による評価に基づいている。
学習後に残るもの
残るのは係数だけであり、これはモデルのパラメータとも呼ばれる。今日の大規模モデルでは1000億から1兆の数値である。テキストは図書館のようにモデルの中に並べられているのではない。それらはこれらの値を形作っただけである。モデルは非常に広く普及した一節を再生できる(部分的な記憶)が、本を「読み返す」ことはできない。
フェーズ2:推論、プロンプトから応答まで
注:
推論フェーズ:あなたの端末からクラウドへ、そして戻ってくる4つのゾーン。トークン番号と確率は例として示したものである。
図は4つの色分けされたゾーンに分かれており、各構成要素がどこにあるかを示している。ゾーン1と4(青)はあなたの端末上にあり、ゾーン2(オレンジ)は提供元のAIサービス、ゾーン3(緑)はクラウド、すなわちデータセンターである。
ゾーン1:あなたの端末
ブラウザまたはモバイルアプリは、あなたのテキストを受け取り、応答を表示するだけである。大規模モデルでは、係数が数百ギガバイトを占めるため、ここでAIの計算は行われない。小型のコンパクトなモデルだけが、最近のコンピュータやスマートフォン上でローカルに動作できる。
ゾーン2:提供元のAIサービス
あなたのテキストはインターネット(HTTPSプロトコル)を通って提供元のアプリケーションサーバーへと旅する。ゲートウェイがあなたの身元とクォータを確認し、セキュリティフィルタを適用し、その後完全なプロンプトを組み立てる。すなわち、システムの指示、会話の履歴、そしてあなたの最後の質問である。
この点は重要である。モデルは会話の記憶を一切保持しない。サービスが毎回の質問ごとに、コンテキストウィンドウの範囲内で、すなわちモデルが一度に読める最大トークン数の範囲内で、履歴全体をモデルに送り返している。このサービスが、そのアプリ、フィルタ、履歴とともに、一般に「AI」と呼ばれるものである。LLMはその一構成要素にすぎない。
ゾーン3:クラウドとそのGPU
完全なプロンプトはデータセンターの内部ネットワークを通じて、GPUまたはTPUを搭載したサーバーに伝送される。これらは膨大な行列積を並列に実行するために設計されたチップである。200GBから数テラバイトを占めるモデルは、複数のチップのメモリに分散される。ここに厳密な意味でのLLMがある。すなわち、モデルと結びついた推論プログラムである。
クラウド内:7つの計算ステップ
1. トークン化
テキストは、学習前に固定された辞書(いわゆるバイトペアエンコーディング)を用いてトークンに分割される。各トークンには番号が与えられる。頻出語は1つのトークンになり、稀な語は断片に分割される。語彙は約10万から20万トークンである。
2. 埋め込み(Embedding)
各トークン番号はベクトルに置き換えられる。数千の数値のリストである(最大のLlama 3モデルでは16,384)。単語の順序が意味を変えるため、位置情報が加えられる。これらのベクトル自体も学習中に学習された係数である。
3. トランスフォーマーブロック:アテンション
モデルの核心はトランスフォーマーブロックの積み重ねであり、2017年に提案されたアーキテクチャである。大規模モデルでは約80から130である。各ブロックで、アテンション機構が各トークンを先行するトークンと比較し、その相対的な重要性を計算する。「太陽系の中心には」では、「中心」と「太陽系」が続きの予測に大きく影響する。どこに注意を向けるかを決める行列(Q、K、V、O)は係数である。
4. トランスフォーマーブロック:フィードフォワードネットワーク
各ブロックにはフィードフォワードネットワークも含まれており、各ベクトルを活性化関数で区切られた2つの大きな行列積によって変換する。解釈可能性の研究は、これらの層が学習された連想の記憶として大部分機能することを示唆しているが、この解釈は研究上の仮説にとどまる。
これら2つのステップでは、ロジックは各ブロックで同一である。同じコードだからである。係数だけがブロックごとに異なる。
5. スコアと確率
最後のブロックの出力で、モデルは語彙の各トークンにスコア(ロジット)を割り当てる。ソフトマックス関数がこれらのスコアを合計100%になる確率に変換する。図の例では、「太陽」が92%、「月」が4%、「木星」が3%、その他すべてのトークンが合計1%となる。
6. サンプリング
トークンが常に最も確率の高いものとは限らない。温度と呼ばれる設定が確率を平らにしたり強調したりし、top-p法が抽選を最も確率の高い候補に限定する。温度が非常に低いと、応答はほぼ決定論的になる。高くなると、回ごとに変化する。だからこそ、同じ質問でも常に同じ応答が得られるとは限らない。
7. 生成ループ
選ばれたトークン、ここでは「太陽」がテキストに追加され、サイクル全体が次のトークンを計算するために再び始まる。モデルが特別な終了トークンを生成するまで続く。したがって300語の応答には、モデルを数百回連続して通過することが必要である。
ゾーン4:あなたの画面への帰還
トークンはすべてがまとめて待たれるのではない。それぞれが計算され次第返される(ストリーミング)。再びAIサービスを経由し、その後インターネットを通る。あなたの端末はそれらを到着順に表示し、これが応答が「ライブで書かれている」ような印象を与える。
ロジックと係数:モデルは実際に何を含んでいるのか?
しばしば3つのことが混同される。計算を実行するコード、結果を決める係数、そしてそれらの係数を固定するのに使われたデータである。以下の表はそれらを区別する。
| 要素 | 性質 | 起源 | 応答中に存在するか? |
|---|---|---|---|
| ロジック | コードとアーキテクチャ(アテンション、フィードフォワード、ソフトマックス) | 人間によって書かれた | はい、トークンごとに実行される |
| 係数 | 1000億〜1兆の数値 | 学習によって調整される | はい、GPUメモリから読み出され、決して変更されない |
| 学習データ | 書籍、ウェブページ、コード | 学習前に収集される | いいえ、係数に残る痕跡だけが残る |
| プロンプトと履歴 | 会話のテキスト | あなたとAIサービス | はい、毎回の質問で全体が読み直される |
各構成要素はどこにあるのか?
| 構成要素 | 位置 | 役割 |
|---|---|---|
| ブラウザまたはアプリ | あなたの端末 | プロンプトの入力、応答の表示 |
| ゲートウェイとオーケストレーション | AIサービスのサーバー | 認証、クォータ、フィルタ、プロンプトの組み立て |
| 推論プログラム | クラウドのGPUサーバー | 7つの計算ステップを実行する |
| モデル | GPUのメモリ | 確率を決定する係数を提供する |
| 学習データ | 応答回路の外 | 学習にのみ使われた |
図の限界
意図的に簡略化された図
図はいくつかの要素を省略している。各トークンに対して係数の一部だけが活性化されるエキスパート混合、各トークンで全体を再計算するのを避けるアテンション計算のキャッシュメモリ、ブロック内部の正規化と残差接続、AIサービスが呼び出せる外部ツール(ウェブ検索、コード実行)、画像や音声の処理である。提供元によっては、トークン化がGPUサーバーではなくAIサービス内で行われることもある。
なぜAIは自信たっぷりに間違えることができるのか
モデルは検証された事実ではなく、もっともらしいトークンを選ぶため、流暢だが虚偽の文を生成することがある。これをハルシネーションと呼ぶ。計算の中には、学習された事実ともっともらしい単語の連なりを区別するものは何もない。確率だけが問題である。したがって、外部ソースとの接続と人間による検証が依然として不可欠である。
覚えておくべきこと
LLMはまず第一に、行列を掛け合わせるプログラムであり、それに結びついたモデルは膨大な係数の表である。これらの係数は、膨大なテキストコーパスでの学習によって固定され、その後凍結された。各質問で、テキストはあなたの端末からデータセンターへと旅し、7つの計算ステップを通り、トークンを生成し、そして再び始まる。
この仕組みは、これらのシステムの力と限界の両方を説明する。それらはテキストをもっともらしく続けることに優れており、会話の独自の記憶も、真実の保証も持たない。各構成要素がどこにあるかを理解することは、計算、エネルギー、機密性の課題がどこにあるかを理解することでもある。
参考文献
FAQ:LLMの仕組み
トークンとは何か?
トークンとは、モデルが扱うテキストの単位である。頻出語、単語の一部、句読点、または数字である。日本語のテキストは通常、単語数よりもトークン数が多くなる。
LLMは自分が言っていることを理解しているのか?
機械的には、次のトークンの確率を計算している。しかしその内部表現は概念間の多くの関係を捉えており、これが理解の一形態をなすかどうかはAIと認知科学において議論が続いている。
モデルは私の会話から学習するのか?
会話中、係数は変更されない。モデルは凍結されている。ただしサービスは履歴を保存してあなたに返すことがあり、一部の提供元はポリシーとあなたの設定に応じて、将来のバージョンの準備に会話を利用することがある。
なぜGPUが不可欠なのか?
1つのトークンの計算は、膨大な行列積に要約される。GPUは数千の行列積を並列に実行し、係数を格納するための高速メモリを備えている。古典的なプロセッサではこの規模では不可能である。
自分のコンピュータでLLMを動かせるか?
はい、小規模なモデルなら可能で、しばしば量子化されている(係数がより低い精度で格納されている)。しかし最大級のモデルは複数のGPUを必要とし、個人用コンピュータの能力を超えている。
なぜ応答が回ごとに変わるのか?
サンプリングのステップが確率に従ってトークンをランダムに抽選するからである。温度が非常に低いと、応答は実行ごとにほぼ同一になる。
ハルシネーションとは何か?
もっともらしいが虚偽の応答である。モデルが、それが述べる事実を検証することなく、ありそうなトークンを選ぶために起こる。
 プロンプトから応答までの道のり:LLMの舞台裏
 トークン:大規模言語モデルの基本単位
 AIのさまざまな学習タイプ
 エージェンティックAI:マシンが自律性を獲得するとき
 AIができないこと
 人工知能と天文学:AIアシスタントの役割を理解する
 AIツールの選び方

 生成AI vs AGI:模倣の終わり、意識の始まりはどこか?
 人工ネットワーク vs 生物学的ネットワーク:2つのシステム、共通のアーキテクチャ
 人間の脳と人工知能:類似点と相違点
 AlphaGo vs AlphaGo Zero:人工知能の革命
 知的機械の次のステップ
 生物学的ニューロンから形式ニューロンへ:脳の単純化
 人工知能:巨大化の爆発
 人工知能が狂ったとき!
 機械はいかにして知能を得るのか
 人工知能:人類にとっての真の脅威か、それとも機会か?
 機械は人間と同様に言語を理解し、解釈し、生成する方法
 人工ニューラルネットワークの仕組み