


AIのさまざまな学習タイプ
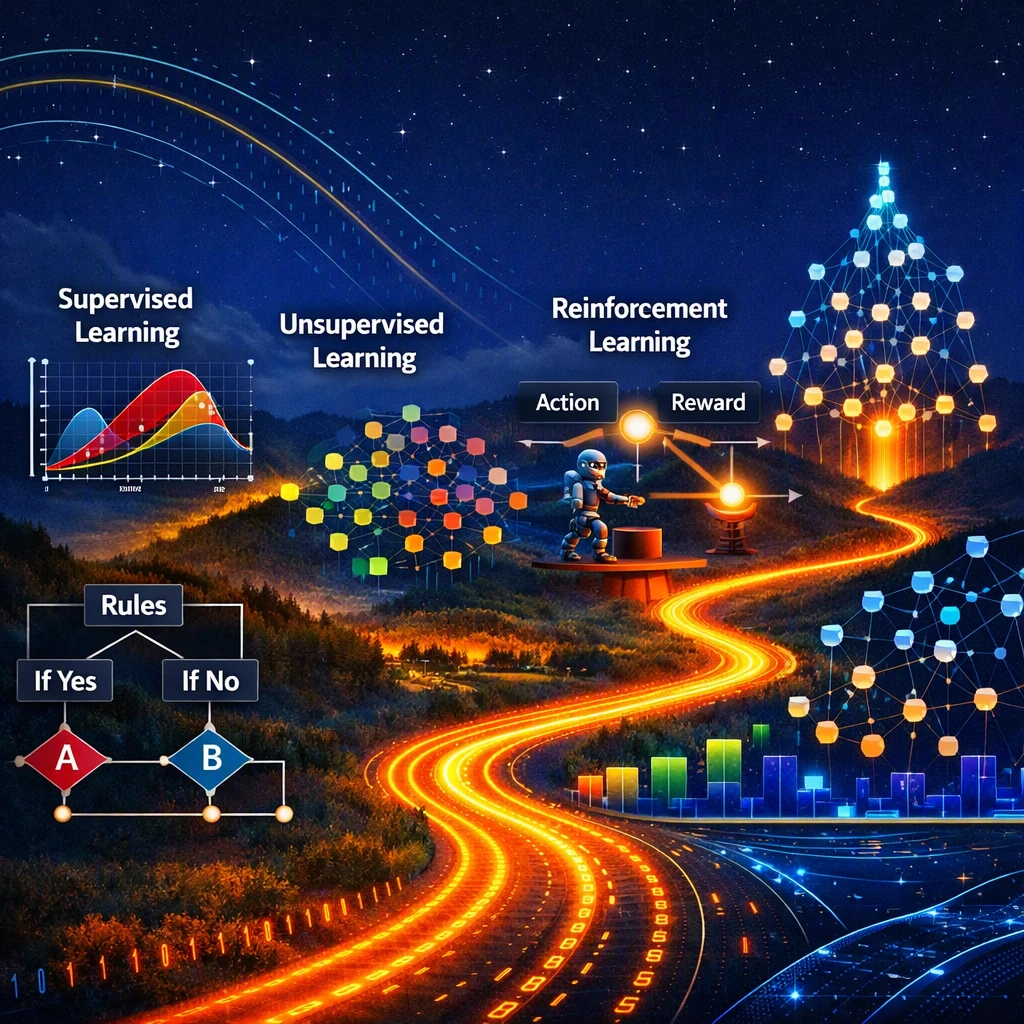
データ曲線、ニューラルネットワーク、決定図が主な学習タイプ(教師あり、教師なし、強化学習、深層学習)を表すAIの風景のイラスト。この画像は、単純なルールから、膨大な量のデータを処理できる複雑なアーキテクチャへと向かう道筋を示唆している。
画像出典:astronoo.com(新しいウィンドウ) — AI生成画像、パブリックドメイン。
科学的要約
このAstronooの記事は、人工知能で使用される主な学習タイプを、最も単純なものから最も複雑なものまで提示する。機械学習は、機械がデータからパラメータを調整してタスクの性能を向上させることができるという考えに基づいている。例が注釈付きである教師あり学習、隠れた構造を探す教師なし学習、報酬に基づく強化学習、データ自体が期待される答えを提供する自己教師あり学習が区別される。深層学習は方法というよりも、多層ニューラルネットワークというアーキテクチャのファミリーを指し、これまでの各アプローチと組み合わせることができる。
各タイプは具体的な例で示され、二つの補完的な視点を持つ:人間が行うこと(データを準備し、目的を定義する)と、機械が行うこと(パラメータを調整する)。一章は、ChatGPT、Claude、Geminiなどの大規模言語モデル(LLM)に捧げられており、これらは三つの successive な学習(自己教師あり、教師あり、強化学習)を組み合わせている。
なぜ学習タイプについて話すのか?
長い間、人間が詳細なルールを書き、機械がそれを実行していた。機械学習では、例が提供され、アルゴリズムがデータから自分自身でパラメータを調整する。
学習タイプは、データの提示方法と目的の定義方法によって区別される:ラベル付きの例(教師あり)、構造を探す生データ(教師なし)、報酬と罰則(強化学習)、またはデータ自体から引き出された質問と回答(自己教師あり)。深層学習は第五のタイプではない:それは多層ニューラルネットワークのアーキテクチャであり、これらの各アプローチに従って、しばしばそれらを組み合わせて訓練することができる。
こちらもおすすめ
宇宙の探検をさらに深めるためのテーマをご紹介します:
AIの主な学習タイプの概要
最も単純なものから最も複雑なものへ
以下の表は、主なAIの学習タイプを、最も単純なものから最も複雑なものまで提示し、具体的な例、人間の行為者が学習をどのように組織できるかという観点、そして機械がどのように進めるかの簡潔な説明を添えている。
| 学習タイプ | 具体的な例 | データと目的の人間による組織 | 機械の学習メカニズム |
|---|---|---|---|
| 教師あり学習 | すでにラベル付けされた画像(たとえば市民科学プロジェクトGalaxy Zooのボランティアによるもの)から、銀河の画像を渦巻き銀河または楕円銀河に分類する。 | 天文学者やボランティアが各画像の正しいクラスを示す、注釈付きデータセットの構築。 | モデルの予測とラベルの間の損失関数を、勾配降下法などのアルゴリズムによるパラメータ調整によって最小化する。 |
| 教師なし学習 | 何家族存在するかを事前に知らずに、数千の恒星スペクトルを家族にグループ化する。 | ラベルなしの大規模データベースの収集、比較する変数の選択、そして得られたグループの解釈。 | クラスタリングや次元削減アルゴリズムなどで、類似したオブジェクトを近づける隠れた構造の探索。 |
| 強化学習 | 自分自身と数百万回の対局を行って囲碁を学ぶ(AlphaGo、AlphaZero)。天文学では、同じ論理が望遠鏡の観測を計画するために研究されている。 | 報酬関数の定義(勝利に+1、敗北に−1;または有用な観測ごとに利益、空き時間ごとに罰則)。 | 環境との相互作用、試行錯誤、そして累積報酬を最大化するための行動方針の更新。探索と活用を交互に行う。 |
| 自己教師あり学習 | 文の最後の単語を隠し、モデルにそれを推測させる:「天の川は…銀河である」→「渦巻き」。 | テキスト、画像、音声の非常に大きなコーパスの収集。手動の注釈は不要。期待される答えがすでにデータの中にあるからである。 | モデルはデータのマスクされた部分または欠落部分を予測し、その予測を実際の内容と比較する。このタスクは有用な表現を学ぶことを強いる。 |
| 深層学習 | ケプラー望遠鏡の光度曲線から系外惑星を発見する。ニューラルネットワークはこうして、2017年末に発表された、その系の第八惑星であるKepler-90 iの識別に貢献した。 | 大規模データベースの組織化、適切なネットワークアーキテクチャの選択、性能基準の定義。 | 多数のニューロン層を通した情報の伝播、そして逆伝播による重みの調整により、ますます抽象的な特徴を抽出する。 |
| 転移学習 | すでに数百万の画像で訓練されたモデルを再利用して、新しい望遠鏡の画像を分析する、または汎用LLMを天文学の記事に特化させる。 | 事前訓練済みモデルの選択、そして新しいタスクに固有の小さなデータセットの構築。 | ソースタスクで学習したパラメータの保持、そしてはるかに少ないデータでターゲットタスクに微調整(ファインチューニング)する。 |
| オンライン学習 | 空のサーベイが新しいデータを送るにつれて、アラートフィルター(超新星、小惑星、変光天体)を継続的に更新する。 | 定期的な更新手順の定義と、リアルタイムで到着するデータストリームの監視。 | 新しい観測に応じたパラメータの漸進的な適応。モデルをゼロから再訓練することはない。 |
| 大規模言語モデル(LLM) | ブラックホールについての質問に答える対話アシスタント(ChatGPT、Claude、Gemini、Mistral…)。 | 巨大なテキストコーパスの構築、注釈者による良い回答の例の作成、そして人間の評価者による競合する回答のランク付け。 | 三つの successive な学習:次の単語の予測(自己教師あり)、模範回答の模倣(教師あり)、そして人間の選好スコアの最適化(強化学習)。 |
詳細な例:概念から実践へ
教師あり学習
教師あり学習では、各例に正しい答えを示すラベルが付けられている。古典的な例は画像分類である:機械に 銀河の画像が提供され、それぞれが渦巻きまたは楕円として注釈付けられている。目的は、モデルが新しい画像に対して正しいクラス(渦巻きまたは楕円)を予測できるようになることである。
- 人間の側:この学習の組織化は、注釈付きデータセットの構築、性能基準(正解率、精度)の定義、ラベルの品質の監視からなる。
- 機械の観点から:学習は、予測とラベルの間のギャップを測る損失関数を最小化することによって行われる。モデルのパラメータ(重み、バイアスを損失関数の最小化のために)を最適化手法(勾配降下法などのアルゴリズム)で調整する。
- 具体的な例:モデルは銀河の画像を受け取り、注釈付きの例が進むにつれてパラメータを調整することにより、渦巻きと楕円を自動的に区別することを学ぶ。
教師なし学習
教師なし学習では、データにはラベルが一切ない:機械は、どのカテゴリや構造を見つけるべきかを事前に知らない。目的は、データの中の自然なグルーピング、隠れたパターン、または関連する次元を発見することである。古典的な例は、事前の指示なしに恒星スペクトルを分析して、行動の家族を自動的に識別することである。
- 人間の側:この学習の組織化は、注釈なしの大規模データベースの収集、関連する変数の選択、探索的目的(グルーピング、異常検出、次元削減)の定義からなる。
- 機械の観点から:学習は、近くの点のグルーピングや主成分の抽出など、データの内部構造を探すアルゴリズムに依存しており、教師ありの損失関数はない。
- 具体的な例:モデルは数千の恒星スペクトルを分析し、類似したシグネチャを示すものを自動的にグループ化し、人間の介入なしに天体物理学的な家族を明らかにする。
強化学習
強化学習では、エージェントが環境と相互作用し、実行する行動に応じて報酬または罰則を受け取る。目的はラベルを予測することではなく、累積報酬を最大化する行動方針を学ぶことである。古典的な例は、観測時間を最適化するためにどのターゲットを観測するかを選択しなければならないロボット望遠鏡の制御である。
- 人間の側:この学習の組織化は、報酬関数の定義(行動の質の尺度)、環境のルールの指定、そしてエージェントが望ましくない戦略を開発しないことの確認からなる。
- 機械の観点から:エージェントはさまざまな行動を探索し、得られた報酬を観察し、累積報酬を最大化するためにその方針を更新する。これは逐次最適化アルゴリズム(Q学習や方針勾配法など)による。
- 具体的な例:エージェントは自動化された望遠鏡を制御し、試行を重ねるうちに、無駄な動きを最小化しながら最も興味深いターゲットを選択することを学び、観測の質と量を最適化する。
自己教師あり学習
自己教師あり学習では、機械は生データから自分自身でラベルを作成する。人間が提供する正しい答えを受け取る代わりに、モデルは入力の欠落部分またはマスクされた部分を予測しなければならない。このアプローチは、注釈なしの膨大なデータセットを活用することを可能にする。古典的な例は、言語表現を学ぶために科学テキスト中のマスクされた単語を予測することである。
- 人間の側:この学習の組織化は、注釈なしの大規模コーパスの準備、内部タスクの定義(単語をマスクする、シーケンスの続きを予測する)、そしてバイアスを避けるための使用データの品質管理からなる。
- 機械の観点から:モデルは、データ自体から生成された人工的なタスクを解くことによって学習する。たとえば、マスクされたトークンを予測したり、画像の一部を再構築したりすることで、有用な内部表現を抽出することができる。
- 具体的な例:モデルは、特定の単語がマスクされた科学テキストを受け取り、それらを推測することによって用語間の関係を捉えることを学び、その後、実際のタスクでの性能が向上する。
深層学習
深層学習では、機械はデータからますます複雑な特徴を抽出できる多層ニューラルネットワークを使用する。各層は情報を変換して、古典的な方法では見えないパターンを明らかにする。このアプローチは、画像、音声、テキストの処理に特に効果的である。一般的な例は、肉眼では区別が難しい構造を自動的に識別するための星雲の画像の分析である。
- 人間の側:この学習の組織化は、大規模な画像データベースの収集、適切なネットワークアーキテクチャ(CNN、トランスフォーマー)の選択、性能基準の定義、十分な計算リソースの確保からなる。
- 機械の観点から:ネットワークは、複数の層にわたって数百万のパラメータを調整することによって学習し、各層がより抽象的なパターンを抽出する。最適化は、最適化手法(勾配降下法など)による損失関数の最小化によって行われる。
- 具体的な例:ニューラルネットワークは星雲の画像を分析し、フィラメント、バブル、または放射ゾーンを自動的に認識することを学び、層ごとにパラメータを洗練させる。
注:
現代のニューラルネットワークでは、深さは中程度にとどまる:アーキテクチャは一般に約20層から数百層の間である。一方、ニューロンの総数は数百万、最も進んだモデルでは数億に達することもある。この違いが、ネットワークが数千の層を持たずに「深い」ことができる理由を説明している:層あたり数千のニューロンが、数十の層で乗算されることによって、巨大なサイズのモデルが得られるのである。
ケーススタディ:大規模言語モデルはどのように学ぶのか?
同じモデル、三つの successive な学習
大規模言語モデル(LLM)は、アプローチの組み合わせをよく示している。その訓練は複数の段階で行われ、各段階が異なるタイプの学習に対応している。これが、対話アシスタントが単なる単語予測器から、指示に従うことができる対話者へと変わることを可能にしている。
段階1:自己教師あり事前訓練
モデルは膨大な量のテキストを読み、次の単語(より正確には「トークン」)を予測することを学ぶ。「太陽は…型の恒星である」という文では、「黄色矮星」またはもっともらしい続きを推測しなければならない。人間がこれらのテキストに注釈を付けることはない:答えはテキスト自体である。これが自己教師あり学習であり、データと計算の面で最もコストのかかる段階である。 BERTのようなモデルは、トークンの自動マスキングを使用する:アルゴリズムが特定の単語をランダムに隠し、モデルがそれを予測しなければならない。
段階2:指示に対する教師あり微調整
事前訓練されたモデルはテキストを延長する方法を知っているが、必ずしも質問に答える方法を知っているわけではない。 人間の注釈者が指示と回答を書き、コンピュータツールがこれらのデータを訓練用に自動的に準備する。モデルはその後、これらの例を模倣するように調整される:これは、初期コーパスよりはるかに小さなデータセットに適用された教師あり学習である。
段階3:人間のフィードバックからの強化学習
回答の質を洗練するために、評価者にモデルの複数の回答をランク付けしてもらう。これらのランキングは、回答にスコアを割り当てる報酬モデルを訓練するために使用される。LLMはその後、高いスコアを得るように最適化される。これがRLHF(人間のフィードバックからの強化学習)の原理であり、特に2022年のInstructGPTで記述された。 それ以来、より単純な方法が提案されている。たとえば選好最適化では、モデルは人間によってより良いと判断された回答を優先することを学ぶ。一部の研究室では、自動的に検証可能な報酬 — たとえば数学問題の正しい解決やコンピュータテストの成功 — を使用して、「推論」モデルと呼ばれるものを訓練している。
「インコンテキスト学習」は?
質問に二、三の例を提供すると、モデルはタスクを「学習」したように見える:プロンプトに示されたパターンを再現する。実際には、これは一時的な適応である。モデルの内部パラメータは変更されず、会話が終了すると、重みには何も保存されない。したがって、モデルはその場で提供された例を活用するだけで、前述の段階の意味での真の学習は行わない。
たとえば、次のように書いた場合:
「2 + 3 = 5」
「4 + 6 = 10」
そして「7 + 8 = ?」と尋ねると、モデルは「15」と答える。それは足し算を行っているからではなく、このシーケンスがそれが見てきたテキストの中で統計的に最も確率が高いからである。それは単に馴染みのあるパターンを延長しているのであり、計算における持続的な能力を獲得しているわけではない。
総括:AIの学習の多面的な姿
以下の表は、さまざまなアプローチ、学習を導く信号、およびそれらの実用的な用途を要約している。
| 学習タイプ | 原理 | 信号の源 | 一般的な用途 |
|---|---|---|---|
| 教師あり学習 | 注釈付きの例からの予測。 | 人間が提供するラベル。 | ビジョン、パターン認識、分類、医療診断。 |
| 教師なし学習 | 隠れた構造の発見。 | データの内部特性。 | 探索、圧縮、セグメンテーション、異常検出。 |
| 強化学習 | 行動方針の最適化。 | 報酬と罰則。 | ロボティクス、ゲーム、逐次制御、LLMのアラインメント。 |
| 自己教師あり学習 | データのマスクされた部分または欠落部分の予測。 | 自動マスキングとデータ自体の構造。 | ほとんどの言語モデルと多くの画像モデルの事前訓練。 |
| 深層学習 | 複数の抽象化レベルでの特徴の抽出。 | 用途による:ラベル、データ自体、または報酬。 | 画像、音声、テキストの処理、タンパク質構造の予測。 |
| 大規模言語モデル(LLM) | 深層ネットワーク上での三つの学習の連鎖。 | 生テキスト、次に人間が注釈を付けた例、次に人間の選好の最適化。 | 対話アシスタント、翻訳、要約、プログラミング支援。 |
人間とそのツールの中心的役割
AIの学習は自律的なプロセスではない:それは人間とコンピュータツールの一式との緊密な協力に依存している。モデルは何を学ぶべきか、どのように学ぶべきかを自分で「発見」するのではない。各段階を組織し、方向づけ、制御するのは人間のチームであり、巨大な量のデータを処理できる技術インフラストラクチャに依拠している。
人間の中心的役割
人間は、モデルの設計と学習のすべての重要な段階に介入する。人間なしでは、AIは何を学ぶべきか、どのように、なぜかを知らない。
- 彼らはアーキテクチャ(トランスフォーマー、深層ネットワーク)を設計する。
- 彼らはデータを選択し、クリーンアップする。
- 彼らは教師あり学習のための指示と回答を書く。
- 彼らはモデルを導くために選好を表明する(RLHF、DPO)。
- 彼らは目的、指標、限界、セーフガードを定義する。
- 彼らは品質を評価し、逸脱を修正し、方法を調整する。
人間なしでは、モデルには枠組みがない:明示的な目標も、成功基準も、学習を方向づける信頼できる信号もない。
ツールの不可欠な役割
コンピュータツールは、大規模な学習を可能にする。それらは反復的なタスクを自動化し、データを構造化し、かなりのハードウェアリソースを活用する。それらなしでは、現代のAIの学習は物理的に不可能であろう。
- それらは自己教師あり学習のためにトークンを自動的にマスクする。
- それらはデータを準備する(フォーマット、検証、重複排除)。
- それらは作業を数千の注釈者に分配する。
- それらは特定の報酬を自動的に検証する(数学問題、コンピュータテスト)。
- それらは数百のGPUでモデルを訓練する。
- それらは大規模に人間の選好を最適化する。
データの量は多すぎ、モデルは重すぎ、タスクは多すぎて手動で管理できない。したがって、AIの学習は、人間の意図と判断が強力なコンピュータツールによって増幅された、ある種の同盟の結果である。
参考文献
- Wikipedia – 機械学習(新しいウィンドウ)
- Wikipedia – 教師あり学習(新しいウィンドウ)
- Wikipedia – 教師なし学習(新しいウィンドウ)
- Wikipedia – 強化学習(新しいウィンドウ)
- Wikipedia – 深層学習(新しいウィンドウ)
- LeCun, Y., Bengio, Y., Hinton, G. – 「Deep learning」、Nature、第521巻、2015年(新しいウィンドウ)
- Sutton, R. S., Barto, A. G. – 「Reinforcement Learning: An Introduction」、第2版、MIT Press、2018年(新しいウィンドウ)
- Ouyang, L. et al. – 「Training language models to follow instructions with human feedback」、NeurIPS、2022年(arXiv:2203.02155)(新しいウィンドウ)
- Devlin, J., Chang, M.-W., Lee, K., Toutanova, K. – 「BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding」、NAACL、2019年(arXiv:1810.04805)(新しいウィンドウ)
FAQ:AIの学習タイプについて知っておくべきこと
AIの主な学習タイプは何ですか?
AIの主な学習タイプは、教師あり学習、教師なし学習、強化学習、自己教師あり学習である。それぞれが、データを提示し、アルゴリズムの目的を定義する異なる方法に対応している。深層学習は同じ性質のタイプではない:それは多層ニューラルネットワークの使用を指し、これらの各アプローチに従って訓練することができる。
教師あり学習とは何ですか?
教師あり学習は、注釈付きの例でモデルを訓練することからなる。各入力は、正しい答えを示すラベルと関連付けられている。モデルは、損失関数を最小化することによって、新しい入力に対してこれらのラベルを予測することを学ぶ。
教師なし学習とは何ですか?
教師なし学習は、ラベルのないデータで動作する。アルゴリズムは、グループやパターンなどの隠れた構造を探す。クラスタリング、次元削減、異常検出に使用される。
強化学習とは何ですか?
強化学習は、環境と相互作用するエージェントを舞台にする。エージェントはその行動に応じて報酬または罰則を受け取り、累積報酬を最大化する方針を学ぶ。このアプローチは、ロボティクス、ゲーム、逐次制御で使用され、言語モデルを人間の選好に合わせるためにも使用される。
深層学習とは何ですか?
深層学習は、複雑なデータを処理するために多層ニューラルネットワークを使用する。これらのネットワークは、データの規則性を捉える内部表現を学ぶ。深層学習は、ビジョン、言語処理、パターン認識における最近の進歩の中心にある。
なぜ自己教師あり学習と呼ばれるのですか?
自己教師あり学習は、データ自体から内部タスクを作成する。たとえば、テキストの一部をマスクし、モデルにそれを予測するよう求める。このアプローチは、外部ラベルなしで有用な表現を学ぶことを可能にし、言語モデルにとって特に重要である。
ChatGPT、Claude、Geminiのようなモデルはどのように学ぶのですか?
大規模言語モデルは複数の段階で学ぶ。まず、膨大なテキストコーパスで次の単語を予測するように自己教師ありで事前訓練される。次に、人間が書いた指示と回答の例で教師ありで調整される。最後に、評価者によって確立された回答のランキングまたは自動的に検証可能な報酬から、強化学習によって洗練される。
機械はどのように学ぶのですか?
機械は、予測と参照信号の間のギャップを減らすために内部パラメータを調整することによって学ぶ。この信号は、ラベル、隠れた構造、報酬、または自己教師ありタスクであり得る。勾配降下法などの最適化アルゴリズムが、パラメータを更新して性能を漸進的に改善する。
 AIのさまざまな学習タイプ
 エージェンティックAI:マシンが自律性を獲得するとき
 AIができないこと
 人工知能と天文学:AIアシスタントの役割を理解する
 AIツールの選び方

 生成AI vs AGI:模倣の終わり、意識の始まりはどこか?
 人工ネットワーク vs 生物学的ネットワーク:2つのシステム、共通のアーキテクチャ
 人間の脳と人工知能:類似点と相違点
 AlphaGo vs AlphaGo Zero:人工知能の革命
 知的機械の次のステップ
 生物学的ニューロンから形式ニューロンへ:脳の単純化
 人工知能:巨大化の爆発
 人工知能が狂ったとき!
 機械はいかにして知能を得るのか
 人工知能:人類にとっての真の脅威か、それとも機会か?
 機械は人間と同様に言語を理解し、解釈し、生成する方法
 人工ニューラルネットワークの仕組み