


Les différents types d'apprentissage des IA
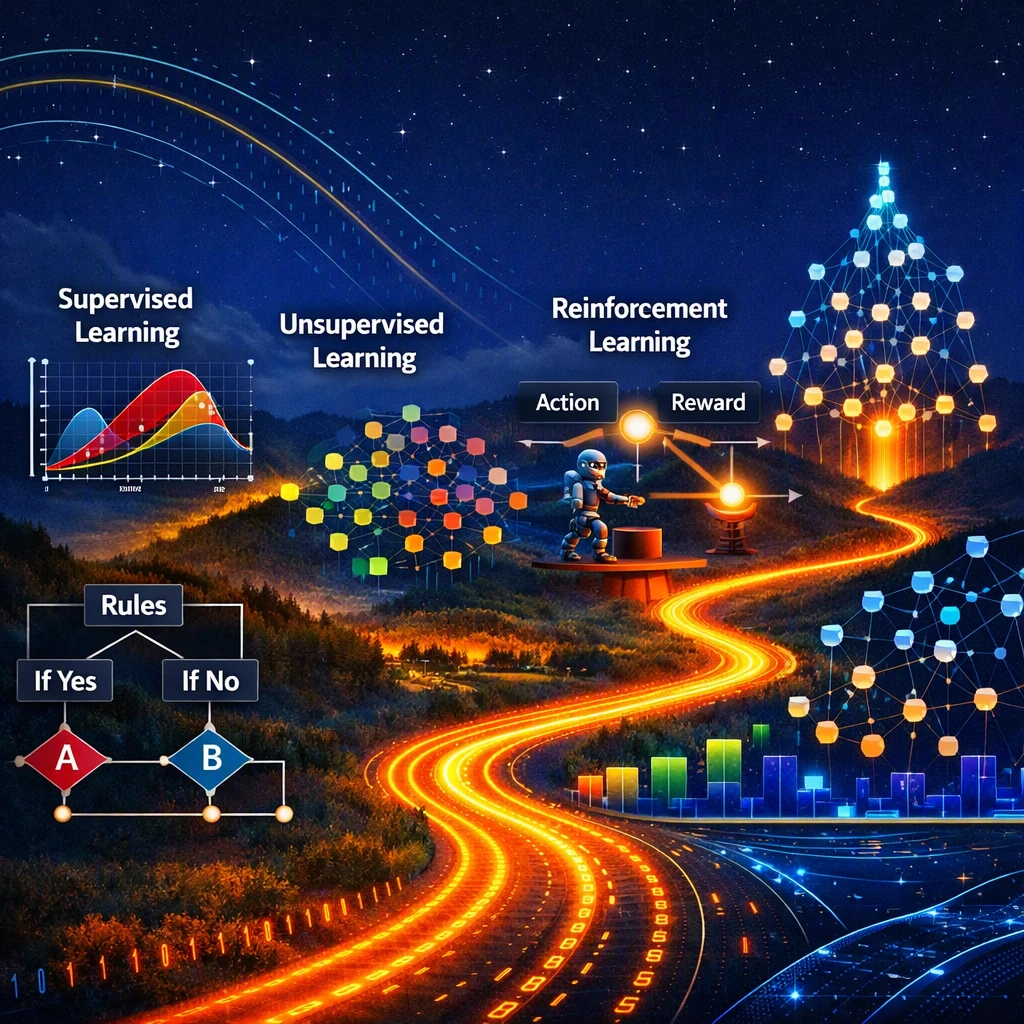
Illustration d'un paysage d'IA où des courbes de données, des réseaux de neurones et des diagrammes de décision représentent les principaux types d'apprentissage : supervisé, non supervisé, par renforcement et profond. L'image suggère un chemin qui va de règles simples vers des architectures complexes capables de traiter des volumes massifs de données.
Source image : astronoo.com (nouvelle fenêtre) — image générée par IA, domaine public.
Résumé scientifique
Cet article d'Astronoo présente les principaux types d'apprentissage utilisés en intelligence artificielle, du plus simple au plus complexe. L'apprentissage automatique repose sur l'idée qu'une machine peut ajuster ses paramètres à partir de données pour améliorer ses performances sur une tâche. On distingue l'apprentissage supervisé, où les exemples sont annotés, l'apprentissage non supervisé, qui cherche des structures cachées, l'apprentissage par renforcement, fondé sur des récompenses, et l'apprentissage auto-supervisé, où les données fournissent elles-mêmes la réponse attendue. L'apprentissage profond, lui, désigne moins une méthode qu'une famille d'architectures (les réseaux de neurones à plusieurs couches), qui peut être combinée avec chacune des approches précédentes.
Chaque type est illustré par un exemple concret, avec deux points de vue complémentaires : ce que font les humains (préparer les données, définir l'objectif) et ce que fait la machine (ajuster ses paramètres). Un chapitre est consacré aux grands modèles de langage (LLM), tels que ChatGPT, Claude ou Gemini, qui combinent trois apprentissages successifs : auto-supervisé, supervisé, puis par renforcement.
Pourquoi parler de types d'apprentissage ?
Pendant longtemps, un humain écrivait des règles détaillées que la machine exécutait. Avec l'apprentissage automatique, on fournit des exemples et l'algorithme ajuste lui-même ses paramètres à partir des données.
Les types d'apprentissage se distinguent par la façon de présenter les données et de définir l'objectif : des exemples étiquetés (supervisé), des données brutes où chercher des structures (non supervisé), des récompenses et des pénalités (par renforcement), ou des questions et des réponses tirées des données elles-mêmes (auto-supervisé). L'apprentissage profond, lui, n'est pas un cinquième type : c'est une architecture de réseaux de neurones à plusieurs couches, qui peut être entraînée selon chacune de ces approches, et souvent en les combinant.
À découvrir aussi
Poursuivez votre exploration de l'Univers avec ces sujets :
Panorama des principaux types d'apprentissage des IA
Du plus simple au plus complexe
Le tableau ci-dessous présente les principaux types d'apprentissage des IA, du plus simple au plus complexe, avec un exemple concret, une mise en perspective sur la manière dont un acteur humain peut organiser l'apprentissage, et une description synthétique de la façon dont la machine s'y prend.
| Type d'apprentissage | Exemple concret | Organisation humaine des données et objectifs | Mécanisme d'apprentissage de la machine |
|---|---|---|---|
| Apprentissage supervisé | Classer des images de galaxies en spirales ou elliptiques, à partir d'images déjà étiquetées (par exemple par les volontaires du projet de science participative Galaxy Zoo). | Constitution de jeux de données annotés, avec des astronomes ou des volontaires qui indiquent la classe correcte de chaque image. | Minimisation d'une fonction de perte entre les prédictions du modèle et les étiquettes, par ajustement des paramètres via des algorithmes comme la descente de gradient. |
| Apprentissage non supervisé | Regrouper des milliers de spectres d'étoiles en familles, sans savoir à l'avance combien de familles existent. | Collecte de grandes bases de données sans étiquettes, choix des variables à comparer, puis interprétation des groupes obtenus. | Recherche de structures cachées, par exemple avec des algorithmes de clustering ou de réduction de dimension qui rapprochent les objets similaires. |
| Apprentissage par renforcement | Apprendre à jouer au go en disputant des millions de parties contre soi-même (AlphaGo, AlphaZero). En astronomie, la même logique est étudiée pour planifier les observations d'un télescope. | Définition d'une fonction de récompense (+1 pour une victoire, −1 pour une défaite ; ou un gain pour chaque observation utile et une pénalité pour chaque temps mort). | Interaction avec un environnement, essais et erreurs, puis mise à jour d'une politique d'action pour maximiser la récompense cumulée, en alternant exploration et exploitation. |
| Apprentissage auto-supervisé | Cacher le dernier mot d'une phrase et demander au modèle de le deviner : « La Voie lactée est une galaxie … » → « spirale ». | Rassemblement de très grands corpus de textes, d'images ou de sons. Aucune annotation manuelle n'est nécessaire, car la réponse attendue est déjà dans les données. | Le modèle prédit une partie masquée ou manquante des données, puis compare sa prédiction au contenu réel. Cette tâche l'oblige à apprendre des représentations utiles. |
| Apprentissage profond | Repérer des exoplanètes dans les courbes de lumière du télescope Kepler. Un réseau de neurones a ainsi contribué à identifier Kepler-90 i, huitième planète de son système, annoncée fin 2017. | Organisation de grandes bases de données, choix d'une architecture de réseau adaptée et définition de critères de performance. | Propagation de l'information à travers de nombreuses couches de neurones, puis ajustement des poids par rétropropagation pour extraire des caractéristiques de plus en plus abstraites. |
| Apprentissage par transfert | Réutiliser un modèle déjà entraîné sur des millions d'images pour analyser celles d'un nouveau télescope, ou spécialiser un LLM généraliste sur des articles d'astronomie. | Choix d'un modèle préentraîné, puis constitution d'un petit jeu de données propre à la nouvelle tâche. | Conservation des paramètres appris sur une tâche source, puis ajustement fin (fine-tuning) sur la tâche cible avec beaucoup moins de données. |
| Apprentissage en ligne | Mettre à jour en continu un filtre d'alertes (supernovae, astéroïdes, objets variables) à mesure que les relevés du ciel envoient de nouvelles données. | Définition de procédures de mise à jour régulières et surveillance d'un flux de données qui arrive en temps réel. | Adaptation progressive des paramètres au fil des nouvelles observations, sans réentraîner le modèle depuis zéro. |
| Grands modèles de langage (LLM) | Un assistant conversationnel (ChatGPT, Claude, Gemini, Mistral…) qui répond à une question sur les trous noirs. | Constitution d'un corpus de textes gigantesque, rédaction d'exemples de bonnes réponses par des annotateurs, puis classement de réponses concurrentes par des évaluateurs humains. | Trois apprentissages successifs : prédiction du mot suivant (auto-supervisé), imitation de réponses modèles (supervisé), puis optimisation d'un score de préférence humaine (renforcement). |
Exemples détaillés : du concept à la pratique
Apprentissage supervisé
Dans l'apprentissage supervisé, chaque exemple est associé à une étiquette qui indique la réponse correcte. Un exemple classique est la classification d'images : on fournit à la machine des images de galaxies, chacune annotée comme spirale ou elliptique. L'objectif est que le modèle apprenne à prédire la bonne classe (spirale ou elliptique) pour de nouvelles images.
- Du côté humain : l'organisation de cet apprentissage consiste à constituer des jeux de données annotés, à définir des critères de performance (taux de bonnes réponses, précision) et à surveiller la qualité des étiquettes.
- Du point de vue de la machine : l'apprentissage se fait en minimisant une fonction de perte qui mesure l'écart entre les prédictions et les étiquettes, en ajustant les paramètres du modèle (poids, biais pour minimiser la fonction de perte) par des méthodes d'optimisation (algorithmes comme la descente de gradient).
- Exemple concret : un modèle reçoit des images de galaxies et apprend à distinguer automatiquement les spirales des elliptiques en ajustant ses paramètres au fil des exemples annotés.
Apprentissage non supervisé
Dans l'apprentissage non supervisé, les données ne possèdent aucune étiquette : la machine ne sait pas à l'avance quelles catégories ou structures elle doit trouver. L'objectif est de découvrir des regroupements naturels, des motifs cachés ou des dimensions pertinentes dans les données. Un exemple classique est l'analyse de spectres d'étoiles pour identifier automatiquement des familles de comportements sans indication préalable.
- Du côté humain : l'organisation de cet apprentissage consiste à collecter de grandes bases de données non annotées, à choisir des variables pertinentes et à définir des objectifs exploratoires (regroupements, détection d'anomalies, réduction de dimension).
- Du point de vue de la machine : l'apprentissage repose sur des algorithmes qui cherchent des structures internes aux données, comme le regroupement de points proches ou l'extraction de composantes principales, sans fonction de perte supervisée.
- Exemple concret : un modèle analyse des milliers de spectres d'étoiles et regroupe automatiquement celles qui présentent des signatures similaires, révélant des familles astrophysiques sans intervention humaine.
Apprentissage par renforcement
Dans l'apprentissage par renforcement, un agent interagit avec un environnement et reçoit des récompenses ou des pénalités selon les actions qu’il effectue. L’objectif n’est pas de prédire une étiquette, mais d’apprendre une politique d’action qui maximise la récompense cumulée. Un exemple classique est le contrôle d’un télescope robotisé qui doit choisir quelles cibles observer pour optimiser le temps d’observation.
- Du côté humain : l’organisation de cet apprentissage consiste à définir une fonction de récompense (mesure de la qualité des actions), à spécifier les règles de l’environnement et à s’assurer que l’agent ne développe pas des stratégies indésirables.
- Du point de vue de la machine : l’agent explore différentes actions, observe les récompenses obtenues et met à jour sa politique pour maximiser la récompense cumulée, grâce à des algorithmes d’optimisation séquentielle (comme Q‑learning ou les méthodes de gradient de politique).
- Exemple concret : un agent contrôle un télescope automatisé et apprend, au fil des essais, à sélectionner les cibles les plus intéressantes tout en minimisant les mouvements inutiles, afin d’optimiser la qualité et la quantité des observations.
Apprentissage auto-supervisé
Dans l'apprentissage auto-supervisé, la machine crée elle-même ses propres étiquettes à partir des données brutes. Au lieu de recevoir une réponse correcte fournie par un humain, le modèle doit prédire une partie manquante ou masquée de l’entrée. Cette approche permet d’exploiter de vastes ensembles de données non annotées. Un exemple classique est la prédiction de mots masqués dans des textes scientifiques pour apprendre des représentations du langage.
- Du côté humain : l’organisation de cet apprentissage consiste à préparer de grands corpus non annotés, à définir une tâche interne (masquer des mots, prédire la suite d’une séquence) et à contrôler la qualité des données utilisées pour éviter les biais.
- Du point de vue de la machine : le modèle apprend en résolvant une tâche artificielle générée à partir des données elles-mêmes, comme prédire des tokens masqués ou reconstruire une partie d’une image, ce qui lui permet d’extraire des représentations internes utiles.
- Exemple concret : un modèle reçoit des textes scientifiques où certains mots sont masqués et apprend, en les devinant, à capturer les relations entre termes, ce qui améliore ensuite ses performances sur des tâches réelles.
Apprentissage profond
Dans l'apprentissage profond, la machine utilise des réseaux de neurones à plusieurs couches capables d’extraire des caractéristiques de plus en plus complexes à partir des données. Chaque couche transforme l’information pour en révéler des motifs invisibles aux méthodes classiques. Cette approche est particulièrement efficace pour traiter des images, des sons ou des textes. Un exemple courant est l’analyse d’images de nébuleuses pour identifier automatiquement des structures difficiles à distinguer à l’œil nu.
- Du côté humain : l’organisation de cet apprentissage consiste à rassembler de grandes bases d’images, à choisir une architecture de réseau adaptée (CNN, transformeurs), à définir des critères de performance et à disposer de ressources de calcul suffisantes.
- Du point de vue de la machine : le réseau apprend en ajustant des millions de paramètres à travers plusieurs couches, chaque couche extrayant des motifs plus abstraits. L’optimisation se fait en minimisant une fonction de perte grâce à des méthodes d’optimisation (comme la descente de gradient).
- Exemple concret : un réseau de neurones analyse des images de nébuleuses et apprend à reconnaître automatiquement des filaments, des bulles ou des zones d’émission, en affinant ses paramètres couche après couche.
N.B. :
Dans les réseaux de neurones modernes, la profondeur reste modérée : les architectures comptent généralement entre une vingtaine et quelques centaines de couches. En revanche, le nombre total de neurones peut atteindre des millions, voire des centaines de millions dans les modèles les plus avancés. Cette différence explique qu’un réseau puisse être « profond » sans comporter des milliers de couches : ce sont les milliers de neurones par couche, multipliés par des dizaines de couches, qui donnent des modèles de taille colossale.
Cas d'école : comment apprend un grand modèle de langage ?
Un même modèle, trois apprentissages successifs
Les grands modèles de langage (LLM) illustrent bien la combinaison des approches. Leur entraînement se déroule en plusieurs étapes, chacune correspondant à un type d'apprentissage différent. C'est ce qui permet à un assistant conversationnel de passer d'un simple prédicteur de mots à un interlocuteur capable de suivre des consignes.
Étape 1 : le préentraînement auto-supervisé
Le modèle lit d'immenses quantités de textes et apprend à prédire le mot (plus exactement le « token ») suivant. Dans la phrase « Le Soleil est une étoile de type … », il doit deviner « naine jaune » ou une suite plausible. Aucun humain n'annote ces textes : la réponse est le texte lui-même. C'est de l'apprentissage auto-supervisé, et c'est l'étape la plus coûteuse en données et en calcul. Des modèles comme BERT utilisent un masquage automatique de tokens : un algorithme cache aléatoirement certains mots, que le modèle doit ensuite prédire.
Étape 2 : l'ajustement supervisé sur des instructions
Le modèle préentraîné sait prolonger un texte, mais pas forcément répondre à une question. Des annotateurs humains rédigent des consignes et des réponses, tandis que des outils informatiques préparent automatiquement ces données pour l’entraînement. Le modèle est ensuite ajusté pour imiter ces exemples : c’est de l’apprentissage supervisé appliqué à un jeu de données bien plus petit que le corpus initial.
Étape 3 : le renforcement à partir de retours humains
Pour affiner la qualité des réponses, on demande à des évaluateurs de classer plusieurs réponses du modèle. Ces classements servent à entraîner un modèle de récompense, qui attribue un score à une réponse. Le LLM est ensuite optimisé pour obtenir des scores élevés. C'est le principe du RLHF (apprentissage par renforcement à partir de retours humains), décrit notamment pour InstructGPT en 2022. Depuis, des méthodes plus simples ont été proposées, comme l’optimisation des préférences, où le modèle apprend à privilégier les réponses jugées meilleures par des humains. Certains laboratoires utilisent aussi des récompenses automatiquement vérifiables — par exemple la résolution correcte d’un problème de mathématiques ou la réussite de tests informatiques — pour entraîner des modèles dits « de raisonnement ».
Et l'« apprentissage en contexte » ?
Lorsque l’on fournit deux ou trois exemples dans une question, le modèle semble « apprendre » la tâche : il reproduit le schéma montré dans le prompt. En réalité, il s’agit d’une adaptation temporaire. Les paramètres internes du modèle ne sont pas modifiés et, une fois la conversation terminée, rien n’est conservé dans les poids. Le modèle ne fait donc qu’exploiter les exemples fournis sur le moment, sans véritable apprentissage au sens des étapes précédentes.
Par exemple, si l’on écrit :
« 2 + 3 = 5 »
« 4 + 6 = 10 »
et que l’on demande ensuite « 7 + 8 = ? », le modèle répond « 15 » non pas parce qu’il effectue une addition, mais parce que cette suite est statistiquement la plus probable dans les textes qu’il a vus. Il prolonge simplement un motif familier, sans acquérir de compétence durable en calcul.
Synthèse : les multiples visages de l'apprentissage des IA
Le tableau ci-dessous récapitule les différentes approches, le signal qui guide l'apprentissage et leurs usages pratiques.
| Type d'apprentissage | Principe | Source du signal | Usages courants |
|---|---|---|---|
| Apprentissage supervisé | Prédiction à partir d'exemples annotés. | Étiquettes fournies par des humains. | Vision, reconnaissance de formes, classification, diagnostic médical. |
| Apprentissage non supervisé | Découverte de structures cachées. | Propriétés internes des données. | Exploration, compression, segmentation et détection d'anomalies. |
| Apprentissage par renforcement | Optimisation d'une politique d'action. | Récompenses et pénalités. | Robotique, jeux, contrôle séquentiel, alignement des LLM. |
| Apprentissage auto-supervisé | Prédiction de parties masquées ou manquantes des données. | Masquage automatique et structure des données elles-mêmes. | Préentraînement de la plupart des modèles de langage et de nombreux modèles d'images. |
| Apprentissage profond | Extraction de caractéristiques à plusieurs niveaux d'abstraction. | Selon l'usage : étiquettes, données elles-mêmes ou récompenses. | Traitement d'images, de sons et de textes, prédiction de structures de protéines. |
| Grands modèles de langage (LLM) | Enchaînement de trois apprentissages sur un réseau profond. | Texte brut, puis exemples annotés par des humains, puis optimisation des préférences humaines. | Assistants conversationnels, traduction, résumé, aide à la programmation. |
Le rôle central de l’humain et de ses outils
L’apprentissage des IA n’est pas un processus autonome : il repose sur une collaboration étroite entre des humains et une panoplie d’outils informatiques. Les modèles ne « découvrent » pas seuls quoi apprendre, ni comment le faire. Ce sont des équipes humaines qui organisent, orientent et contrôlent chaque étape, en s’appuyant sur des infrastructures techniques capables de traiter des volumes de données gigantesques.
Le rôle central de l’humain
Les humains interviennent dans toutes les étapes critiques de la conception et de l’apprentissage des modèles. Sans eux, une IA ne sait ni quoi apprendre, ni comment, ni pourquoi.
- Ils conçoivent les architectures (transformers, réseaux profonds).
- Ils sélectionnent et nettoient les données.
- Ils rédigent les consignes et les réponses pour l’apprentissage supervisé.
- Ils expriment leurs préférences pour guider les modèles (RLHF, DPO).
- Ils définissent les objectifs, les métriques, les limites, les garde‑fous.
- Ils évaluent la qualité, corrigent les dérives, ajustent les méthodes.
Sans humains, un modèle ne dispose d’aucun cadre : il n’a ni but explicite, ni critères de réussite, ni signal fiable pour orienter son apprentissage.
Le rôle indispensable des outils
Les outils informatiques rendent possible l’apprentissage à grande échelle. Ils automatisent les tâches répétitives, structurent les données et exploitent des ressources matérielles considérables. Sans eux, l’apprentissage moderne des IA serait matériellement impossible.
- Ils masquent automatiquement des tokens pour l’auto‑supervisé.
- Ils préparent les données (formatage, validation, déduplication).
- Ils distribuent le travail à des milliers d’annotateurs.
- Ils vérifient automatiquement certaines récompenses (problèmes de mathématiques, tests informatiques).
- Ils entraînent les modèles sur des centaines de GPU.
- Ils optimisent les préférences humaines à grande échelle.
Les volumes de données sont trop grands, les modèles trop lourds et les tâches trop nombreuses pour être gérés manuellement. L’apprentissage des IA est donc le résultat d’une alliance : l’intention et le jugement humains, amplifiés par des outils informatiques puissants.
Références
- Wikipédia – Apprentissage automatique (nouvelle fenêtre)
- Wikipédia – Apprentissage supervisé (nouvelle fenêtre)
- Wikipédia – Apprentissage non supervisé (nouvelle fenêtre)
- Wikipédia – Apprentissage par renforcement (nouvelle fenêtre)
- Wikipédia – Apprentissage profond (nouvelle fenêtre)
- LeCun, Y., Bengio, Y., Hinton, G. – « Deep learning », Nature, vol. 521, 2015 (nouvelle fenêtre)
- Sutton, R. S., Barto, A. G. – « Reinforcement Learning: An Introduction », 2e éd., MIT Press, 2018 (nouvelle fenêtre)
- Ouyang, L. et al. – « Training language models to follow instructions with human feedback », NeurIPS, 2022 (arXiv:2203.02155) (nouvelle fenêtre)
- Devlin, J., Chang, M.-W., Lee, K., Toutanova, K. – « BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding », NAACL, 2019 (arXiv:1810.04805) (nouvelle fenêtre)
FAQ : Tout savoir sur les types d'apprentissage des IA
Quels sont les principaux types d'apprentissage des IA ?
Les principaux types d'apprentissage des IA sont l'apprentissage supervisé, l'apprentissage non supervisé, l'apprentissage par renforcement et l'apprentissage auto-supervisé. Chacun correspond à une manière différente de présenter les données et de définir l'objectif de l'algorithme. L'apprentissage profond n'est pas un type de même nature : il désigne l'usage de réseaux de neurones à plusieurs couches, qui peuvent être entraînés selon chacune de ces approches.
Qu'est-ce que l'apprentissage supervisé ?
L'apprentissage supervisé consiste à entraîner un modèle sur des exemples annotés. Chaque entrée est associée à une étiquette qui indique la réponse correcte. Le modèle apprend à prédire ces étiquettes pour de nouvelles entrées en minimisant une fonction de perte.
Qu'est-ce que l'apprentissage non supervisé ?
L'apprentissage non supervisé travaille sur des données sans étiquettes. L'algorithme cherche des structures cachées, comme des groupes ou des motifs. Il est utilisé pour le clustering, la réduction de dimension et la détection d'anomalies.
Qu'est-ce que l'apprentissage par renforcement ?
L'apprentissage par renforcement met en scène un agent qui interagit avec un environnement. L'agent reçoit des récompenses ou des pénalités en fonction de ses actions et apprend une politique qui maximise la récompense cumulée. Cette approche est utilisée en robotique, en jeux et en contrôle séquentiel, ainsi que pour aligner les modèles de langage sur les préférences humaines.
Qu'est-ce que l'apprentissage profond ?
L'apprentissage profond utilise des réseaux de neurones à plusieurs couches pour traiter des données complexes. Ces réseaux apprennent des représentations internes qui capturent des régularités dans les données. L'apprentissage profond est au cœur des progrès récents en vision, en traitement du langage et en reconnaissance de formes.
Pourquoi parle-t-on d'apprentissage auto-supervisé ?
L'apprentissage auto-supervisé crée des tâches internes à partir des données elles-mêmes. Par exemple, on masque des parties d'un texte et on demande au modèle de les prédire. Cette approche permet d'apprendre des représentations utiles sans étiquettes externes, ce qui est particulièrement important pour les modèles de langage.
Comment apprend un modèle comme ChatGPT, Claude ou Gemini ?
Un grand modèle de langage apprend en plusieurs étapes. Il est d'abord préentraîné de manière auto-supervisée à prédire le mot suivant sur d'immenses corpus de textes. Il est ensuite ajusté de manière supervisée sur des exemples de consignes et de réponses rédigés par des humains. Enfin, il est affiné par apprentissage par renforcement, à partir de classements de réponses établis par des évaluateurs ou de récompenses vérifiables automatiquement.
Comment les machines s'y prennent-elles pour apprendre ?
Les machines apprennent en ajustant des paramètres internes pour réduire un écart entre leurs prédictions et un signal de référence. Ce signal peut être une étiquette, une structure cachée, une récompense ou une tâche auto-supervisée. Les algorithmes d'optimisation, comme la descente de gradient, mettent à jour les paramètres pour améliorer progressivement les performances.
 Les différents types d'apprentissage des IA
 IA Agentique : Quand les machines deviennent autonomes
 Ce que les IA ne savent pas faire
 Intelligence artificielle et astronomie : Comprendre le rôle des assistants IA
 Outils d’intelligence artificielle : comment choisir ?

 IA Générative vs AGI: Où s’arrête l’imitation, où commence la conscience?
 Réseaux artificiels vs réseaux biologiques: Deux systèmes, une architecture commune
 Cerveau Humain et Intelligences Artificielles: Similitudes et Différences
 AlphaGo contre AlphaGo Zero: Une Révolution dans l'Intelligence Artificielle
 La prochaine étape des machines intelligentes
 Du Neurone Biologique au Neurone Formel: Simplification du Cerveau
 Intelligence artificielle: l'explosion du gigantisme
 Quand l'intelligence artificielle devient folle!
 Comment les machines deviennent intelligentes
 Intelligence artificielle : menace réelle ou opportunité pour l'humanité ?
 Comment les machines comprennent, interprètent et génèrent un langage de manière similaire à celle des humains?
 Comment fonctionne un réseau de neurones artificiels?