


Die verschiedenen Lernarten der KI
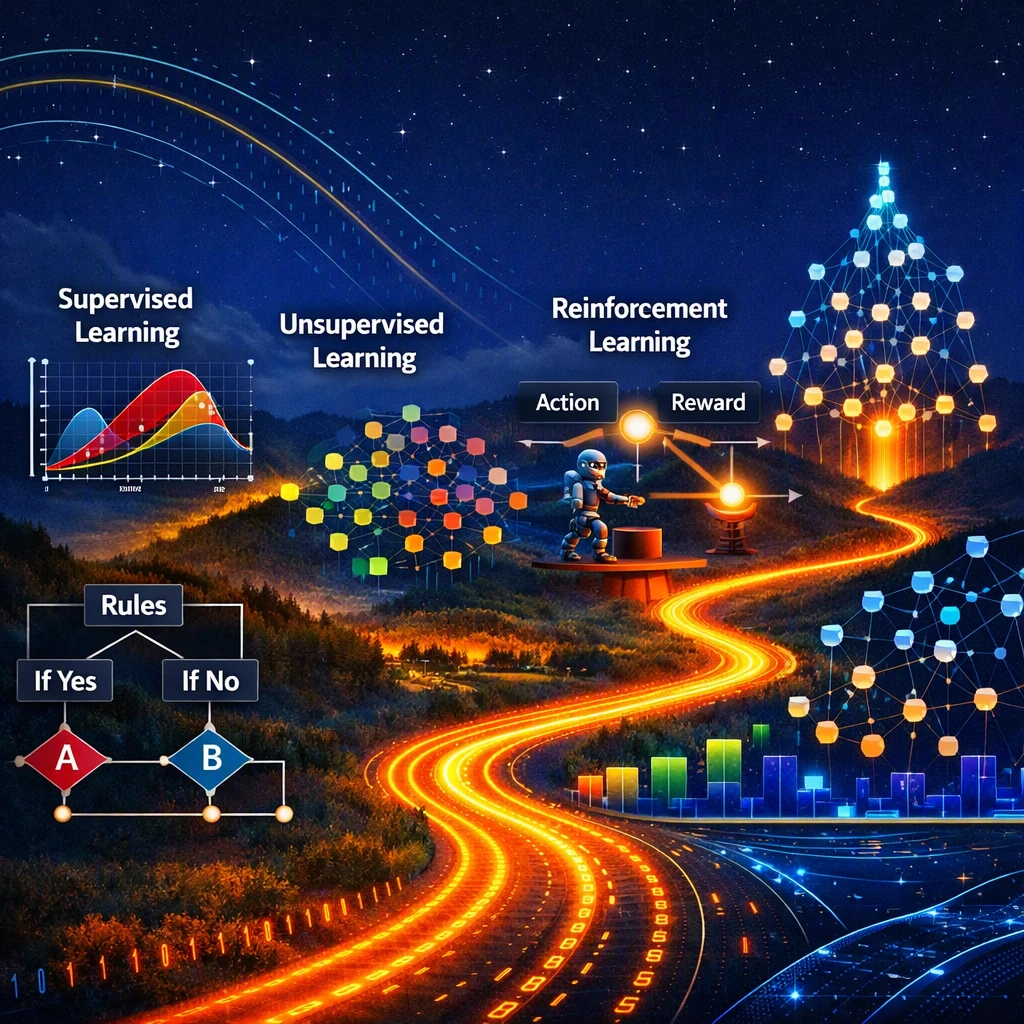
Illustration einer KI-Landschaft, in der Datenkurven, neuronale Netze und Entscheidungsdiagramme die wichtigsten Lernarten darstellen: überwacht, unüberwacht, verstärkend und tief. Das Bild deutet einen Weg von einfachen Regeln zu komplexen Architekturen an, die massenhafte Datenmengen verarbeiten können.
Bildquelle: astronoo.com (neues Fenster) — KI-generiertes Bild, gemeinfrei.
Wissenschaftliche Zusammenfassung
Dieser Artikel von Astronoo stellt die wichtigsten Lernarten der künstlichen Intelligenz vor, von der einfachsten zur komplexesten. Maschinelles Lernen beruht auf der Idee, dass eine Maschine ihre Parameter aus Daten anpassen kann, um ihre Leistung bei einer Aufgabe zu verbessern. Man unterscheidet überwachtes Lernen, bei dem die Beispiele annotiert sind, unüberwachtes Lernen, das nach verborgenen Strukturen sucht, verstärkendes Lernen, das auf Belohnungen basiert, und selbstüberwachtes Lernen, bei dem die Daten selbst die erwartete Antwort liefern. Tiefes Lernen bezeichnet weniger eine Methode als eine Familie von Architekturen (mehrschichtige neuronale Netze), die mit jedem der vorherigen Ansätze kombiniert werden kann.
Jede Art wird durch ein konkretes Beispiel veranschaulicht, mit zwei komplementären Blickwinkeln: was die Menschen tun (Daten vorbereiten, Ziel definieren) und was die Maschine tut (ihre Parameter anpassen). Ein Kapitel ist den großen Sprachmodellen (LLM) gewidmet, wie ChatGPT, Claude oder Gemini, die drei aufeinanderfolgende Lernarten kombinieren: selbstüberwacht, überwacht und dann verstärkend.
Warum von Lernarten sprechen?
Lange Zeit schrieb ein Mensch detaillierte Regeln, die die Maschine ausführte. Beim maschinellen Lernen werden Beispiele bereitgestellt, und der Algorithmus passt seine Parameter selbst aus den Daten an.
Die Lernarten unterscheiden sich darin, wie die Daten präsentiert und das Ziel definiert werden: etikettierte Beispiele (überwacht), Rohdaten, in denen Strukturen gesucht werden (unüberwacht), Belohnungen und Bestrafungen (verstärkend) oder Fragen und Antworten, die aus den Daten selbst stammen (selbstüberwacht). Tiefes Lernen ist keine fünfte Art: Es ist eine Architektur mehrschichtiger neuronaler Netze, die nach jedem dieser Ansätze trainiert werden kann, und oft durch deren Kombination.
Auch interessant
Setzen Sie Ihre Erkundung des Universums mit diesen Themen fort:
Überblick über die wichtigsten Lernarten der KI
Von der einfachsten zur komplexesten
Die folgende Tabelle stellt die wichtigsten Lernarten der KI vor, von der einfachsten zur komplexesten, mit einem konkreten Beispiel, einer Perspektive darauf, wie ein menschlicher Akteur das Lernen organisieren kann, und einer synthetischen Beschreibung, wie die Maschine vorgeht.
| Lernart | Konkretes Beispiel | Menschliche Organisation der Daten und Ziele | Lernmechanismus der Maschine |
|---|---|---|---|
| Überwachtes Lernen | Galaxienbilder in Spiralen oder Ellipsen klassifizieren, aus bereits etikettierten Bildern (zum Beispiel von Freiwilligen des Citizen-Science-Projekts Galaxy Zoo). | Bildung annotierter Datensätze, wobei Astronomen oder Freiwillige die korrekte Klasse jedes Bildes angeben. | Minimierung einer Verlustfunktion zwischen den Vorhersagen des Modells und den Etiketten, durch Anpassung der Parameter über Algorithmen wie den Gradientenabstieg. |
| Unüberwachtes Lernen | Tausende Sternspektren in Familien gruppieren, ohne im Voraus zu wissen, wie viele Familien existieren. | Sammlung großer Datenbanken ohne Etiketten, Auswahl der zu vergleichenden Variablen, dann Interpretation der erhaltenen Gruppen. | Suche nach verborgenen Strukturen, zum Beispiel mit Clustering- oder Dimensionsreduktionsalgorithmen, die ähnliche Objekte zusammenbringen. |
| Verstärkendes Lernen | Go spielen lernen, indem Millionen von Partien gegen sich selbst gespielt werden (AlphaGo, AlphaZero). In der Astronomie wird dieselbe Logik untersucht, um die Beobachtungen eines Teleskops zu planen. | Definition einer Belohnungsfunktion (+1 für einen Sieg, −1 für eine Niederlage; oder ein Gewinn für jede nützliche Beobachtung und eine Strafe für jede Leerlaufzeit). | Interaktion mit einer Umgebung, Versuch und Irrtum, dann Aktualisierung einer Aktionspolitik zur Maximierung der kumulierten Belohnung, abwechselnd Exploration und Ausbeutung. |
| Selbstüberwachtes Lernen | Das letzte Wort eines Satzes verbergen und das Modell bitten, es zu erraten: „Die Milchstraße ist eine … Galaxie" → „Spiralgalaxie". | Sammlung sehr großer Korpora von Texten, Bildern oder Tönen. Keine manuelle Annotation ist erforderlich, da die erwartete Antwort bereits in den Daten enthalten ist. | Das Modell sagt einen maskierten oder fehlenden Teil der Daten voraus und vergleicht dann seine Vorhersage mit dem tatsächlichen Inhalt. Diese Aufgabe zwingt es, nützliche Repräsentationen zu lernen. |
| Tiefes Lernen | Exoplaneten in den Lichtkurven des Kepler-Teleskops aufspüren. Ein neuronales Netz hat so dazu beigetragen, Kepler-90 i zu identifizieren, den achten Planeten seines Systems, der Ende 2017 angekündigt wurde. | Organisation großer Datenbanken, Auswahl einer geeigneten Netzwerkarchitektur und Definition von Leistungskriterien. | Weitergabe der Information durch viele Neuronschichten, dann Anpassung der Gewichte durch Backpropagation, um zunehmend abstraktere Merkmale zu extrahieren. |
| Transferlernen | Ein bereits auf Millionen von Bildern trainiertes Modell wiederverwenden, um die eines neuen Teleskops zu analysieren, oder ein generalistisches LLM auf Astronomieartikel spezialisieren. | Auswahl eines vortrainierten Modells, dann Bildung eines kleinen, für die neue Aufgabe spezifischen Datensatzes. | Beibehaltung der auf einer Quellaufgabe gelernten Parameter, dann Feinabstimmung (Fine-Tuning) auf der Zielaufgabe mit viel weniger Daten. |
| Online-Lernen | Einen Alarmfilter (Supernovae, Asteroiden, veränderliche Objekte) kontinuierlich aktualisieren, während die Himmelsdurchmusterungen neue Daten senden. | Definition regelmäßiger Aktualisierungsverfahren und Überwachung eines Datenstroms, der in Echtzeit eintrifft. | Progressive Anpassung der Parameter im Laufe der neuen Beobachtungen, ohne das Modell von Grund auf neu zu trainieren. |
| Große Sprachmodelle (LLM) | Ein dialogorientierter Assistent (ChatGPT, Claude, Gemini, Mistral…), der eine Frage zu Schwarzen Löchern beantwortet. | Bildung eines gigantischen Textkorpus, Verfassen von Beispielen guter Antworten durch Annotatoren, dann Bewertung konkurrierender Antworten durch menschliche Evaluatoren. | Drei aufeinanderfolgende Lernarten: Vorhersage des nächsten Wortes (selbstüberwacht), Nachahmung von Musterantworten (überwacht), dann Optimierung eines menschlichen Präferenzscores (verstärkend). |
Detaillierte Beispiele: vom Konzept zur Praxis
Überwachtes Lernen
Beim überwachten Lernen ist jedes Beispiel mit einem Etikett verbunden, das die richtige Antwort angibt. Ein klassisches Beispiel ist die Bildklassifizierung: Der Maschine werden Bilder von Galaxien bereitgestellt, jedes als Spirale oder Ellipse annotiert. Das Ziel ist, dass das Modell lernt, die richtige Klasse (Spirale oder Ellipse) für neue Bilder vorherzusagen.
- Auf der menschlichen Seite: Die Organisation dieses Lernens besteht darin, annotierte Datensätze zu bilden, Leistungskriterien zu definieren (Trefferquote, Präzision) und die Qualität der Etiketten zu überwachen.
- Aus Sicht der Maschine: Das Lernen erfolgt durch Minimierung einer Verlustfunktion, die die Abweichung zwischen Vorhersagen und Etiketten misst, indem die Parameter des Modells (Gewichte, Bias zur Minimierung der Verlustfunktion) durch Optimierungsmethoden (Algorithmen wie der Gradientenabstieg) angepasst werden.
- Konkretes Beispiel: Ein Modell erhält Bilder von Galaxien und lernt, Spiralen automatisch von Ellipsen zu unterscheiden, indem es seine Parameter im Laufe der annotierten Beispiele anpasst.
Unüberwachtes Lernen
Beim unüberwachten Lernen besitzen die Daten kein Etikett: Die Maschine weiß nicht im Voraus, welche Kategorien oder Strukturen sie finden soll. Das Ziel ist, natürliche Gruppierungen, verborgene Muster oder relevante Dimensionen in den Daten zu entdecken. Ein klassisches Beispiel ist die Analyse von Sternspektren, um automatisch Verhaltensfamilien ohne vorherige Angabe zu identifizieren.
- Auf der menschlichen Seite: Die Organisation dieses Lernens besteht darin, große nicht annotierte Datenbanken zu sammeln, relevante Variablen auszuwählen und explorative Ziele zu definieren (Gruppierungen, Anomalieerkennung, Dimensionsreduktion).
- Aus Sicht der Maschine: Das Lernen beruht auf Algorithmen, die nach internen Strukturen in den Daten suchen, wie der Gruppierung naher Punkte oder der Extraktion von Hauptkomponenten, ohne überwachte Verlustfunktion.
- Konkretes Beispiel: Ein Modell analysiert Tausende von Sternspektren und gruppiert automatisch diejenigen, die ähnliche Signaturen aufweisen, und offenbart astrophysikalische Familien ohne menschliches Eingreifen.
Verstärkendes Lernen
Beim verstärkenden Lernen interagiert ein Agent mit einer Umgebung und erhält Belohnungen oder Bestrafungen je nach den ausgeführten Aktionen. Das Ziel ist nicht, ein Etikett vorherzusagen, sondern eine Aktionspolitik zu lernen, die die kumulierte Belohnung maximiert. Ein klassisches Beispiel ist die Steuerung eines robotisierten Teleskops, das auswählen muss, welche Ziele beobachtet werden, um die Beobachtungszeit zu optimieren.
- Auf der menschlichen Seite: Die Organisation dieses Lernens besteht darin, eine Belohnungsfunktion zu definieren (Maß für die Qualität der Aktionen), die Regeln der Umgebung festzulegen und sicherzustellen, dass der Agent keine unerwünschten Strategien entwickelt.
- Aus Sicht der Maschine: Der Agent erkundet verschiedene Aktionen, beobachtet die erhaltenen Belohnungen und aktualisiert seine Politik zur Maximierung der kumulierten Belohnung, dank sequenzieller Optimierungsalgorithmen (wie Q-Learning oder Policy-Gradient-Methoden).
- Konkretes Beispiel: Ein Agent steuert ein automatisiertes Teleskop und lernt im Laufe der Versuche, die interessantesten Ziele auszuwählen und unnötige Bewegungen zu minimieren, um die Qualität und Quantität der Beobachtungen zu optimieren.
Selbstüberwachtes Lernen
Beim selbstüberwachten Lernen erstellt die Maschine ihre eigenen Etiketten aus den Rohdaten. Anstatt eine von einem Menschen bereitgestellte richtige Antwort zu erhalten, muss das Modell einen fehlenden oder maskierten Teil der Eingabe vorhersagen. Dieser Ansatz ermöglicht es, riesige Mengen nicht annotierter Daten zu nutzen. Ein klassisches Beispiel ist die Vorhersage von maskierten Wörtern in wissenschaftlichen Texten, um Sprachrepräsentationen zu lernen.
- Auf der menschlichen Seite: Die Organisation dieses Lernens besteht darin, große nicht annotierte Korpora vorzubereiten, eine interne Aufgabe zu definieren (Wörter maskieren, die Fortsetzung einer Sequenz vorhersagen) und die Qualität der verwendeten Daten zu kontrollieren, um Verzerrungen zu vermeiden.
- Aus Sicht der Maschine: Das Modell lernt, indem es eine künstliche Aufgabe löst, die aus den Daten selbst generiert wird, wie die Vorhersage maskierter Tokens oder die Rekonstruktion eines Teils eines Bildes, was es ihm ermöglicht, nützliche interne Repräsentationen zu extrahieren.
- Konkretes Beispiel: Ein Modell erhält wissenschaftliche Texte, in denen bestimmte Wörter maskiert sind, und lernt, indem es sie errät, die Beziehungen zwischen Begriffen zu erfassen, was anschließend seine Leistung bei realen Aufgaben verbessert.
Tiefes Lernen
Beim tiefen Lernen verwendet die Maschine mehrschichtige neuronale Netze, die zunehmend komplexere Merkmale aus den Daten extrahieren können. Jede Schicht transformiert die Information, um Muster zu offenbaren, die für klassische Methoden unsichtbar sind. Dieser Ansatz ist besonders effektiv für die Verarbeitung von Bildern, Tönen oder Texten. Ein häufiges Beispiel ist die Analyse von Bildern von Nebeln, um automatisch Strukturen zu identifizieren, die mit bloßem Auge schwer zu unterscheiden sind.
- Auf der menschlichen Seite: Die Organisation dieses Lernens besteht darin, große Bilddatenbanken zu sammeln, eine geeignete Netzwerkarchitektur auszuwählen (CNN, Transformer), Leistungskriterien zu definieren und über ausreichende Rechenressourcen zu verfügen.
- Aus Sicht der Maschine: Das Netzwerk lernt, indem es Millionen von Parametern über mehrere Schichten anpasst, wobei jede Schicht abstraktere Muster extrahiert. Die Optimierung erfolgt durch Minimierung einer Verlustfunktion mithilfe von Optimierungsmethoden (wie dem Gradientenabstieg).
- Konkretes Beispiel: Ein neuronales Netz analysiert Bilder von Nebeln und lernt, automatisch Filamente, Blasen oder Emissionszonen zu erkennen, indem es seine Parameter Schicht für Schicht verfeinert.
N.B.:
In modernen neuronalen Netzen bleibt die Tiefe moderat: Die Architekturen zählen im Allgemeinen zwischen etwa zwanzig und einigen hundert Schichten. Dagegen kann die Gesamtzahl der Neuronen Millionen erreichen, ja sogar Hunderte Millionen in den fortschrittlichsten Modellen. Dieser Unterschied erklärt, warum ein Netzwerk „tief" sein kann, ohne Tausende von Schichten zu haben: Es sind die Tausenden von Neuronen pro Schicht, multipliziert mit Dutzenden von Schichten, die Modelle von kolossaler Größe ergeben.
Fallstudie: Wie lernt ein großes Sprachmodell?
Ein und dasselbe Modell, drei aufeinanderfolgende Lernarten
Die großen Sprachmodelle (LLM) veranschaulichen gut die Kombination der Ansätze. Ihr Training verläuft in mehreren Etappen, von denen jede einer anderen Lernart entspricht. Das ist es, was einem dialogorientierten Assistenten ermöglicht, von einem einfachen Wortvorhersager zu einem Gesprächspartner zu werden, der Anweisungen befolgen kann.
Etappe 1: das selbstüberwachte Vortraining
Das Modell liest immensen Mengen von Texten und lernt, das nächste Wort (genauer das „Token") vorherzusagen. In dem Satz „Die Sonne ist ein Stern vom Typ …" muss es „Gelber Zwerg" oder eine plausible Fortsetzung erraten. Kein Mensch annotiert diese Texte: Die Antwort ist der Text selbst. Das ist selbstüberwachtes Lernen, und es ist die kostspieligste Etappe in Bezug auf Daten und Berechnung. Modelle wie BERT verwenden eine automatische Token-Maskierung: Ein Algorithmus verbirgt zufällig bestimmte Wörter, die das Modell dann vorhersagen muss.
Etappe 2: die überwachte Feinabstimmung auf Anweisungen
Das vortrainierte Modell weiß, einen Text fortzusetzen, aber nicht unbedingt, eine Frage zu beantworten. Menschliche Annotatoren verfassen Anweisungen und Antworten, während Computertools diese Daten automatisch für das Training vorbereiten. Das Modell wird dann angepasst, um diese Beispiele nachzuahmen: Das ist überwachtes Lernen, angewandt auf einen viel kleineren Datensatz als der ursprüngliche Korpus.
Etappe 3: die Verstärkung aus menschlichem Feedback
Um die Qualität der Antworten zu verfeinern, werden Evaluatoren gebeten, mehrere Antworten des Modells zu bewerten. Diese Bewertungen dienen dazu, ein Belohnungsmodell zu trainieren, das einer Antwort einen Score zuweist. Das LLM wird dann optimiert, um hohe Scores zu erhalten. Das ist das Prinzip des RLHF (verstärkendes Lernen aus menschlichem Feedback), das insbesondere für InstructGPT im Jahr 2022 beschrieben wurde. Seitdem wurden einfachere Methoden vorgeschlagen, wie die Präferenzoptimierung, bei der das Modell lernt, Antworten zu bevorzugen, die von Menschen als besser beurteilt werden. Einige Labore verwenden auch automatisch überprüfbare Belohnungen — zum Beispiel die korrekte Lösung eines Mathematikproblems oder den Erfolg von Computertests —, um sogenannte „Reasoning"-Modelle zu trainieren.
Und das „In-Context-Lernen"?
Wenn zwei oder drei Beispiele in einer Frage bereitgestellt werden, scheint das Modell die Aufgabe zu „lernen": Es reproduziert das im Prompt gezeigte Muster. In Wirklichkeit handelt es sich um eine vorübergehende Anpassung. Die internen Parameter des Modells werden nicht verändert, und sobald das Gespräch beendet ist, bleibt nichts in den Gewichten erhalten. Das Modell nutzt also nur die im Moment bereitgestellten Beispiele, ohne echtes Lernen im Sinne der vorherigen Etappen.
Wenn man zum Beispiel schreibt:
„2 + 3 = 5"
„4 + 6 = 10"
und dann fragt „7 + 8 = ?", antwortet das Modell „15", nicht weil es eine Addition durchführt, sondern weil diese Sequenz statistisch die wahrscheinlichste in den Texten ist, die es gesehen hat. Es verlängert einfach ein vertrautes Muster, ohne eine dauerhafte Rechenkompetenz zu erwerben.
Synthese: die vielen Gesichter des KI-Lernens
Die folgende Tabelle fasst die verschiedenen Ansätze, das Signal, das das Lernen leitet, und ihre praktischen Anwendungen zusammen.
| Lernart | Prinzip | Quelle des Signals | Häufige Anwendungen |
|---|---|---|---|
| Überwachtes Lernen | Vorhersage aus annotierten Beispielen. | Von Menschen bereitgestellte Etiketten. | Vision, Mustererkennung, Klassifizierung, medizinische Diagnose. |
| Unüberwachtes Lernen | Entdeckung verborgener Strukturen. | Interne Eigenschaften der Daten. | Exploration, Kompression, Segmentierung und Anomalieerkennung. |
| Verstärkendes Lernen | Optimierung einer Aktionspolitik. | Belohnungen und Bestrafungen. | Robotik, Spiele, sequenzielle Steuerung, Ausrichtung von LLM. |
| Selbstüberwachtes Lernen | Vorhersage maskierter oder fehlender Teile der Daten. | Automatische Maskierung und Struktur der Daten selbst. | Vortraining der meisten Sprachmodelle und vieler Bildmodelle. |
| Tiefes Lernen | Extraktion von Merkmalen auf mehreren Abstraktionsebenen. | Je nach Anwendung: Etiketten, die Daten selbst oder Belohnungen. | Verarbeitung von Bildern, Tönen und Texten, Vorhersage von Proteinstrukturen. |
| Große Sprachmodelle (LLM) | Verkettung von drei Lernarten auf einem tiefen Netzwerk. | RohText, dann von Menschen annotierte Beispiele, dann Optimierung menschlicher Präferenzen. | Dialogassistenten, Übersetzung, Zusammenfassung, Programmierhilfe. |
Die zentrale Rolle des Menschen und seiner Werkzeuge
Das Lernen der KI ist kein autonomer Prozess: Es beruht auf einer engen Zusammenarbeit zwischen Menschen und einer Vielzahl von Computertools. Die Modelle „entdecken" nicht allein, was zu lernen ist, noch wie es zu tun ist. Es sind menschliche Teams, die jede Etappe organisieren, ausrichten und kontrollieren, indem sie sich auf technische Infrastrukturen stützen, die gigantische Datenmengen verarbeiten können.
Die zentrale Rolle des Menschen
Menschen greifen in alle kritischen Etappen der Konzeption und des Lernens der Modelle ein. Ohne sie weiß eine KI weder, was sie lernen soll, noch wie, noch warum.
- Sie entwerfen die Architekturen (Transformer, tiefe Netzwerke).
- Sie wählen die Daten aus und bereinigen sie.
- Sie verfassen die Anweisungen und Antworten für das überwachte Lernen.
- Sie drücken ihre Präferenzen aus, um die Modelle zu leiten (RLHF, DPO).
- Sie definieren die Ziele, Metriken, Grenzen, Schutzmaßnahmen.
- Sie bewerten die Qualität, korrigieren Abweichungen, passen die Methoden an.
Ohne Menschen hat ein Modell keinen Rahmen: Es hat weder ein explizites Ziel noch Erfolgskriterien noch ein zuverlässiges Signal, um sein Lernen auszurichten.
Die unverzichtbare Rolle der Werkzeuge
Computertools machen das Lernen im großen Maßstab möglich. Sie automatisieren repetitive Aufgaben, strukturieren die Daten und nutzen beträchtliche materielle Ressourcen. Ohne sie wäre das moderne Lernen der KI materiell unmöglich.
- Sie maskieren automatisch Tokens für das Selbstüberwachte.
- Sie bereiten die Daten vor (Formatierung, Validierung, Deduplizierung).
- Sie verteilen die Arbeit an Tausende von Annotatoren.
- Sie überprüfen automatisch bestimmte Belohnungen (Mathematikprobleme, Computertests).
- Sie trainieren die Modelle auf Hunderten von GPUs.
- Sie optimieren menschliche Präferenzen im großen Maßstab.
Die Datenmengen sind zu groß, die Modelle zu schwer und die Aufgaben zu zahlreich, um manuell verwaltet zu werden. Das Lernen der KI ist daher das Ergebnis einer Allianz: menschliche Absicht und menschliches Urteilsvermögen, verstärkt durch leistungsfähige Computertools.
Referenzen
- Wikipedia – Maschinelles Lernen (neues Fenster)
- Wikipedia – Überwachtes Lernen (neues Fenster)
- Wikipedia – Unüberwachtes Lernen (neues Fenster)
- Wikipedia – Verstärkendes Lernen (neues Fenster)
- Wikipedia – Tiefes Lernen (neues Fenster)
- LeCun, Y., Bengio, Y., Hinton, G. – „Deep learning", Nature, Bd. 521, 2015 (neues Fenster)
- Sutton, R. S., Barto, A. G. – „Reinforcement Learning: An Introduction", 2. Aufl., MIT Press, 2018 (neues Fenster)
- Ouyang, L. et al. – „Training language models to follow instructions with human feedback", NeurIPS, 2022 (arXiv:2203.02155) (neues Fenster)
- Devlin, J., Chang, M.-W., Lee, K., Toutanova, K. – „BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding", NAACL, 2019 (arXiv:1810.04805) (neues Fenster)
FAQ: Alles Wissenswerte über die Lernarten der KI
Was sind die wichtigsten Lernarten der KI?
Die wichtigsten Lernarten der KI sind das überwachte Lernen, das unüberwachte Lernen, das verstärkende Lernen und das selbstüberwachte Lernen. Jede entspricht einer anderen Art, die Daten zu präsentieren und das Ziel des Algorithmus zu definieren. Tiefes Lernen ist keine Art derselben Natur: Es bezeichnet die Verwendung mehrschichtiger neuronaler Netze, die nach jedem dieser Ansätze trainiert werden können.
Was ist überwachtes Lernen?
Überwachtes Lernen besteht darin, ein Modell auf annotierten Beispielen zu trainieren. Jede Eingabe ist mit einem Etikett verbunden, das die richtige Antwort angibt. Das Modell lernt, diese Etiketten für neue Eingaben vorherzusagen, indem es eine Verlustfunktion minimiert.
Was ist unüberwachtes Lernen?
Unüberwachtes Lernen arbeitet mit Daten ohne Etiketten. Der Algorithmus sucht nach verborgenen Strukturen, wie Gruppen oder Mustern. Es wird für Clustering, Dimensionsreduktion und Anomalieerkennung verwendet.
Was ist verstärkendes Lernen?
Verstärkendes Lernen zeigt einen Agenten, der mit einer Umgebung interagiert. Der Agent erhält Belohnungen oder Bestrafungen je nach seinen Aktionen und lernt eine Politik, die die kumulierte Belohnung maximiert. Dieser Ansatz wird in der Robotik, in Spielen und in der sequenziellen Steuerung verwendet, sowie um Sprachmodelle an menschliche Präferenzen anzupassen.
Was ist tiefes Lernen?
Tiefes Lernen verwendet mehrschichtige neuronale Netze, um komplexe Daten zu verarbeiten. Diese Netzwerke lernen interne Repräsentationen, die Regelmäßigkeiten in den Daten erfassen. Tiefes Lernen steht im Zentrum der jüngsten Fortschritte in Vision, Sprachverarbeitung und Mustererkennung.
Warum spricht man von selbstüberwachtem Lernen?
Selbstüberwachtes Lernen erstellt interne Aufgaben aus den Daten selbst. Zum Beispiel werden Teile eines Textes maskiert und das Modell gebeten, sie vorherzusagen. Dieser Ansatz ermöglicht es, nützliche Repräsentationen ohne externe Etiketten zu lernen, was besonders für Sprachmodelle wichtig ist.
Wie lernt ein Modell wie ChatGPT, Claude oder Gemini?
Ein großes Sprachmodell lernt in mehreren Etappen. Es wird zunächst selbstüberwacht vortrainiert, um das nächste Wort auf immensen Textkorpora vorherzusagen. Dann wird es überwacht auf Beispiele von Anweisungen und Antworten angepasst, die von Menschen verfasst wurden. Schließlich wird es durch verstärkendes Lernen verfeinert, aus Bewertungen von Antworten, die von Evaluatoren erstellt wurden, oder automatisch überprüfbaren Belohnungen.
Wie gehen Maschinen beim Lernen vor?
Maschinen lernen, indem sie interne Parameter anpassen, um eine Abweichung zwischen ihren Vorhersagen und einem Referenzsignal zu verringern. Dieses Signal kann ein Etikett, eine verborgene Struktur, eine Belohnung oder eine selbstüberwachte Aufgabe sein. Optimierungsalgorithmen wie der Gradientenabstieg aktualisieren die Parameter, um die Leistung schrittweise zu verbessern.
 Die verschiedenen Lernarten der KI
 Agentische KI: Wenn Maschinen autonom werden
 Was KI nicht kann
 Künstliche Intelligenz und Astronomie: Die Rolle der KI-Assistenten verstehen
 KI-Tools: Wie wählt man aus?

 Generative KI vs AGI: Wo endet Nachahmung, wo beginnt Bewusstsein?
 Künstliche Netzwerke vs. biologische Netzwerke: Zwei Systeme, eine gemeinsame Architektur
 Menschliches Gehirn und künstliche Intelligenzen: Ähnlichkeiten und Unterschiede
 AlphaGo gegen AlphaGo Zero: Eine Revolution der künstlichen Intelligenz
 Der nächste Schritt intelligenter Maschinen
 Der erste Schritt zur Entstehung des Lebens
 Vom biologischen Neuron zum formalen Neuron: Vereinfachung des Gehirns
 Künstliche Intelligenz: Die Explosion des Gigantismus
 Wenn künstliche Intelligenz verrückt wird!
 Wie Maschinen intelligent werden
 Künstliche Intelligenz: reale Bedrohung oder Chance für die Menschheit?
 Wie Maschinen Sprache ähnlich wie Menschen verstehen, interpretieren und erzeugen
 Wie funktioniert ein künstliches neuronales Netzwerk?