


Los diferentes tipos de aprendizaje de las IA
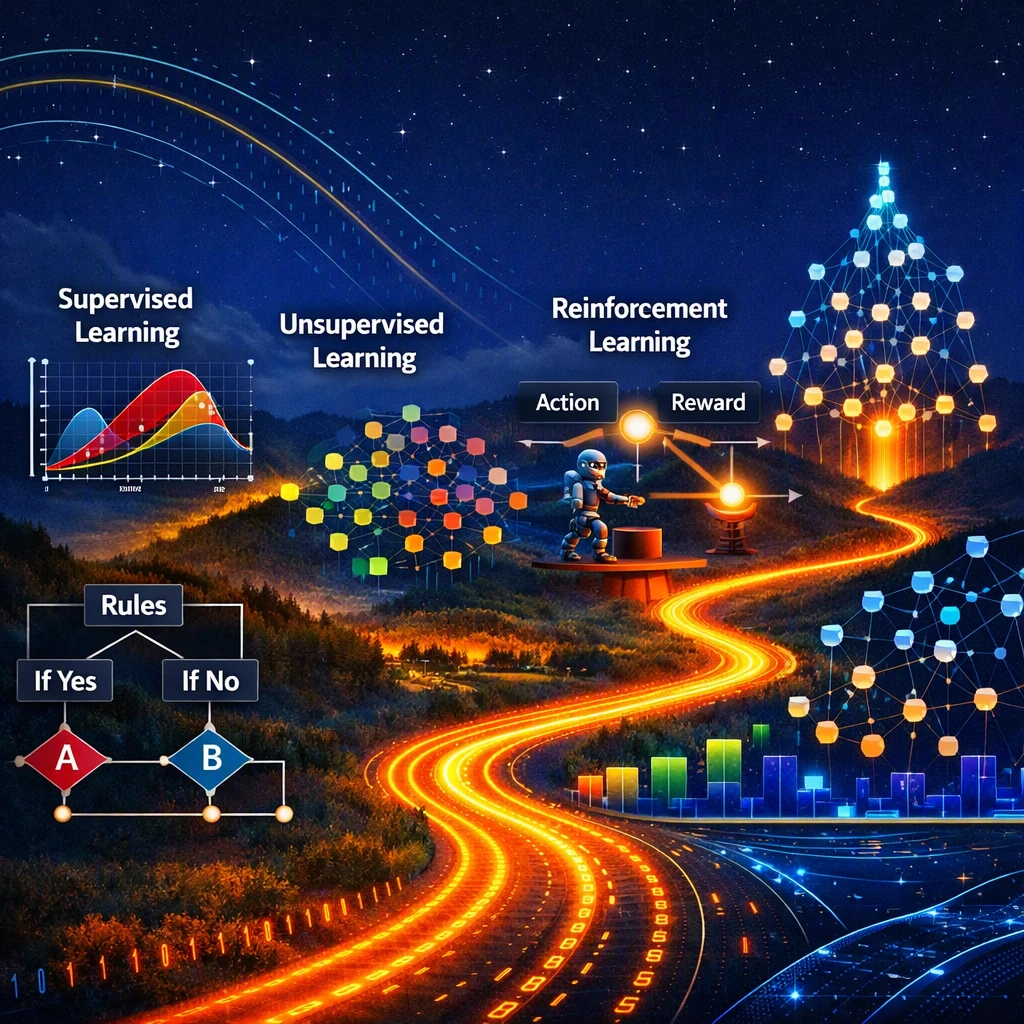
Ilustración de un paisaje de IA donde curvas de datos, redes de neuronas y diagramas de decisión representan los principales tipos de aprendizaje: supervisado, no supervisado, por refuerzo y profundo. La imagen sugiere un camino que va de reglas simples hacia arquitecturas complejas capaces de procesar volúmenes masivos de datos.
Fuente de la imagen: astronoo.com (nueva ventana) — imagen generada por IA, dominio público.
Resumen científico
Este artículo de Astronoo presenta los principales tipos de aprendizaje utilizados en inteligencia artificial, del más simple al más complejo. El aprendizaje automático se basa en la idea de que una máquina puede ajustar sus parámetros a partir de datos para mejorar sus rendimientos en una tarea. Se distingue el aprendizaje supervisado, donde los ejemplos están anotados, el aprendizaje no supervisado, que busca estructuras ocultas, el aprendizaje por refuerzo, basado en recompensas, y el aprendizaje auto-supervisado, donde los datos proporcionan ellos mismos la respuesta esperada. El aprendizaje profundo designa menos un método que una familia de arquitecturas (las redes de neuronas de varias capas), que puede combinarse con cada uno de los enfoques anteriores.
Cada tipo está ilustrado por un ejemplo concreto, con dos puntos de vista complementarios: lo que hacen los humanos (preparar los datos, definir el objetivo) y lo que hace la máquina (ajustar sus parámetros). Un capítulo está consagrado a los grandes modelos de lenguaje (LLM), como ChatGPT, Claude o Gemini, que combinan tres aprendizajes sucesivos: auto-supervisado, supervisado y luego por refuerzo.
¿Por qué hablar de tipos de aprendizaje?
Durante mucho tiempo, un humano escribía reglas detalladas que la máquina ejecutaba. Con el aprendizaje automático, se proporcionan ejemplos y el algoritmo ajusta él mismo sus parámetros a partir de los datos.
Los tipos de aprendizaje se distinguen por la manera de presentar los datos y de definir el objetivo: ejemplos etiquetados (supervisado), datos brutos donde buscar estructuras (no supervisado), recompensas y penalizaciones (por refuerzo), o preguntas y respuestas extraídas de los propios datos (auto-supervisado). El aprendizaje profundo no es un quinto tipo: es una arquitectura de redes de neuronas de varias capas, que puede entrenarse según cada uno de estos enfoques, y a menudo combinándolos.
También para descubrir
Continúe su exploración del Universo con estos temas:
Panorama de los principales tipos de aprendizaje de las IA
Del más simple al más complejo
La tabla siguiente presenta los principales tipos de aprendizaje de las IA, del más simple al más complejo, con un ejemplo concreto, una puesta en perspectiva sobre la manera en que un actor humano puede organizar el aprendizaje, y una descripción sintética de cómo procede la máquina.
| Tipo de aprendizaje | Ejemplo concreto | Organización humana de los datos y objetivos | Mecanismo de aprendizaje de la máquina |
|---|---|---|---|
| Aprendizaje supervisado | Clasificar imágenes de galaxias en espirales o elípticas, a partir de imágenes ya etiquetadas (por ejemplo por los voluntarios del proyecto de ciencia participativa Galaxy Zoo). | Constitución de conjuntos de datos anotados, con astrónomos o voluntarios que indican la clase correcta de cada imagen. | Minimización de una función de pérdida entre las predicciones del modelo y las etiquetas, mediante ajuste de los parámetros a través de algoritmos como el descenso de gradiente. |
| Aprendizaje no supervisado | Agrupar miles de espectros de estrellas en familias, sin saber de antemano cuántas familias existen. | Recolección de grandes bases de datos sin etiquetas, elección de las variables a comparar, luego interpretación de los grupos obtenidos. | Búsqueda de estructuras ocultas, por ejemplo con algoritmos de clustering o de reducción de dimensión que acercan los objetos similares. |
| Aprendizaje por refuerzo | Aprender a jugar al go disputando millones de partidas contra sí mismo (AlphaGo, AlphaZero). En astronomía, la misma lógica se estudia para planificar las observaciones de un telescopio. | Definición de una función de recompensa (+1 por una victoria, −1 por una derrota; o una ganancia por cada observación útil y una penalización por cada tiempo muerto). | Interacción con un entorno, ensayos y errores, luego actualización de una política de acción para maximizar la recompensa acumulada, alternando exploración y explotación. |
| Aprendizaje auto-supervisado | Ocultar la última palabra de una frase y pedir al modelo que la adivine: «La Vía Láctea es una galaxia …» → «espiral». | Reunición de corpus muy grandes de textos, imágenes o sonidos. No se necesita ninguna anotación manual, pues la respuesta esperada ya está en los datos. | El modelo predice una parte enmascarada o faltante de los datos, luego compara su predicción con el contenido real. Esta tarea le obliga a aprender representaciones útiles. |
| Aprendizaje profundo | Detectar exoplanetas en las curvas de luz del telescopio Kepler. Una red de neuronas contribuyó así a identificar Kepler-90 i, octavo planeta de su sistema, anunciado a finales de 2017. | Organización de grandes bases de datos, elección de una arquitectura de red adaptada y definición de criterios de rendimiento. | Propagación de la información a través de numerosas capas de neuronas, luego ajuste de los pesos por retropropagación para extraer características cada vez más abstractas. |
| Aprendizaje por transferencia | Reutilizar un modelo ya entrenado sobre millones de imágenes para analizar las de un nuevo telescopio, o especializar un LLM generalista en artículos de astronomía. | Elección de un modelo preentrenado, luego constitución de un pequeño conjunto de datos propio de la nueva tarea. | Conservación de los parámetros aprendidos en una tarea fuente, luego ajuste fino (fine-tuning) en la tarea objetivo con muchos menos datos. |
| Aprendizaje en línea | Actualizar continuamente un filtro de alertas (supernovas, asteroides, objetos variables) a medida que los sondeos del cielo envían nuevos datos. | Definición de procedimientos de actualización regulares y vigilancia de un flujo de datos que llega en tiempo real. | Adaptación progresiva de los parámetros a medida que llegan las nuevas observaciones, sin reentrenar el modelo desde cero. |
| Grandes modelos de lenguaje (LLM) | Un asistente conversacional (ChatGPT, Claude, Gemini, Mistral…) que responde a una pregunta sobre los agujeros negros. | Constitución de un corpus de textos gigantesco, redacción de ejemplos de buenas respuestas por anotadores, luego clasificación de respuestas competidoras por evaluadores humanos. | Tres aprendizajes sucesivos: predicción de la palabra siguiente (auto-supervisado), imitación de respuestas modelo (supervisado), luego optimización de una puntuación de preferencia humana (refuerzo). |
Ejemplos detallados: del concepto a la práctica
Aprendizaje supervisado
En el aprendizaje supervisado, cada ejemplo está asociado a una etiqueta que indica la respuesta correcta. Un ejemplo clásico es la clasificación de imágenes: se proporcionan a la máquina imágenes de galaxias, cada una anotada como espiral o elíptica. El objetivo es que el modelo aprenda a predecir la clase correcta (espiral o elíptica) para nuevas imágenes.
- Del lado humano: la organización de este aprendizaje consiste en constituir conjuntos de datos anotados, definir criterios de rendimiento (tasa de respuestas correctas, precisión) y vigilar la calidad de las etiquetas.
- Desde el punto de vista de la máquina: el aprendizaje se hace minimizando una función de pérdida que mide la diferencia entre las predicciones y las etiquetas, ajustando los parámetros del modelo (pesos, sesgos para minimizar la función de pérdida) mediante métodos de optimización (algoritmos como el descenso de gradiente).
- Ejemplo concreto: un modelo recibe imágenes de galaxias y aprende a distinguir automáticamente las espirales de las elípticas ajustando sus parámetros a lo largo de los ejemplos anotados.
Aprendizaje no supervisado
En el aprendizaje no supervisado, los datos no poseen ninguna etiqueta: la máquina no sabe de antemano qué categorías o estructuras debe encontrar. El objetivo es descubrir agrupaciones naturales, motivos ocultos o dimensiones pertinentes en los datos. Un ejemplo clásico es el análisis de espectros de estrellas para identificar automáticamente familias de comportamientos sin indicación previa.
- Del lado humano: la organización de este aprendizaje consiste en recolectar grandes bases de datos no anotadas, elegir variables pertinentes y definir objetivos exploratorios (agrupaciones, detección de anomalías, reducción de dimensión).
- Desde el punto de vista de la máquina: el aprendizaje se apoya en algoritmos que buscan estructuras internas en los datos, como la agrupación de puntos cercanos o la extracción de componentes principales, sin función de pérdida supervisada.
- Ejemplo concreto: un modelo analiza miles de espectros de estrellas y agrupa automáticamente las que presentan firmas similares, revelando familias astrofísicas sin intervención humana.
Aprendizaje por refuerzo
En el aprendizaje por refuerzo, un agente interactúa con un entorno y recibe recompensas o penalizaciones según las acciones que efectúa. El objetivo no es predecir una etiqueta, sino aprender una política de acción que maximice la recompensa acumulada. Un ejemplo clásico es el control de un telescopio robotizado que debe elegir qué objetivos observar para optimizar el tiempo de observación.
- Del lado humano: la organización de este aprendizaje consiste en definir una función de recompensa (medida de la calidad de las acciones), especificar las reglas del entorno y asegurarse de que el agente no desarrolle estrategias indeseables.
- Desde el punto de vista de la máquina: el agente explora diferentes acciones, observa las recompensas obtenidas y actualiza su política para maximizar la recompensa acumulada, gracias a algoritmos de optimización secuencial (como Q-learning o los métodos de gradiente de política).
- Ejemplo concreto: un agente controla un telescopio automatizado y aprende, a lo largo de los ensayos, a seleccionar los objetivos más interesantes minimizando los movimientos inútiles, a fin de optimizar la calidad y la cantidad de las observaciones.
Aprendizaje auto-supervisado
En el aprendizaje auto-supervisado, la máquina crea ella misma sus propias etiquetas a partir de los datos brutos. En lugar de recibir una respuesta correcta proporcionada por un humano, el modelo debe predecir una parte faltante o enmascarada de la entrada. Este enfoque permite explotar vastos conjuntos de datos no anotados. Un ejemplo clásico es la predicción de palabras enmascaradas en textos científicos para aprender representaciones del lenguaje.
- Del lado humano: la organización de este aprendizaje consiste en preparar grandes corpus no anotados, definir una tarea interna (enmascarar palabras, predecir la continuación de una secuencia) y controlar la calidad de los datos utilizados para evitar sesgos.
- Desde el punto de vista de la máquina: el modelo aprende resolviendo una tarea artificial generada a partir de los propios datos, como predecir tokens enmascarados o reconstruir una parte de una imagen, lo que le permite extraer representaciones internas útiles.
- Ejemplo concreto: un modelo recibe textos científicos donde ciertas palabras están enmascaradas y aprende, adivinándolas, a capturar las relaciones entre términos, lo que mejora luego sus rendimientos en tareas reales.
Aprendizaje profundo
En el aprendizaje profundo, la máquina utiliza redes de neuronas de varias capas capaces de extraer características cada vez más complejas a partir de los datos. Cada capa transforma la información para revelar motivos invisibles a los métodos clásicos. Este enfoque es particularmente eficaz para tratar imágenes, sonidos o textos. Un ejemplo corriente es el análisis de imágenes de nebulosas para identificar automáticamente estructuras difíciles de distinguir a simple vista.
- Del lado humano: la organización de este aprendizaje consiste en reunir grandes bases de imágenes, elegir una arquitectura de red adaptada (CNN, transformers), definir criterios de rendimiento y disponer de recursos de cálculo suficientes.
- Desde el punto de vista de la máquina: la red aprende ajustando millones de parámetros a través de varias capas, cada capa extrayendo motivos más abstractos. La optimización se hace minimizando una función de pérdida gracias a métodos de optimización (como el descenso de gradiente).
- Ejemplo concreto: una red de neuronas analiza imágenes de nebulosas y aprende a reconocer automáticamente filamentos, burbujas o zonas de emisión, afinando sus parámetros capa tras capa.
N.B.:
En las redes de neuronas modernas, la profundidad sigue siendo moderada: las arquitecturas cuentan generalmente entre una veintena y algunos cientos de capas. En cambio, el número total de neuronas puede alcanzar millones, o incluso cientos de millones en los modelos más avanzados. Esta diferencia explica que una red pueda ser «profunda» sin tener miles de capas: son los miles de neuronas por capa, multiplicados por decenas de capas, los que dan modelos de tamaño colosal.
Caso de escuela: ¿cómo aprende un gran modelo de lenguaje?
Un mismo modelo, tres aprendizajes sucesivos
Los grandes modelos de lenguaje (LLM) ilustran bien la combinación de los enfoques. Su entrenamiento se desarrolla en varias etapas, cada una correspondiendo a un tipo de aprendizaje diferente. Es lo que permite a un asistente conversacional pasar de un simple predictor de palabras a un interlocutor capaz de seguir consignas.
Etapa 1: el preentrenamiento auto-supervisado
El modelo lee inmensas cantidades de textos y aprende a predecir la palabra (más exactamente el «token») siguiente. En la frase «El Sol es una estrella de tipo …», debe adivinar «enana amarilla» o una continuación plausible. Ningún humano anota estos textos: la respuesta es el texto mismo. Es aprendizaje auto-supervisado, y es la etapa más costosa en datos y en cálculo. Modelos como BERT utilizan un enmascaramiento automático de tokens: un algoritmo oculta aleatoriamente ciertas palabras, que el modelo debe luego predecir.
Etapa 2: el ajuste supervisado sobre instrucciones
El modelo preentrenado sabe prolongar un texto, pero no forzosamente responder a una pregunta. Anotadores humanos redactan consignas y respuestas, mientras que herramientas informáticas preparan automáticamente estos datos para el entrenamiento. El modelo es luego ajustado para imitar estos ejemplos: es aprendizaje supervisado aplicado a un conjunto de datos mucho más pequeño que el corpus inicial.
Etapa 3: el refuerzo a partir de retornos humanos
Para afinar la calidad de las respuestas, se pide a evaluadores que clasifiquen varias respuestas del modelo. Estas clasificaciones sirven para entrenar un modelo de recompensa, que atribuye una puntuación a una respuesta. El LLM es luego optimizado para obtener puntuaciones elevadas. Es el principio del RLHF (aprendizaje por refuerzo a partir de retornos humanos), descrito en particular para InstructGPT en 2022. Desde entonces, se han propuesto métodos más simples, como la optimización de preferencias, donde el modelo aprende a privilegiar las respuestas juzgadas mejores por humanos. Ciertos laboratorios utilizan también recompensas verificables automáticamente — por ejemplo la resolución correcta de un problema de matemáticas o el éxito de tests informáticos — para entrenar modelos llamados «de razonamiento».
¿Y el «aprendizaje en contexto»?
Cuando se proporcionan dos o tres ejemplos en una pregunta, el modelo parece «aprender» la tarea: reproduce el esquema mostrado en el prompt. En realidad, se trata de una adaptación temporal. Los parámetros internos del modelo no se modifican y, una vez terminada la conversación, nada se conserva en los pesos. El modelo no hace pues más que explotar los ejemplos proporcionados en el momento, sin verdadero aprendizaje en el sentido de las etapas precedentes.
Por ejemplo, si se escribe:
«2 + 3 = 5»
«4 + 6 = 10»
y luego se pregunta «7 + 8 = ?», el modelo responde «15» no porque efectúe una adición, sino porque esta secuencia es estadísticamente la más probable en los textos que ha visto. Simplemente prolonga un motivo familiar, sin adquirir competencia duradera en cálculo.
Síntesis: los múltiples rostros del aprendizaje de las IA
La tabla siguiente recapitula los diferentes enfoques, la señal que guía el aprendizaje y sus usos prácticos.
| Tipo de aprendizaje | Principio | Fuente de la señal | Usos corrientes |
|---|---|---|---|
| Aprendizaje supervisado | Predicción a partir de ejemplos anotados. | Etiquetas proporcionadas por humanos. | Visión, reconocimiento de formas, clasificación, diagnóstico médico. |
| Aprendizaje no supervisado | Descubrimiento de estructuras ocultas. | Propiedades internas de los datos. | Exploración, compresión, segmentación y detección de anomalías. |
| Aprendizaje por refuerzo | Optimización de una política de acción. | Recompensas y penalizaciones. | Robótica, juegos, control secuencial, alineación de los LLM. |
| Aprendizaje auto-supervisado | Predicción de partes enmascaradas o faltantes de los datos. | Enmascaramiento automático y estructura de los propios datos. | Preentrenamiento de la mayoría de los modelos de lenguaje y de numerosos modelos de imágenes. |
| Aprendizaje profundo | Extracción de características en varios niveles de abstracción. | Según el uso: etiquetas, los propios datos o recompensas. | Tratamiento de imágenes, sonidos y textos, predicción de estructuras de proteínas. |
| Grandes modelos de lenguaje (LLM) | Encadenamiento de tres aprendizajes sobre una red profunda. | Texto bruto, luego ejemplos anotados por humanos, luego optimización de las preferencias humanas. | Asistentes conversacionales, traducción, resumen, ayuda a la programación. |
El papel central del humano y de sus herramientas
El aprendizaje de las IA no es un proceso autónomo: se apoya en una colaboración estrecha entre humanos y una panoplia de herramientas informáticas. Los modelos no «descubren» solos qué aprender, ni cómo hacerlo. Son equipos humanos los que organizan, orientan y controlan cada etapa, apoyándose en infraestructuras técnicas capaces de tratar volúmenes de datos gigantescos.
El papel central del humano
Los humanos intervienen en todas las etapas críticas de la concepción y del aprendizaje de los modelos. Sin ellos, una IA no sabe ni qué aprender, ni cómo, ni por qué.
- Conciben las arquitecturas (transformers, redes profundas).
- Seleccionan y limpian los datos.
- Redactan las consignas y las respuestas para el aprendizaje supervisado.
- Expresan sus preferencias para guiar los modelos (RLHF, DPO).
- Definen los objetivos, las métricas, los límites, las salvaguardias.
- Evalúan la calidad, corrigen las derivas, ajustan los métodos.
Sin humanos, un modelo no dispone de ningún marco: no tiene ni meta explícita, ni criterios de éxito, ni señal fiable para orientar su aprendizaje.
El papel indispensable de las herramientas
Las herramientas informáticas hacen posible el aprendizaje a gran escala. Automatizan las tareas repetitivas, estructuran los datos y explotan recursos materiales considerables. Sin ellas, el aprendizaje moderno de las IA sería materialmente imposible.
- Enmascaran automáticamente tokens para el auto-supervisado.
- Preparan los datos (formateo, validación, deduplicación).
- Distribuyen el trabajo a miles de anotadores.
- Verifican automáticamente ciertas recompensas (problemas de matemáticas, tests informáticos).
- Entrenan los modelos sobre cientos de GPU.
- Optimizan las preferencias humanas a gran escala.
Los volúmenes de datos son demasiado grandes, los modelos demasiado pesados y las tareas demasiado numerosas para ser gestionados manualmente. El aprendizaje de las IA es pues el resultado de una alianza: la intención y el juicio humanos, amplificados por herramientas informáticas potentes.
Referencias
- Wikipedia – Aprendizaje automático (nueva ventana)
- Wikipedia – Aprendizaje supervisado (nueva ventana)
- Wikipedia – Aprendizaje no supervisado (nueva ventana)
- Wikipedia – Aprendizaje por refuerzo (nueva ventana)
- Wikipedia – Aprendizaje profundo (nueva ventana)
- LeCun, Y., Bengio, Y., Hinton, G. – «Deep learning», Nature, vol. 521, 2015 (nueva ventana)
- Sutton, R. S., Barto, A. G. – «Reinforcement Learning: An Introduction», 2ª ed., MIT Press, 2018 (nueva ventana)
- Ouyang, L. et al. – «Training language models to follow instructions with human feedback», NeurIPS, 2022 (arXiv:2203.02155) (nueva ventana)
- Devlin, J., Chang, M.-W., Lee, K., Toutanova, K. – «BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding», NAACL, 2019 (arXiv:1810.04805) (nueva ventana)
FAQ: Todo lo que hay que saber sobre los tipos de aprendizaje de las IA
¿Cuáles son los principales tipos de aprendizaje de las IA?
Los principales tipos de aprendizaje de las IA son el aprendizaje supervisado, el aprendizaje no supervisado, el aprendizaje por refuerzo y el aprendizaje auto-supervisado. Cada uno corresponde a una manera diferente de presentar los datos y de definir el objetivo del algoritmo. El aprendizaje profundo no es un tipo de la misma naturaleza: designa el uso de redes de neuronas de varias capas, que pueden entrenarse según cada uno de estos enfoques.
¿Qué es el aprendizaje supervisado?
El aprendizaje supervisado consiste en entrenar un modelo sobre ejemplos anotados. Cada entrada está asociada a una etiqueta que indica la respuesta correcta. El modelo aprende a predecir estas etiquetas para nuevas entradas minimizando una función de pérdida.
¿Qué es el aprendizaje no supervisado?
El aprendizaje no supervisado trabaja sobre datos sin etiquetas. El algoritmo busca estructuras ocultas, como grupos o motivos. Se utiliza para el clustering, la reducción de dimensión y la detección de anomalías.
¿Qué es el aprendizaje por refuerzo?
El aprendizaje por refuerzo pone en escena un agente que interactúa con un entorno. El agente recibe recompensas o penalizaciones en función de sus acciones y aprende una política que maximiza la recompensa acumulada. Este enfoque se utiliza en robótica, en juegos y en control secuencial, así como para alinear los modelos de lenguaje con las preferencias humanas.
¿Qué es el aprendizaje profundo?
El aprendizaje profundo utiliza redes de neuronas de varias capas para tratar datos complejos. Estas redes aprenden representaciones internas que capturan regularidades en los datos. El aprendizaje profundo está en el corazón de los progresos recientes en visión, en tratamiento del lenguaje y en reconocimiento de formas.
¿Por qué se habla de aprendizaje auto-supervisado?
El aprendizaje auto-supervisado crea tareas internas a partir de los propios datos. Por ejemplo, se enmascaran partes de un texto y se pide al modelo que las prediga. Este enfoque permite aprender representaciones útiles sin etiquetas externas, lo que es particularmente importante para los modelos de lenguaje.
¿Cómo aprende un modelo como ChatGPT, Claude o Gemini?
Un gran modelo de lenguaje aprende en varias etapas. Primero es preentrenado de manera auto-supervisada para predecir la palabra siguiente sobre inmensos corpus de textos. Luego es ajustado de manera supervisada sobre ejemplos de consignas y respuestas redactados por humanos. Finalmente, es afinado por aprendizaje por refuerzo, a partir de clasificaciones de respuestas establecidas por evaluadores o de recompensas verificables automáticamente.
¿Cómo se las arreglan las máquinas para aprender?
Las máquinas aprenden ajustando parámetros internos para reducir una diferencia entre sus predicciones y una señal de referencia. Esta señal puede ser una etiqueta, una estructura oculta, una recompensa o una tarea auto-supervisada. Los algoritmos de optimización, como el descenso de gradiente, actualizan los parámetros para mejorar progresivamente los rendimientos.
 Los diferentes tipos de aprendizaje de las IA
 IA Agentica: Cuando las máquinas se vuelven autónomas
 Lo que la IA no puede hacer
 Inteligencia artificial y astronomía: Comprender el papel de los asistentes IA
 Herramientas de IA: ¿cómo elegir?

 IA Generativa vs AGI: ¿Dónde termina la imitación y dónde comienza la conciencia?
 Redes artificiales vs. redes biológicas: Dos sistemas, una arquitectura común
 Cerebro Humano e Inteligencias Artificiales: Similitudes y Diferencias
 AlphaGo contra AlphaGo Zero: Una Revolución en la Inteligencia Artificial
 El Próximo Paso para las Máquinas Inteligentes
 El primer paso hacia el surgimiento de la vida
 De la Neurona Biológica a la Neurona Formal: Simplificación del Cerebro
 Inteligencia artificial: la explosión del gigantismo
 ¡Cuando la inteligencia artificial se vuelve loca!
 Cómo las máquinas se vuelven inteligentes
 Inteligencia artificial: ¿amenaza real u oportunidad para la humanidad?
 ¿Cómo las máquinas entienden, interpretan y generan el lenguaje de forma similar a los humanos?
 ¿Cómo funciona una red neuronal artificial?