


Os diferentes tipos de aprendizagem das IA
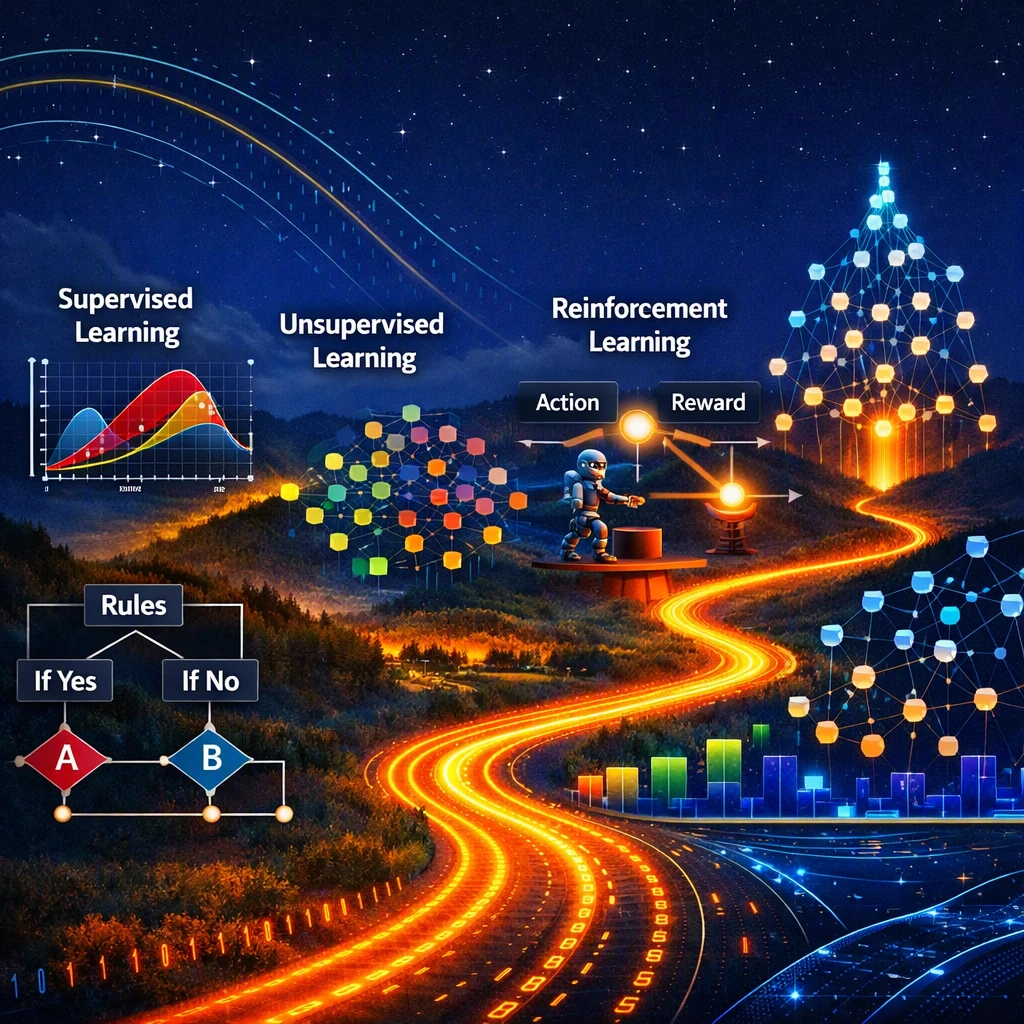
Ilustração de uma paisagem de IA onde curvas de dados, redes de neurónios e diagramas de decisão representam os principais tipos de aprendizagem: supervisionada, não supervisionada, por reforço e profunda. A imagem sugere um caminho que vai de regras simples para arquiteturas complexas capazes de processar volumes maciços de dados.
Fonte da imagem: astronoo.com (nova janela) — imagem gerada por IA, domínio público.
Resumo científico
Este artigo da Astronoo apresenta os principais tipos de aprendizagem utilizados em inteligência artificial, do mais simples ao mais complexo. A aprendizagem automática baseia-se na ideia de que uma máquina pode ajustar os seus parâmetros a partir de dados para melhorar os seus desempenhos numa tarefa. Distingue-se a aprendizagem supervisionada, onde os exemplos estão anotados, a aprendizagem não supervisionada, que procura estruturas ocultas, a aprendizagem por reforço, baseada em recompensas, e a aprendizagem auto-supervisionada, onde os dados fornecem eles próprios a resposta esperada. A aprendizagem profunda designa menos um método do que uma família de arquiteturas (as redes de neurónios de várias camadas), que pode ser combinada com cada uma das abordagens anteriores.
Cada tipo é ilustrado por um exemplo concreto, com dois pontos de vista complementares: o que fazem os humanos (preparar os dados, definir o objetivo) e o que faz a máquina (ajustar os seus parâmetros). Um capítulo é consagrado aos grandes modelos de linguagem (LLM), como o ChatGPT, o Claude ou o Gemini, que combinam três aprendizagens sucessivas: auto-supervisionada, supervisionada e depois por reforço.
Porquê falar de tipos de aprendizagem?
Durante muito tempo, um humano escrevia regras detalhadas que a máquina executava. Com a aprendizagem automática, fornecem-se exemplos e o algoritmo ajusta ele próprio os seus parâmetros a partir dos dados.
Os tipos de aprendizagem distinguem-se pela maneira de apresentar os dados e de definir o objetivo: exemplos etiquetados (supervisionada), dados brutos onde procurar estruturas (não supervisionada), recompensas e penalizações (por reforço), ou perguntas e respostas extraídas dos próprios dados (auto-supervisionada). A aprendizagem profunda não é um quinto tipo: é uma arquitetura de redes de neurónios de várias camadas, que pode ser treinada segundo cada uma destas abordagens, e frequentemente combinando-as.
Também para descobrir
Continue a sua exploração do Universo com estes temas:
Panorama dos principais tipos de aprendizagem das IA
Do mais simples ao mais complexo
A tabela abaixo apresenta os principais tipos de aprendizagem das IA, do mais simples ao mais complexo, com um exemplo concreto, uma perspetiva sobre a maneira como um ator humano pode organizar a aprendizagem, e uma descrição sintética de como a máquina procede.
| Tipo de aprendizagem | Exemplo concreto | Organização humana dos dados e objetivos | Mecanismo de aprendizagem da máquina |
|---|---|---|---|
| Aprendizagem supervisionada | Classificar imagens de galáxias em espirais ou elípticas, a partir de imagens já etiquetadas (por exemplo pelos voluntários do projeto de ciência participativa Galaxy Zoo). | Constituição de conjuntos de dados anotados, com astrónomos ou voluntários que indicam a classe correta de cada imagem. | Minimização de uma função de perda entre as previsões do modelo e as etiquetas, através do ajuste dos parâmetros por algoritmos como a descida de gradiente. |
| Aprendizagem não supervisionada | Agrupar milhares de espetros de estrelas em famílias, sem saber de antemão quantas famílias existem. | Recolha de grandes bases de dados sem etiquetas, escolha das variáveis a comparar, depois interpretação dos grupos obtidos. | Procura de estruturas ocultas, por exemplo com algoritmos de clustering ou de redução de dimensão que aproximam os objetos semelhantes. |
| Aprendizagem por reforço | Aprender a jogar go disputando milhões de partidas contra si próprio (AlphaGo, AlphaZero). Em astronomia, a mesma lógica é estudada para planear as observações de um telescópio. | Definição de uma função de recompensa (+1 por uma vitória, −1 por uma derrota; ou um ganho por cada observação útil e uma penalização por cada tempo morto). | Interação com um ambiente, tentativas e erros, depois atualização de uma política de ação para maximizar a recompensa acumulada, alternando exploração e exploração. |
| Aprendizagem auto-supervisionada | Esconder a última palavra de uma frase e pedir ao modelo que a adivinhe: «A Via Láctea é uma galáxia …» → «espiral». | Reunião de corpus muito grandes de textos, imagens ou sons. Nenhuma anotação manual é necessária, pois a resposta esperada já está nos dados. | O modelo prevê uma parte mascarada ou em falta dos dados, depois compara a sua previsão com o conteúdo real. Esta tarefa obriga-o a aprender representações úteis. |
| Aprendizagem profunda | Detetar exoplanetas nas curvas de luz do telescópio Kepler. Uma rede de neurónios contribuiu assim para identificar Kepler-90 i, oitavo planeta do seu sistema, anunciado no final de 2017. | Organização de grandes bases de dados, escolha de uma arquitetura de rede adaptada e definição de critérios de desempenho. | Propagação da informação através de numerosas camadas de neurónios, depois ajuste dos pesos por retropropagação para extrair características cada vez mais abstratas. |
| Aprendizagem por transferência | Reutilizar um modelo já treinado sobre milhões de imagens para analisar as de um novo telescópio, ou especializar um LLM generalista em artigos de astronomia. | Escolha de um modelo pré-treinado, depois constituição de um pequeno conjunto de dados próprio da nova tarefa. | Conservação dos parâmetros aprendidos numa tarefa fonte, depois ajuste fino (fine-tuning) na tarefa alvo com muitos menos dados. |
| Aprendizagem em linha | Atualizar continuamente um filtro de alertas (supernovas, asteroides, objetos variáveis) à medida que os levantamentos do céu enviam novos dados. | Definição de procedimentos de atualização regulares e vigilância de um fluxo de dados que chega em tempo real. | Adaptação progressiva dos parâmetros ao longo das novas observações, sem re-treinar o modelo desde zero. |
| Grandes modelos de linguagem (LLM) | Um assistente conversacional (ChatGPT, Claude, Gemini, Mistral…) que responde a uma pergunta sobre os buracos negros. | Constituição de um corpus de textos gigantesco, redação de exemplos de boas respostas por anotadores, depois classificação de respostas concorrentes por avaliadores humanos. | Três aprendizagens sucessivas: previsão da palavra seguinte (auto-supervisionada), imitação de respostas modelo (supervisionada), depois otimização de uma pontuação de preferência humana (reforço). |
Exemplos detalhados: do conceito à prática
Aprendizagem supervisionada
Na aprendizagem supervisionada, cada exemplo está associado a uma etiqueta que indica a resposta correta. Um exemplo clássico é a classificação de imagens: fornecem-se à máquina imagens de galáxias, cada uma anotada como espiral ou elíptica. O objetivo é que o modelo aprenda a prever a classe correta (espiral ou elíptica) para novas imagens.
- Do lado humano: a organização desta aprendizagem consiste em constituir conjuntos de dados anotados, definir critérios de desempenho (taxa de respostas corretas, precisão) e vigiar a qualidade das etiquetas.
- Do ponto de vista da máquina: a aprendizagem faz-se minimizando uma função de perda que mede a diferença entre as previsões e as etiquetas, ajustando os parâmetros do modelo (pesos, enviesamentos para minimizar a função de perda) por métodos de otimização (algoritmos como a descida de gradiente).
- Exemplo concreto: um modelo recebe imagens de galáxias e aprende a distinguir automaticamente as espirais das elípticas ajustando os seus parâmetros ao longo dos exemplos anotados.
Aprendizagem não supervisionada
Na aprendizagem não supervisionada, os dados não possuem nenhuma etiqueta: a máquina não sabe de antemão que categorias ou estruturas deve encontrar. O objetivo é descobrir agrupamentos naturais, motivos ocultos ou dimensões pertinentes nos dados. Um exemplo clássico é a análise de espetros de estrelas para identificar automaticamente famílias de comportamentos sem indicação prévia.
- Do lado humano: a organização desta aprendizagem consiste em recolher grandes bases de dados não anotadas, escolher variáveis pertinentes e definir objetivos exploratórios (agrupamentos, deteção de anomalias, redução de dimensão).
- Do ponto de vista da máquina: a aprendizagem baseia-se em algoritmos que procuram estruturas internas nos dados, como o agrupamento de pontos próximos ou a extração de componentes principais, sem função de perda supervisionada.
- Exemplo concreto: um modelo analisa milhares de espetros de estrelas e agrupa automaticamente as que apresentam assinaturas semelhantes, revelando famílias astrofísicas sem intervenção humana.
Aprendizagem por reforço
Na aprendizagem por reforço, um agente interage com um ambiente e recebe recompensas ou penalizações segundo as ações que efetua. O objetivo não é prever uma etiqueta, mas aprender uma política de ação que maximize a recompensa acumulada. Um exemplo clássico é o controlo de um telescópio robotizado que deve escolher que alvos observar para otimizar o tempo de observação.
- Do lado humano: a organização desta aprendizagem consiste em definir uma função de recompensa (medida da qualidade das ações), especificar as regras do ambiente e assegurar-se de que o agente não desenvolve estratégias indesejáveis.
- Do ponto de vista da máquina: o agente explora diferentes ações, observa as recompensas obtidas e atualiza a sua política para maximizar a recompensa acumulada, graças a algoritmos de otimização sequencial (como Q-learning ou os métodos de gradiente de política).
- Exemplo concreto: um agente controla um telescópio automatizado e aprende, ao longo das tentativas, a selecionar os alvos mais interessantes minimizando os movimentos inúteis, a fim de otimizar a qualidade e a quantidade das observações.
Aprendizagem auto-supervisionada
Na aprendizagem auto-supervisionada, a máquina cria ela própria as suas etiquetas a partir dos dados brutos. Em vez de receber uma resposta correta fornecida por um humano, o modelo deve prever uma parte em falta ou mascarada da entrada. Esta abordagem permite explorar vastos conjuntos de dados não anotados. Um exemplo clássico é a previsão de palavras mascaradas em textos científicos para aprender representações da linguagem.
- Do lado humano: a organização desta aprendizagem consiste em preparar grandes corpus não anotados, definir uma tarefa interna (mascarar palavras, prever a continuação de uma sequência) e controlar a qualidade dos dados utilizados para evitar enviesamentos.
- Do ponto de vista da máquina: o modelo aprende resolvendo uma tarefa artificial gerada a partir dos próprios dados, como prever tokens mascarados ou reconstruir uma parte de uma imagem, o que lhe permite extrair representações internas úteis.
- Exemplo concreto: um modelo recebe textos científicos onde certas palavras estão mascaradas e aprende, adivinhando-as, a capturar as relações entre termos, o que melhora depois os seus desempenhos em tarefas reais.
Aprendizagem profunda
Na aprendizagem profunda, a máquina utiliza redes de neurónios de várias camadas capazes de extrair características cada vez mais complexas a partir dos dados. Cada camada transforma a informação para revelar motivos invisíveis aos métodos clássicos. Esta abordagem é particularmente eficaz para tratar imagens, sons ou textos. Um exemplo corrente é a análise de imagens de nebulosas para identificar automaticamente estruturas difíceis de distinguir a olho nu.
- Do lado humano: a organização desta aprendizagem consiste em reunir grandes bases de imagens, escolher uma arquitetura de rede adaptada (CNN, transformers), definir critérios de desempenho e dispor de recursos de cálculo suficientes.
- Do ponto de vista da máquina: a rede aprende ajustando milhões de parâmetros através de várias camadas, cada camada extraindo motivos mais abstratos. A otimização faz-se minimizando uma função de perda graças a métodos de otimização (como a descida de gradiente).
- Exemplo concreto: uma rede de neurónios analisa imagens de nebulosas e aprende a reconhecer automaticamente filamentos, bolhas ou zonas de emissão, afinando os seus parâmetros camada após camada.
N.B.:
Nas redes de neurónios modernas, a profundidade permanece moderada: as arquiteturas contam geralmente entre uma vintena e algumas centenas de camadas. Em contrapartida, o número total de neurónios pode atingir milhões, ou mesmo centenas de milhões nos modelos mais avançados. Esta diferença explica que uma rede possa ser «profunda» sem ter milhares de camadas: são os milhares de neurónios por camada, multiplicados por dezenas de camadas, que dão modelos de tamanho colossal.
Caso de escola: como aprende um grande modelo de linguagem?
Um mesmo modelo, três aprendizagens sucessivas
Os grandes modelos de linguagem (LLM) ilustram bem a combinação das abordagens. O seu treino desenrola-se em várias etapas, cada uma correspondendo a um tipo de aprendizagem diferente. É o que permite a um assistente conversacional passar de um simples preditor de palavras a um interlocutor capaz de seguir instruções.
Etapa 1: o pré-treino auto-supervisionado
O modelo lê imensas quantidades de textos e aprende a prever a palavra (mais exatamente o «token») seguinte. Na frase «O Sol é uma estrela de tipo …», deve adivinhar «anã amarela» ou uma continuação plausível. Nenhum humano anota estes textos: a resposta é o próprio texto. É aprendizagem auto-supervisionada, e é a etapa mais custosa em dados e em cálculo. Modelos como o BERT utilizam uma máscara automática de tokens: um algoritmo esconde aleatoriamente certas palavras, que o modelo deve depois prever.
Etapa 2: o ajuste supervisionado sobre instruções
O modelo pré-treinado sabe prolongar um texto, mas não forçosamente responder a uma pergunta. Anotadores humanos redigem instruções e respostas, enquanto ferramentas informáticas preparam automaticamente estes dados para o treino. O modelo é depois ajustado para imitar estes exemplos: é aprendizagem supervisionada aplicada a um conjunto de dados bem mais pequeno que o corpus inicial.
Etapa 3: o reforço a partir de retornos humanos
Para afinar a qualidade das respostas, pede-se a avaliadores que classifiquem várias respostas do modelo. Estas classificações servem para treinar um modelo de recompensa, que atribui uma pontuação a uma resposta. O LLM é depois otimizado para obter pontuações elevadas. É o princípio do RLHF (aprendizagem por reforço a partir de retornos humanos), descrito em particular para o InstructGPT em 2022. Desde então, foram propostos métodos mais simples, como a otimização de preferências, onde o modelo aprende a privilegiar as respostas julgadas melhores por humanos. Certos laboratórios utilizam também recompensas verificáveis automaticamente — por exemplo a resolução correta de um problema de matemática ou o sucesso de testes informáticos — para treinar modelos ditos «de raciocínio».
E a «aprendizagem em contexto»?
Quando se fornecem dois ou três exemplos numa pergunta, o modelo parece «aprender» a tarefa: reproduz o esquema mostrado no prompt. Na realidade, trata-se de uma adaptação temporária. Os parâmetros internos do modelo não são modificados e, uma vez terminada a conversa, nada é conservado nos pesos. O modelo não faz pois mais do que explorar os exemplos fornecidos no momento, sem verdadeira aprendizagem no sentido das etapas precedentes.
Por exemplo, se se escrever:
«2 + 3 = 5»
«4 + 6 = 10»
e depois se perguntar «7 + 8 = ?», o modelo responde «15» não porque efetue uma adição, mas porque esta sequência é estatisticamente a mais provável nos textos que viu. Prolonga simplesmente um motivo familiar, sem adquirir competência duradoura em cálculo.
Síntese: as múltiplas faces da aprendizagem das IA
A tabela abaixo recapitula as diferentes abordagens, o sinal que guia a aprendizagem e os seus usos práticos.
| Tipo de aprendizagem | Princípio | Fonte do sinal | Usos correntes |
|---|---|---|---|
| Aprendizagem supervisionada | Previsão a partir de exemplos anotados. | Etiquetas fornecidas por humanos. | Visão, reconhecimento de formas, classificação, diagnóstico médico. |
| Aprendizagem não supervisionada | Descoberta de estruturas ocultas. | Propriedades internas dos dados. | Exploração, compressão, segmentação e deteção de anomalias. |
| Aprendizagem por reforço | Otimização de uma política de ação. | Recompensas e penalizações. | Robótica, jogos, controlo sequencial, alinhamento dos LLM. |
| Aprendizagem auto-supervisionada | Previsão de partes mascaradas ou em falta dos dados. | Mascaramento automático e estrutura dos próprios dados. | Pré-treino da maioria dos modelos de linguagem e de numerosos modelos de imagens. |
| Aprendizagem profunda | Extração de características em vários níveis de abstração. | Segundo o uso: etiquetas, os próprios dados ou recompensas. | Tratamento de imagens, sons e textos, previsão de estruturas de proteínas. |
| Grandes modelos de linguagem (LLM) | Encadeamento de três aprendizagens sobre uma rede profunda. | Texto bruto, depois exemplos anotados por humanos, depois otimização das preferências humanas. | Assistentes conversacionais, tradução, resumo, ajuda à programação. |
O papel central do humano e das suas ferramentas
A aprendizagem das IA não é um processo autónomo: baseia-se numa colaboração estreita entre humanos e uma panóplia de ferramentas informáticas. Os modelos não «descobrem» sozinhos o que aprender, nem como fazê-lo. São equipas humanas que organizam, orientam e controlam cada etapa, apoiando-se em infraestruturas técnicas capazes de tratar volumes de dados gigantescos.
O papel central do humano
Os humanos intervêm em todas as etapas críticas da conceção e da aprendizagem dos modelos. Sem eles, uma IA não sabe nem o que aprender, nem como, nem porquê.
- Concebem as arquiteturas (transformers, redes profundas).
- Selecionam e limpam os dados.
- Redigem as instruções e as respostas para a aprendizagem supervisionada.
- Exprimem as suas preferências para guiar os modelos (RLHF, DPO).
- Definem os objetivos, as métricas, os limites, as salvaguardas.
- Avaliam a qualidade, corrigem os desvios, ajustam os métodos.
Sem humanos, um modelo não dispõe de nenhum quadro: não tem nem meta explícita, nem critérios de sucesso, nem sinal fiável para orientar a sua aprendizagem.
O papel indispensável das ferramentas
As ferramentas informáticas tornam possível a aprendizagem em grande escala. Automatizam as tarefas repetitivas, estruturam os dados e exploram recursos materiais consideráveis. Sem elas, a aprendizagem moderna das IA seria materialmente impossível.
- Mascaram automaticamente tokens para o auto-supervisionado.
- Preparam os dados (formatação, validação, deduplicação).
- Distribuem o trabalho a milhares de anotadores.
- Verificam automaticamente certas recompensas (problemas de matemática, testes informáticos).
- Treinam os modelos sobre centenas de GPU.
- Otimizam as preferências humanas em grande escala.
Os volumes de dados são demasiado grandes, os modelos demasiado pesados e as tarefas demasiado numerosas para serem geridos manualmente. A aprendizagem das IA é pois o resultado de uma aliança: a intenção e o julgamento humanos, amplificados por ferramentas informáticas potentes.
Referências
- Wikipédia – Aprendizagem automática (nova janela)
- Wikipédia – Aprendizagem supervisionada (nova janela)
- Wikipédia – Aprendizagem não supervisionada (nova janela)
- Wikipédia – Aprendizagem por reforço (nova janela)
- Wikipédia – Aprendizagem profunda (nova janela)
- LeCun, Y., Bengio, Y., Hinton, G. – «Deep learning», Nature, vol. 521, 2015 (nova janela)
- Sutton, R. S., Barto, A. G. – «Reinforcement Learning: An Introduction», 2.ª ed., MIT Press, 2018 (nova janela)
- Ouyang, L. et al. – «Training language models to follow instructions with human feedback», NeurIPS, 2022 (arXiv:2203.02155) (nova janela)
- Devlin, J., Chang, M.-W., Lee, K., Toutanova, K. – «BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding», NAACL, 2019 (arXiv:1810.04805) (nova janela)
FAQ: Tudo o que há para saber sobre os tipos de aprendizagem das IA
Quais são os principais tipos de aprendizagem das IA?
Os principais tipos de aprendizagem das IA são a aprendizagem supervisionada, a aprendizagem não supervisionada, a aprendizagem por reforço e a aprendizagem auto-supervisionada. Cada um corresponde a uma maneira diferente de apresentar os dados e de definir o objetivo do algoritmo. A aprendizagem profunda não é um tipo da mesma natureza: designa o uso de redes de neurónios de várias camadas, que podem ser treinadas segundo cada uma destas abordagens.
O que é a aprendizagem supervisionada?
A aprendizagem supervisionada consiste em treinar um modelo sobre exemplos anotados. Cada entrada está associada a uma etiqueta que indica a resposta correta. O modelo aprende a prever estas etiquetas para novas entradas minimizando uma função de perda.
O que é a aprendizagem não supervisionada?
A aprendizagem não supervisionada trabalha sobre dados sem etiquetas. O algoritmo procura estruturas ocultas, como grupos ou motivos. É utilizada para o clustering, a redução de dimensão e a deteção de anomalias.
O que é a aprendizagem por reforço?
A aprendizagem por reforço põe em cena um agente que interage com um ambiente. O agente recebe recompensas ou penalizações em função das suas ações e aprende uma política que maximiza a recompensa acumulada. Esta abordagem é utilizada em robótica, em jogos e em controlo sequencial, assim como para alinhar os modelos de linguagem com as preferências humanas.
O que é a aprendizagem profunda?
A aprendizagem profunda utiliza redes de neurónios de várias camadas para tratar dados complexos. Estas redes aprendem representações internas que capturam regularidades nos dados. A aprendizagem profunda está no coração dos progressos recentes em visão, em processamento de linguagem e em reconhecimento de formas.
Porque se fala de aprendizagem auto-supervisionada?
A aprendizagem auto-supervisionada cria tarefas internas a partir dos próprios dados. Por exemplo, mascaram-se partes de um texto e pede-se ao modelo que as preveja. Esta abordagem permite aprender representações úteis sem etiquetas externas, o que é particularmente importante para os modelos de linguagem.
Como aprende um modelo como o ChatGPT, o Claude ou o Gemini?
Um grande modelo de linguagem aprende em várias etapas. Primeiro é pré-treinado de maneira auto-supervisionada para prever a palavra seguinte sobre imensos corpus de textos. Depois é ajustado de maneira supervisionada sobre exemplos de instruções e respostas redigidos por humanos. Finalmente, é afinado por aprendizagem por reforço, a partir de classificações de respostas estabelecidas por avaliadores ou de recompensas verificáveis automaticamente.
Como se arranjam as máquinas para aprender?
As máquinas aprendem ajustando parâmetros internos para reduzir uma diferença entre as suas previsões e um sinal de referência. Este sinal pode ser uma etiqueta, uma estrutura oculta, uma recompensa ou uma tarefa auto-supervisionada. Os algoritmos de otimização, como a descida de gradiente, atualizam os parâmetros para melhorar progressivamente os desempenhos.
 Os diferentes tipos de aprendizagem das IA
 IA Agêntica: Quando as máquinas se tornam autônomas
 O que a IA não pode fazer
 Inteligência artificial e astronomia: Compreender o papel dos assistentes IA
 Ferramentas de IA: como escolher?

 IA Generativa vs AGI: Onde termina a imitação e onde começa a consciência?
 Redes artificiais vs. redes biológicas: Dois sistemas, uma arquitetura comum
 Cérebro Humano e Inteligências Artificiais: Semelhanças e Diferenças
 AlphaGo contra AlphaGo Zero: Uma Revolução na Inteligência Artificial
 O próximo passo das máquinas inteligentes
 Do Neurônio Biológico ao Neurônio Formal: Simplificação do Cérebro
 Inteligência artificial: a explosão do gigantismo
 Quando a inteligência artificial enlouquece!
 Como as máquinas se tornam inteligentes
 Inteligência artificial: ameaça real ou oportunidade para a humanidade?
 Como as máquinas entendem, interpretam e geram linguagem de maneira semelhante aos humanos?
 Como funciona uma rede neural artificial?