


Le trajet du prompt à la réponse : dans les coulisses d'un LLM
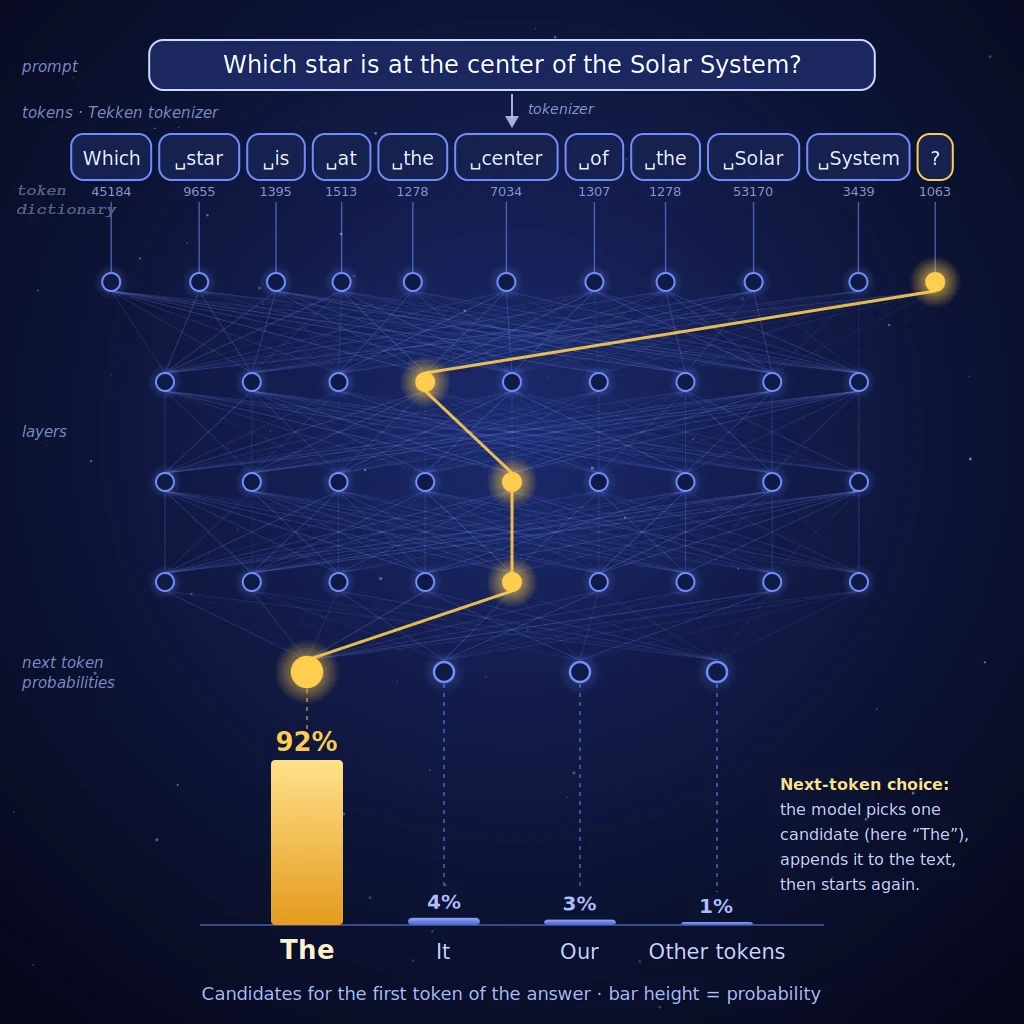
Visualisation artistique d'un texte découpé en tokens qui traverse les couches d'un réseau de neurones artificiels, illustrant le calcul de probabilités par lequel un grand modèle de langage (LLM) produit sa réponse mot après mot.
Source image : astronoo.com (nouvelle fenêtre) : image générée par IA, domaine public.
Résumé scientifique
Cet article décrit pas à pas le trajet d'une question posée à une intelligence artificielle conversationnelle, du clavier de l'utilisateur à la réponse affichée. Un grand modèle de langage (LLM) ne consulte pas une base de faits : il calcule, token après token, la probabilité du mot suivant à l'aide de centaines de milliards de coefficients ajustés pendant l'entraînement. Deux schémas commentés séparent la phase d'apprentissage, où naissent les coefficients, de la phase d'inférence, où ils sont utilisés. Le second schéma localise chaque composant : navigateur, service d'IA, cloud et processeurs graphiques (GPU). L'article distingue la logique (le code) des coefficients (le modèle), précise ce que le modèle ne contient plus (les données d'apprentissage) et rappelle les simplifications des schémas.
Que se passe-t-il entre votre question et la réponse d'une IA ?
Un calcul de probabilités, pas une base de connaissances
Lorsque vous posez une question à un assistant comme Claude, ChatGPT ou Gemini, votre texte traverse trois endroits différents : votre appareil, les serveurs de l'éditeur, puis un centre de données équipé de GPU. C'est dans ce dernier que tourne le LLM, un programme qui utilise un immense tableau de nombres, le modèle, pour prédire le token suivant.
Un token est un morceau de texte : un mot, une partie de mot, un signe de ponctuation ou un nombre. Toute la réponse est construite ainsi, un token à la fois, chaque nouveau token étant choisi parmi des candidats dont le modèle a calculé la probabilité. Les deux schémas ci-dessous montrent d'abord comment ces nombres sont fabriqués, puis comment ils sont utilisés.
À découvrir aussi
Poursuivez votre exploration de l'Univers avec ces sujets :
Phase 1 : l'apprentissage, là où naissent les coefficients
N.B. :
Phase d'apprentissage : un corpus de texte, découpé en tokens, sert à ajuster les coefficients du modèle. Les ordres de grandeur sont indicatifs.
Les sources : un immense corpus de texte
Livres, Wikipédia, articles, sites web, code informatique : le corpus d'entraînement est d'abord découpé en tokens. Pour les modèles dont les chiffres sont publiés, l'ordre de grandeur se compte en dizaines de milliers de milliards de tokens : environ 15 000 milliards pour Llama 3, de Meta (2024). Les éditeurs des modèles commerciaux les plus récents ne communiquent généralement pas ces valeurs.
L'entraînement : ajuster des coefficients
Le principe est simple. On présente au modèle un début de texte, il prédit le token suivant, on compare sa prédiction à la vraie suite, puis on corrige très légèrement les coefficients pour que la bonne réponse devienne un peu plus probable. Cette correction, calculée par rétropropagation du gradient, est répétée des milliards de fois sur des milliers de GPU, pendant des semaines ou des mois.
Un second entraînement, plus court, oriente ensuite le comportement du modèle : répondre à des questions, suivre des consignes, refuser certaines demandes, adopter un ton. Il s'appuie en partie sur des évaluations humaines.
Ce qui reste après l'entraînement
Il ne reste que les coefficients, aussi appelés paramètres du modèle : de 100 à 1000 milliards de nombres pour les grands modèles actuels. Les textes ne sont pas rangés dans le modèle comme dans une bibliothèque : ils ont seulement façonné ces valeurs. Un modèle peut restituer certains passages très répandus (mémorisation partielle), mais il ne peut pas « relire » un livre.
Phase 2 : l'inférence, du prompt à la réponse
N.B. :
Phase d'inférence : quatre zones, de votre appareil au cloud, puis retour. Les numéros de tokens et les probabilités sont donnés à titre d'exemple.
Le schéma est découpé en quatre zones colorées qui indiquent où se trouve chaque composant. Les zones 1 et 4 (bleu) sont sur votre appareil, la zone 2 (orangé) est le service d'IA de l'éditeur, la zone 3 (vert) est le cloud, c'est-à-dire un centre de données.
Zone 1 : votre appareil
Le navigateur ou l'application mobile se contente de recueillir votre texte et d'afficher la réponse. Pour les grands modèles, aucun calcul d'IA n'a lieu à cet endroit, car les coefficients occupent des centaines de gigaoctets. Seuls de petits modèles compacts peuvent tourner en local sur un ordinateur ou un téléphone récent.
Zone 2 : le service d'IA de l'éditeur
Votre texte voyage par Internet (protocole HTTPS) jusqu'aux serveurs d'application de l'éditeur. Une passerelle vérifie votre identité et vos quotas, applique des filtres de sécurité, puis assemble le prompt complet : les consignes du système, l'historique de la conversation et votre dernière question.
Ce détail est essentiel : le modèle ne garde aucune mémoire de la conversation. C'est le service qui lui renvoie tout l'historique à chaque question, dans la limite de la fenêtre de contexte, c'est-à-dire du nombre maximal de tokens que le modèle peut lire d'un coup. Ce service, avec son application, ses filtres et son historique, est ce que l'on appelle couramment « l'IA ». Le LLM n'en est qu'un composant.
Zone 3 : le cloud et ses GPU
Le prompt complet est transmis par le réseau interne du centre de données à des serveurs équipés de GPU ou de TPU, des puces conçues pour effectuer en parallèle d'énormes multiplications de matrices. Le modèle, qui occupe de 200 Go à plusieurs téraoctets, est réparti dans la mémoire de plusieurs puces. C'est ici qu'on trouve le LLM au sens strict : un programme d'inférence associé au modèle.
Dans le cloud : sept étapes de calcul
1. Tokenisation
Le texte est découpé en tokens à l'aide d'un dictionnaire fixé avant l'entraînement (méthode dite byte-pair encoding). Chaque token reçoit un numéro. Les mots fréquents forment un seul token, les mots rares sont coupés en morceaux. Le vocabulaire compte de l'ordre de 100 000 à 200 000 tokens.
2. Plongement (embedding)
Chaque numéro de token est remplacé par un vecteur, une liste de milliers de nombres (16 384 pour le plus grand modèle Llama 3). On y ajoute l'information de position, car l'ordre des mots change le sens. Ces vecteurs sont eux-mêmes des coefficients appris pendant l'entraînement.
3. Les blocs Transformer : l'attention
Le cœur du modèle est une pile de blocs Transformer, architecture proposée en 2017. Les grands modèles en comptent de l'ordre de 80 à 130. Dans chaque bloc, le mécanisme d'attention compare chaque token aux tokens précédents et calcule leur importance relative : dans « Au centre du Système solaire se trouve le », les mots « centre » et « solaire » pèsent lourd pour prédire la suite. Les matrices qui décident à quoi prêter attention (notées Q, K, V et O) sont des coefficients.
4. Les blocs Transformer : le réseau feed-forward
Chaque bloc contient aussi un réseau feed-forward, qui transforme chaque vecteur par deux grandes multiplications de matrices séparées par une fonction d'activation. Des travaux d'interprétabilité suggèrent que ces couches servent en grande partie de mémoire à des associations apprises, mais cette interprétation reste une hypothèse de recherche.
Dans ces deux étapes, la logique est identique à chaque bloc, car c'est le même code. Seuls les coefficients diffèrent d'un bloc à l'autre.
5. Scores et probabilités
À la sortie du dernier bloc, le modèle attribue un score (logit) à chacun des tokens du vocabulaire. La fonction softmax convertit ces scores en probabilités dont la somme vaut 100 %. Dans l'exemple du schéma, « Soleil » obtient 92 %, « Lune » 4 %, « Jupiter » 3 % et tous les autres tokens ensemble 1 %.
6. Échantillonnage
Le token n'est pas toujours le plus probable. Un réglage appelé température aplatit ou accentue les probabilités, et la méthode top-p limite le tirage aux candidats les plus probables. À température très basse, la réponse est quasi déterministe ; plus haute, elle varie d'une fois sur l'autre. C'est pourquoi la même question ne produit pas toujours la même réponse.
7. La boucle de génération
Le token choisi, ici « Soleil », est ajouté au texte, et tout le cycle recommence pour calculer le token suivant, jusqu'à ce que le modèle produise un token spécial de fin. Une réponse de 300 mots demande donc plusieurs centaines de passages successifs dans le modèle.
Zone 4 : le retour vers votre écran
Les tokens ne sont pas attendus tous ensemble : chacun est renvoyé dès qu'il est calculé (streaming), en repassant par le service d'IA puis par Internet. Votre appareil les affiche au fur et à mesure, ce qui donne l'impression d'une réponse « écrite en direct ».
Logique et coefficients : que contient vraiment un modèle ?
On confond souvent trois choses : le code qui effectue les calculs, les coefficients qui en déterminent le résultat, et les données qui ont servi à fixer ces coefficients. Le tableau ci-dessous les sépare.
| Élément | Nature | Origine | Présent pendant la réponse ? |
|---|---|---|---|
| Logique | Code et architecture (attention, feed-forward, softmax) | Écrite par des humains | Oui, exécutée à chaque token |
| Coefficients | 100 à 1000 milliards de nombres | Ajustés par l'entraînement | Oui, lus en mémoire GPU, jamais modifiés |
| Données d'apprentissage | Livres, pages web, code | Collectées avant l'entraînement | Non, seules les traces dans les coefficients subsistent |
| Prompt et historique | Texte de la conversation | Vous et le service d'IA | Oui, relu en entier à chaque question |
Où se trouve chaque composant ?
| Composant | Emplacement | Rôle |
|---|---|---|
| Navigateur ou application | Votre appareil | Saisie du prompt, affichage de la réponse |
| Passerelle et orchestration | Serveurs du service d'IA | Authentification, quotas, filtres, assemblage du prompt |
| Programme d'inférence | Serveurs GPU du cloud | Exécute les sept étapes de calcul |
| Modèle | Mémoire des GPU | Fournit les coefficients qui déterminent les probabilités |
| Données d'apprentissage | Hors du circuit de réponse | Ont servi uniquement à l'entraînement |
Les limites du schéma
Un schéma volontairement simplifié
Les schémas laissent de côté plusieurs éléments : les mélanges d'experts, où seule une partie des coefficients est activée pour chaque token ; la mémoire cache des calculs d'attention, qui évite de tout recalculer à chaque token ; les normalisations et connexions résiduelles à l'intérieur des blocs ; les outils externes (recherche web, exécution de code) que le service d'IA peut appeler ; et le traitement des images ou des sons. Selon les éditeurs, la tokenisation peut aussi s'effectuer dans le service d'IA plutôt que sur le serveur GPU.
Pourquoi une IA peut se tromper avec aplomb
Puisque le modèle choisit des tokens plausibles, et non des faits vérifiés, il peut produire une phrase fluide mais fausse, qu'on appelle une hallucination. Rien dans le calcul ne distingue un fait appris d'une suite de mots vraisemblable : seule la probabilité compte. Les connexions à des sources externes et la vérification humaine restent donc indispensables.
Ce qu'il faut retenir
Un LLM est d'abord un programme qui multiplie des matrices, associé à un modèle qui est un immense tableau de coefficients. Ces coefficients ont été fixés par l'entraînement sur d'énormes corpus de texte, puis figés. À chaque question, le texte voyage de votre appareil jusqu'à un centre de données, traverse sept étapes de calcul, produit un token, puis recommence.
Cette mécanique explique à la fois la puissance de ces systèmes et leurs limites : ils excellent à continuer un texte de façon plausible, et n'ont pas de mémoire propre de la conversation ni de garantie de vérité. Comprendre où se trouve chaque composant, c'est aussi comprendre où se situent les enjeux de calcul, d'énergie et de confidentialité.
Références
FAQ : Comment fonctionne un LLM
Qu'est-ce qu'un token ?
Un token est l'unité de texte manipulée par le modèle : un mot fréquent, un morceau de mot, un signe de ponctuation ou un nombre. Un texte en français compte en général un peu plus de tokens que de mots.
Un LLM comprend-il ce qu'il dit ?
Mécaniquement, il calcule la probabilité du token suivant. Ses représentations internes capturent pourtant de nombreuses relations entre les concepts, et la question de savoir si cela constitue une forme de compréhension reste débattue en IA et en sciences cognitives.
Le modèle apprend-il de ma conversation ?
Pendant la conversation, les coefficients ne sont pas modifiés : le modèle est figé. Le service peut en revanche conserver l'historique pour vous le rendre, et certains éditeurs peuvent utiliser des conversations pour préparer de futures versions, selon leur politique et vos réglages.
Pourquoi les GPU sont-ils indispensables ?
Le calcul d'un token se résume à d'énormes multiplications de matrices. Les GPU en effectuent des milliers en parallèle et disposent d'une mémoire rapide pour stocker les coefficients, ce que ne permettent pas les processeurs classiques à cette échelle.
Peut-on faire tourner un LLM sur son propre ordinateur ?
Oui, pour des modèles de taille réduite, souvent quantifiés (coefficients stockés avec moins de précision). Les plus grands modèles exigent en revanche plusieurs GPU et dépassent les capacités d'un ordinateur personnel.
Pourquoi la réponse change-t-elle d'une fois sur l'autre ?
Parce que l'étape d'échantillonnage tire le token au hasard selon les probabilités. Avec une température très basse, la réponse devient presque identique d'une exécution à l'autre.
Qu'est-ce qu'une hallucination ?
C'est une réponse plausible mais fausse. Elle survient parce que le modèle choisit des tokens vraisemblables, sans vérifier les faits qu'ils énoncent.
 Le trajet du prompt à la réponse : dans les coulisses d'un LLM
 Le token : l’unité fondamentale des grands modèles de langage
 Les différents types d'apprentissage des IA
 IA Agentique : Quand les machines deviennent autonomes
 Ce que les IA ne savent pas faire
 Intelligence artificielle et astronomie : Comprendre le rôle des assistants IA
 Outils d’intelligence artificielle : comment choisir ?

 IA Générative vs AGI: Où s’arrête l’imitation, où commence la conscience?
 Réseaux artificiels vs réseaux biologiques: Deux systèmes, une architecture commune
 Cerveau Humain et Intelligences Artificielles: Similitudes et Différences
 AlphaGo contre AlphaGo Zero: Une Révolution dans l'Intelligence Artificielle
 La prochaine étape des machines intelligentes
 Du Neurone Biologique au Neurone Formel: Simplification du Cerveau
 Intelligence artificielle: l'explosion du gigantisme
 Quand l'intelligence artificielle devient folle!
 Comment les machines deviennent intelligentes
 Intelligence artificielle : menace réelle ou opportunité pour l'humanité ?
 Comment les machines comprennent, interprètent et génèrent un langage de manière similaire à celle des humains?
 Comment fonctionne un réseau de neurones artificiels?