


El recorrido del prompt a la respuesta: entre bastidores de un LLM
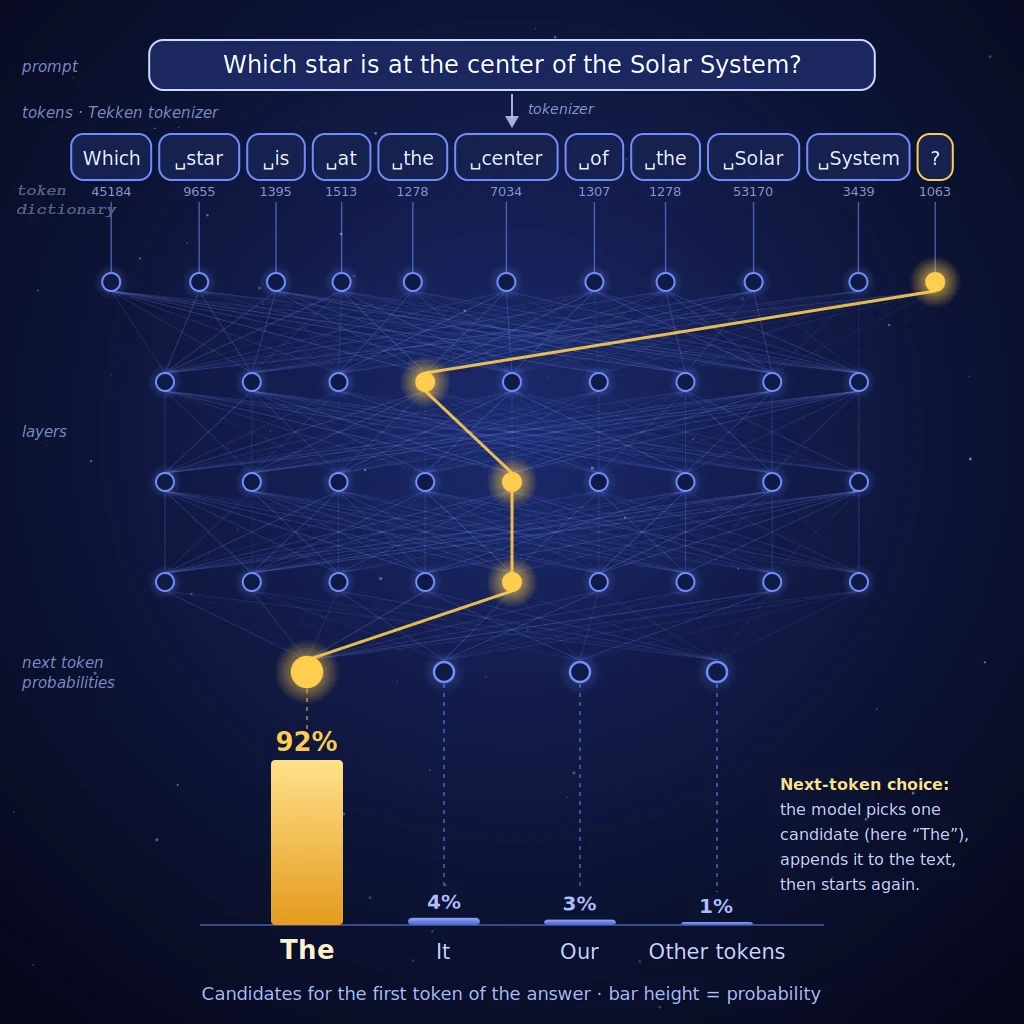
Visualización artística de un texto cortado en tokens que atraviesa las capas de una red de neuronas artificiales, ilustrando el cálculo de probabilidades mediante el cual un gran modelo de lenguaje (LLM) produce su respuesta palabra a palabra.
Fuente de la imagen: astronoo.com (nueva ventana): imagen generada por IA, dominio público.
Resumen científico
Este artículo describe paso a paso el recorrido de una pregunta formulada a una inteligencia artificial conversacional, desde el teclado del usuario hasta la respuesta mostrada. Un gran modelo de lenguaje (LLM) no consulta una base de hechos: calcula, token a token, la probabilidad de la palabra siguiente mediante cientos de miles de millones de coeficientes ajustados durante el entrenamiento. Dos esquemas comentados separan la fase de aprendizaje, donde nacen los coeficientes, de la fase de inferencia, donde se utilizan. El segundo esquema localiza cada componente: navegador, servicio de IA, nube y unidades de procesamiento gráfico (GPU). El artículo distingue la lógica (el código) de los coeficientes (el modelo), precisa lo que el modelo ya no contiene (los datos de entrenamiento) y recuerda las simplificaciones de los esquemas.
¿Qué ocurre entre tu pregunta y la respuesta de una IA?
Un cálculo de probabilidades, no una base de conocimientos
Cuando formulas una pregunta a un asistente como Claude, ChatGPT o Gemini, tu texto atraviesa tres lugares distintos: tu dispositivo, los servidores del editor y luego un centro de datos equipado con GPU. Es en este último donde se ejecuta el LLM, un programa que utiliza una enorme tabla de números, el modelo, para predecir el token siguiente.
Un token es un fragmento de texto: una palabra, parte de una palabra, un signo de puntuación o un número. Toda la respuesta se construye así, un token a la vez, eligiéndose cada nuevo token entre candidatos cuya probabilidad ha calculado el modelo. Los dos esquemas siguientes muestran primero cómo se fabrican estos números y después cómo se utilizan.
También para descubrir
Continúe su exploración del Universo con estos temas:
Fase 1: el aprendizaje, donde nacen los coeficientes
N.B.:
Fase de aprendizaje: un corpus de texto, cortado en tokens, sirve para ajustar los coeficientes del modelo. Los órdenes de magnitud son indicativos.
Las fuentes: un inmenso corpus de texto
Libros, Wikipedia, artículos, sitios web, código informático: el corpus de entrenamiento se corta primero en tokens. Para los modelos cuyas cifras se publican, el orden de magnitud se cuenta en decenas de miles de miles de millones de tokens: unos 15.000 mil millones para Llama 3, de Meta (2024). Los editores de los modelos comerciales más recientes generalmente no comunican estos valores.
El entrenamiento: ajustar coeficientes
El principio es simple. Se presenta al modelo el inicio de un texto, este predice el token siguiente, se compara su predicción con la continuación real y luego se corrigen muy ligeramente los coeficientes para que la respuesta correcta se vuelva un poco más probable. Esta corrección, calculada por retropropagación del gradiente, se repite miles de millones de veces en miles de GPU, durante semanas o meses.
Un segundo entrenamiento, más corto, orienta después el comportamiento del modelo: responder a preguntas, seguir instrucciones, rechazar ciertas solicitudes, adoptar un tono. Se apoya en parte en evaluaciones humanas.
Lo que queda después del entrenamiento
Solo quedan los coeficientes, también llamados parámetros del modelo: de 100 a 1000 mil millones de números para los grandes modelos actuales. Los textos no se guardan en el modelo como en una biblioteca: solo han modelado esos valores. Un modelo puede reproducir ciertos pasajes muy difundidos (memorización parcial), pero no puede "releer" un libro.
Fase 2: la inferencia, del prompt a la respuesta
N.B.:
Fase de inferencia: cuatro zonas, de tu dispositivo a la nube, y luego vuelta. Los números de tokens y las probabilidades se dan a título de ejemplo.
El esquema está dividido en cuatro zonas coloreadas que indican dónde se encuentra cada componente. Las zonas 1 y 4 (azul) están en tu dispositivo, la zona 2 (naranja) es el servicio de IA del editor, la zona 3 (verde) es la nube, es decir, un centro de datos.
Zona 1: tu dispositivo
El navegador o la aplicación móvil se limita a recoger tu texto y a mostrar la respuesta. Para los grandes modelos, aquí no tiene lugar ningún cálculo de IA, pues los coeficientes ocupan cientos de gigabytes. Solo los modelos compactos pequeños pueden ejecutarse localmente en un ordenador o un teléfono reciente.
Zona 2: el servicio de IA del editor
Tu texto viaja por Internet (protocolo HTTPS) hasta los servidores de aplicación del editor. Una pasarela verifica tu identidad y tus cuotas, aplica filtros de seguridad y luego ensambla el prompt completo: las instrucciones del sistema, el historial de la conversación y tu última pregunta.
Este detalle es esencial: el modelo no guarda ninguna memoria de la conversación. Es el servicio el que le devuelve todo el historial en cada pregunta, dentro del límite de la ventana de contexto, es decir, del número máximo de tokens que el modelo puede leer de una vez. Este servicio, con su aplicación, sus filtros y su historial, es lo que se llama comúnmente "la IA". El LLM solo es un componente de ella.
Zona 3: la nube y sus GPU
El prompt completo se transmite por la red interna del centro de datos a servidores equipados con GPU o TPU, chips diseñados para efectuar en paralelo enormes multiplicaciones de matrices. El modelo, que ocupa de 200 GB a varios terabytes, se reparte en la memoria de varios chips. Aquí es donde se encuentra el LLM en sentido estricto: un programa de inferencia asociado al modelo.
En la nube: siete etapas de cálculo
1. Tokenización
El texto se corta en tokens mediante un diccionario fijado antes del entrenamiento (método llamado byte-pair encoding). Cada token recibe un número. Las palabras frecuentes forman un solo token; las palabras raras se cortan en fragmentos. El vocabulario cuenta del orden de 100.000 a 200.000 tokens.
2. Embedding (incrustación)
Cada número de token se sustituye por un vector, una lista de miles de números (16.384 para el mayor modelo Llama 3). Se añade la información de posición, pues el orden de las palabras cambia el sentido. Estos vectores son a su vez coeficientes aprendidos durante el entrenamiento.
3. Los bloques Transformer: la atención
El corazón del modelo es una pila de bloques Transformer, arquitectura propuesta en 2017. Los grandes modelos cuentan del orden de 80 a 130. En cada bloque, el mecanismo de atención compara cada token con los tokens precedentes y calcula su importancia relativa: en "En el centro del Sistema Solar se encuentra el", las palabras "centro" y "Solar" pesan mucho para predecir la continuación. Las matrices que deciden a qué prestar atención (denotadas Q, K, V y O) son coeficientes.
4. Los bloques Transformer: la red feed-forward
Cada bloque contiene también una red feed-forward, que transforma cada vector mediante dos grandes multiplicaciones de matrices separadas por una función de activación. Trabajos de interpretabilidad sugieren que estas capas sirven en gran parte de memoria de asociaciones aprendidas, pero esta interpretación sigue siendo una hipótesis de investigación.
En estas dos etapas, la lógica es idéntica en cada bloque, pues es el mismo código. Solo los coeficientes difieren de un bloque a otro.
5. Puntuaciones y probabilidades
A la salida del último bloque, el modelo asigna una puntuación (logit) a cada uno de los tokens del vocabulario. La función softmax convierte estas puntuaciones en probabilidades cuya suma vale 100%. En el ejemplo del esquema, "Sol" obtiene 92%, "Luna" 4%, "Júpiter" 3% y todos los demás tokens juntos 1%.
6. Muestreo
El token no siempre es el más probable. Un ajuste llamado temperatura aplana o acentúa las probabilidades, y el método top-p limita el sorteo a los candidatos más probables. A temperatura muy baja, la respuesta es casi determinista; más alta, varía de una vez a otra. Por eso la misma pregunta no produce siempre la misma respuesta.
7. El bucle de generación
El token elegido, aquí "Sol", se añade al texto, y todo el ciclo recomienza para calcular el token siguiente, hasta que el modelo produce un token especial de fin. Una respuesta de 300 palabras exige por tanto varios cientos de pasos sucesivos por el modelo.
Zona 4: el regreso a tu pantalla
Los tokens no se esperan todos juntos: cada uno se devuelve en cuanto se calcula (streaming), pasando de nuevo por el servicio de IA y luego por Internet. Tu dispositivo los muestra a medida que llegan, lo que da la impresión de una respuesta "escrita en directo".
Lógica y coeficientes: ¿qué contiene realmente un modelo?
A menudo se confunden tres cosas: el código que efectúa los cálculos, los coeficientes que determinan el resultado y los datos que sirvieron para fijar esos coeficientes. La tabla siguiente las separa.
| Elemento | Naturaleza | Origen | ¿Presente durante la respuesta? |
|---|---|---|---|
| Lógica | Código y arquitectura (atención, feed-forward, softmax) | Escrita por humanos | Sí, ejecutada en cada token |
| Coeficientes | 100 a 1000 mil millones de números | Ajustados por el entrenamiento | Sí, leídos en memoria GPU, nunca modificados |
| Datos de entrenamiento | Libros, páginas web, código | Recogidos antes del entrenamiento | No, solo subsisten las huellas en los coeficientes |
| Prompt e historial | Texto de la conversación | Tú y el servicio de IA | Sí, releído entero en cada pregunta |
¿Dónde se encuentra cada componente?
| Componente | Ubicación | Función |
|---|---|---|
| Navegador o aplicación | Tu dispositivo | Introducción del prompt, visualización de la respuesta |
| Pasarela y orquestación | Servidores del servicio de IA | Autenticación, cuotas, filtros, ensamblaje del prompt |
| Programa de inferencia | Servidores GPU de la nube | Ejecuta las siete etapas de cálculo |
| Modelo | Memoria de las GPU | Proporciona los coeficientes que determinan las probabilidades |
| Datos de entrenamiento | Fuera del circuito de respuesta | Sirvieron únicamente para el entrenamiento |
Los límites del esquema
Un esquema deliberadamente simplificado
Los esquemas dejan de lado varios elementos: las mezclas de expertos, donde solo una parte de los coeficientes se activa para cada token; la memoria caché de los cálculos de atención, que evita recalcularlo todo en cada token; las normalizaciones y conexiones residuales en el interior de los bloques; las herramientas externas (búsqueda web, ejecución de código) que el servicio de IA puede llamar; y el tratamiento de imágenes o sonidos. Según los editores, la tokenización también puede efectuarse en el servicio de IA en lugar de en el servidor GPU.
Por qué una IA puede equivocarse con aplomo
Puesto que el modelo elige tokens plausibles, y no hechos verificados, puede producir una frase fluida pero falsa, que se llama una alucinación. Nada en el cálculo distingue un hecho aprendido de una sucesión de palabras verosímil: solo cuenta la probabilidad. Las conexiones con fuentes externas y la verificación humana siguen siendo, por tanto, indispensables.
Lo que hay que recordar
Un LLM es ante todo un programa que multiplica matrices, asociado a un modelo que es una inmensa tabla de coeficientes. Estos coeficientes fueron fijados por el entrenamiento sobre enormes corpus de texto, y luego congelados. En cada pregunta, el texto viaja de tu dispositivo hasta un centro de datos, atraviesa siete etapas de cálculo, produce un token y luego recomienza.
Este mecanismo explica a la vez la potencia de estos sistemas y sus límites: sobresalen en continuar un texto de manera plausible, y no tienen memoria propia de la conversación ni garantía de verdad. Comprender dónde se encuentra cada componente es también comprender dónde se sitúan las cuestiones de cálculo, energía y confidencialidad.
Referencias
FAQ: Cómo funciona un LLM
¿Qué es un token?
Un token es la unidad de texto manipulada por el modelo: una palabra frecuente, un fragmento de palabra, un signo de puntuación o un número. Un texto en español suele tener un poco más de tokens que de palabras.
¿Comprende un LLM lo que dice?
Mecánicamente, calcula la probabilidad del token siguiente. Sus representaciones internas capturan, sin embargo, numerosas relaciones entre los conceptos, y la cuestión de si eso constituye una forma de comprensión sigue debatiéndose en IA y en ciencias cognitivas.
¿Aprende el modelo de mi conversación?
Durante la conversación, los coeficientes no se modifican: el modelo está congelado. El servicio puede, en cambio, conservar el historial para devolvértelo, y algunos editores pueden utilizar conversaciones para preparar futuras versiones, según su política y tus ajustes.
¿Por qué son indispensables las GPU?
El cálculo de un token se reduce a enormes multiplicaciones de matrices. Las GPU efectúan miles en paralelo y disponen de una memoria rápida para almacenar los coeficientes, lo que los procesadores clásicos no permiten a esta escala.
¿Se puede ejecutar un LLM en el propio ordenador?
Sí, para modelos de tamaño reducido, a menudo cuantizados (coeficientes almacenados con menos precisión). Los modelos más grandes exigen, en cambio, varias GPU y superan las capacidades de un ordenador personal.
¿Por qué cambia la respuesta de una vez a otra?
Porque la etapa de muestreo sortea el token al azar según las probabilidades. Con una temperatura muy baja, la respuesta se vuelve casi idéntica de una ejecución a otra.
¿Qué es una alucinación?
Es una respuesta plausible pero falsa. Surge porque el modelo elige tokens verosímiles, sin verificar los hechos que enuncian.
 El recorrido del prompt a la respuesta: entre bastidores de un LLM
 El token: la unidad fundamental de los grandes modelos de lenguaje
 Los diferentes tipos de aprendizaje de las IA
 IA Agentica: Cuando las máquinas se vuelven autónomas
 Lo que la IA no puede hacer
 Inteligencia artificial y astronomía: Comprender el papel de los asistentes IA
 Herramientas de IA: ¿cómo elegir?

 IA Generativa vs AGI: ¿Dónde termina la imitación y dónde comienza la conciencia?
 Redes artificiales vs. redes biológicas: Dos sistemas, una arquitectura común
 Cerebro Humano e Inteligencias Artificiales: Similitudes y Diferencias
 AlphaGo contra AlphaGo Zero: Una Revolución en la Inteligencia Artificial
 El Próximo Paso para las Máquinas Inteligentes
 El primer paso hacia el surgimiento de la vida
 De la Neurona Biológica a la Neurona Formal: Simplificación del Cerebro
 Inteligencia artificial: la explosión del gigantismo
 ¡Cuando la inteligencia artificial se vuelve loca!
 Cómo las máquinas se vuelven inteligentes
 Inteligencia artificial: ¿amenaza real u oportunidad para la humanidad?
 ¿Cómo las máquinas entienden, interpretan y generan el lenguaje de forma similar a los humanos?
 ¿Cómo funciona una red neuronal artificial?