


El token: la unidad fundamental de los grandes modelos de lenguaje
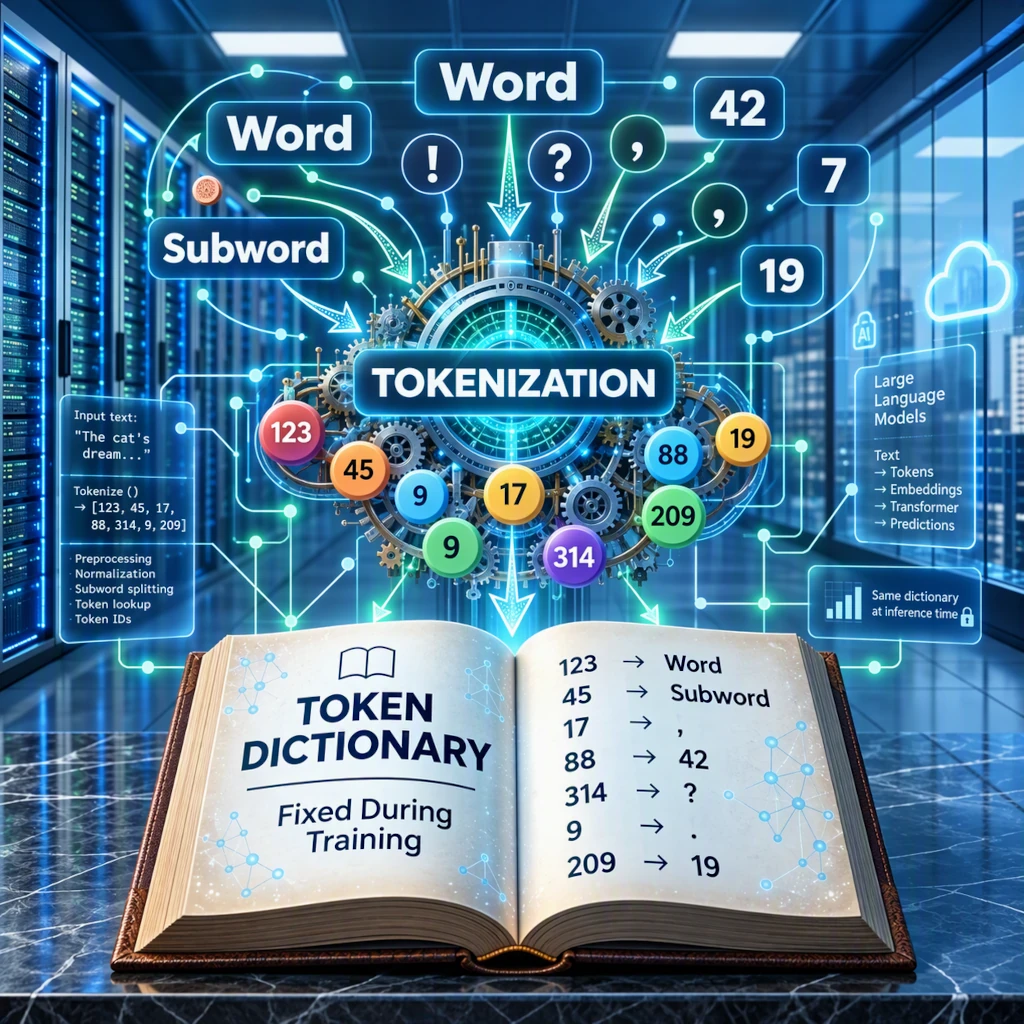
Ilustración del proceso de tokenización en la nube: transformación de palabras, partes de palabras y puntuaciones en tokens numéricos referenciados en un diccionario de entrenamiento.
Fuente de la imagen: astronoo.com (nueva ventana): imagen generada por IA, dominio público.
Resumen científico
Este artículo describe el token, la unidad elemental de texto manipulada por un gran modelo de lenguaje (LLM). Antes de cualquier cálculo, el texto es dividido por un tokenizer en fragmentos (palabras enteras, trozos de palabras, puntuación, números), cada uno asociado a un número en un diccionario fijado antes del entrenamiento. Este diccionario se construye a partir de las frecuencias observadas en un corpus muy grande, por ejemplo mediante byte-pair encoding. El ejemplo "Explique-moi la photosynthèse simplement." se divide en 9 tokens por el tokenizer Tekken de Mistral y en 13 por el de Mistral 7B: la división depende del modelo. El artículo examina lo que revela esta segmentación, su papel en la longitud del contexto, el coste de cálculo y los límites del modelo, y luego el paso del número al vector mediante el embedding.
¿Qué es un token, y por qué una IA no lee palabras?
Un fragmento de texto transformado en número
Un token es un fragmento de texto: una palabra entera, una parte de palabra, un signo de puntuación o un número. Un LLM nunca recibe letras ni palabras, sino una secuencia de números, cada uno designando un token en un diccionario de varias decenas de miles de entradas.
Con el tokenizer Tekken de Mistral, la frase "Explique-moi la photosynthèse simplement." se convierte en 9 tokens: Expl | ique | -moi | _la | _photos | ynth | èse | _simplement | . (el símbolo _ representa un espacio, unido al token que le sigue). La palabra rara "photosynthèse" se reconstruye a partir de tres fragmentos, mientras que "simplement" forma un solo token. El token es, por tanto, la unidad de cálculo del modelo, y no la palabra.
También para descubrir
Continúe su exploración del Universo con estos temas:
El token: la unidad básica de un LLM
Un trozo de texto, no una palabra
Un LLM no lee ni letras ni palabras: lee tokens. Un token es un fragmento de texto, que puede ser una palabra entera, una parte de palabra, un signo de puntuación o un número. Cada token corresponde a un número en un diccionario fijado antes del entrenamiento. Tomemos como prompt la frase "Explique-moi la photosynthèse simplement."
| Tokenizer | Diccionario (tokens) | Tokens para la frase | División de "photosynthèse" |
|---|---|---|---|
| Tekken (Mistral NeMo) | ≈ 131.000 | 9 | 3: _photos + ynth + èse |
| GPT-4o (o200k_base) | ≈ 200.000 | 9 | 3: _photos + ynth + èse |
| Grok (xAI) | no comunicado | 9 | 3: _photos + ynth + èse |
| DeepSeek V3 | ≈ 129.000 | 10 | 3: _photos + ynth + èse |
| Gemma 3 (Google) | ≈ 262.000 | 10 | 3: _photos + ynth + èse |
| GPT-4 (cl100k_base) | ≈ 100.000 | 11 | 4: _photos + ynth + è + se |
| Llama 3 y 3.1 (Meta) | ≈ 128.000 | 11 | 4: _photos + ynth + è + se |
| Qwen3 (Alibaba) | ≈ 152.000 | 11 | 4: _photos + ynth + è + se |
| Mistral 7B (SentencePiece) | 32.768 | 13 | 4: _photos + yn + th + èse |
El símbolo _ representa un espacio, unido al token que sigue. Los tamaños de diccionario están redondeados. Un diccionario grande tiende a acortar los textos, pero no es sistemático: Gemma 3 (≈ 262.000 tokens) produce 10 tokens para esta frase, frente a 9 de Tekken (≈ 131.000). La división también depende de las lenguas y del corpus utilizados para construir el diccionario.
Lo que revela la comparación
Los ocho tokenizers de la tabla leen la misma frase, pero no la dividen de la misma manera. Estas diferencias muestran lo que es realmente un token.
- "photosynthèse" no tiene entrada propia en ningún diccionario: esta palabra rara se reconstruye a partir de tres o cuatro fragmentos. Tekken, GPT-4o, DeepSeek y Gemma 3 la cortan en tres (
_photos,ynth,èse), mientras que GPT-4, Llama 3 y Qwen3 separan además la terminación enèyse. - "simplement" forma un solo token, incluido el carácter de espacio, en todos los tokenizers excepto el de Mistral 7B. Su diccionario, más pequeño, lo corta en
_simpleyment. - "Explique" se corta en dos (
Expl,ique) por todos los tokenizers, aunque se trate de un verbo común: la división sigue las estadísticas del corpus, no la gramática. - "-moi" recibe tres tratamientos diferentes: un solo token en Tekken y GPT-4o,
-myoien DeepSeek, GPT-4, Llama 3 y Qwen3, o-ymoien Gemma 3. Mistral 7B lo divide en tres tokens. El punto final, por su parte, siempre forma un token aparte. - El total varía de 9 a 13 tokens. El tamaño del diccionario no basta para explicarlo: Gemma 3, con el mayor diccionario de la tabla, produce 10 tokens frente a 9 de Tekken.
Un token no es, por tanto, una unidad lingüística estable: depende del diccionario de cada modelo. Solo algunos puntos son constantes, como el espacio unido a la palabra que sigue, la puntuación aislada o el corte de "Explique" en Expl e ique.
¿Por qué dividir así?
El diccionario se construye antes del entrenamiento mediante un método como el byte-pair encoding: se parte de los caracteres, y luego se fusionan repetidamente los pares más frecuentes del corpus. Las secuencias comunes se convierten en tokens enteros, las secuencias raras permanecen en trozos. Es un compromiso: un diccionario grande acorta los textos pero recarga el modelo, un diccionario pequeño alarga las secuencias a tratar.
El mismo texto no se divide, por tanto, de la misma manera de un modelo a otro. El tokenizer SentencePiece de Mistral 7B, cuyo diccionario cuenta con unos 32.000 tokens, produce 13 tokens para la misma frase en lugar de 9. En la práctica, la ventana de contexto y la facturación de los servicios de IA se miden en tokens, y las lenguas menos presentes en el corpus suelen necesitar más para decir lo mismo.
Del token al número
El modelo solo recibe la lista de números: 60.795, 2.508, 33.001, 1.427, 17.159, 20.602, 24.380, 37.507, 1.046. Estos números son simples direcciones en el diccionario y no tienen ningún sentido por sí mismos. Es en la etapa siguiente, el embedding, donde cada uno es sustituido por un vector de miles de números aprendidos durante el entrenamiento. El modelo nunca "ve" por tanto las letras de "photosynthèse", lo que explica sus dificultades para contar las letras de una palabra.
El embedding: del número al vector
Un número no tiene sentido
Tras la tokenización, el modelo dispone de una lista de números. Pero el número 17.159, que designa el token _photos en nuestro ejemplo, no es más que una dirección en el diccionario: no está más cerca de 17.160 que de 90.000. Para calcular, el modelo necesita una representación en la que la proximidad refleje una semejanza de uso. Es el papel del embedding.
Una tabla de vectores aprendidos
El embedding es una inmensa tabla que contiene una fila por token del diccionario. Cada fila es un vector, es decir, una lista de miles de números. Para pasar del número al vector, el modelo simplemente lee la fila correspondiente:
_photos (número 17.159) → [0,021 ; −0,134 ; 0,087 ; … ; 0,052]
Estos valores son ficticios y la lista real cuenta, por ejemplo, con 4.096 números. No están escritos por humanos: son coeficientes ajustados durante el entrenamiento, igual que los de la atención. Para un diccionario de 131.072 tokens y vectores de 4.096 números, esta tabla representa por sí sola unos 537 millones de coeficientes.
Vectores que se acercan según el uso
A lo largo del entrenamiento, los tokens empleados en contextos similares reciben vectores vecinos. El vector de _simplement se encuentra así más cerca del de un adverbio comparable que del de un nombre propio. Este espacio cuenta con miles de dimensiones: no se puede dibujar, pero se pueden medir en él distancias y ángulos.
El vector de un token es siempre el mismo, cualquiera que sea su entorno. Un fragmento como ynth no tiene sentido por sí solo: es la etapa siguiente, la atención, la que lo pone en relación con _photos y èse para reconstituir "photosynthèse".
El orden de los tokens
Como el mismo token da el mismo vector en todas partes, hay que indicar también su posición en la frase, pues "el gato se come al ratón" no significa lo mismo que "el ratón se come al gato". Según los modelos, esta información se añade a los vectores o, más a menudo hoy en día, se aplica en forma de rotación en el interior de las capas de atención.
Lo que recibe el modelo
Los 9 números de nuestro ejemplo se convierten así en 9 vectores, es decir, una tabla de 9 filas y 4.096 columnas, esto es, 36.864 números. Es esta matriz, y ya no el texto, la que entra en los bloques Transformer.
| Rango | Token | Número | Dim. 1 | Dim. 2 | Dim. 3 | Dim. 4 | … | Dim. 4.096 |
|---|---|---|---|---|---|---|---|---|
| 1 | Expl | 60.795 | 0,0130 | 0,0121 | −0,0297 | −0,0022 | … | 0,0085 |
| 2 | ique | 2.508 | 0,0064 | −0,0154 | −0,0113 | 0,0039 | … | −0,0185 |
| 3 | -moi | 33.001 | −0,0031 | −0,0255 | 0,0001 | −0,0199 | … | 0,0013 |
| 4 | _la | 1.427 | 0,0207 | 0,0212 | 0,0177 | −0,0262 | … | 0,0086 |
| 5 | _photos | 17.159 | −0,0090 | −0,0208 | 0,0028 | 0,0111 | … | 0,0343 |
| 6 | ynth | 20.602 | −0,0043 | 0,0203 | −0,0563 | −0,0060 | … | −0,0005 |
| 7 | èse | 24.380 | −0,0103 | 0,0161 | −0,0043 | 0,0160 | … | 0,0167 |
| 8 | _simplement | 37.507 | −0,0164 | −0,0030 | −0,0016 | −0,0035 | … | −0,0138 |
| 9 | . | 1.046 | −0,0134 | 0,0071 | −0,0151 | −0,0090 | … | 0,0133 |
Solo se muestran 5 columnas de 4.096, es decir, 9 × 4.096 = 36.864 números en total. Estos valores son ilustrativos: tienen el orden de magnitud de los de un embedding real (números pequeños, positivos o negativos, del orden de una centésima), sin estar extraídos de un modelo preciso. En un modelo real, no están limitados al intervalo de −1 a 1.
Referencias
- Wikipedia: Byte pair encoding (nueva ventana)
- Kudo, T. y Richardson, J.: "SentencePiece: A simple and language independent subword tokenizer and detokenizer for Neural Text Processing", EMNLP (System Demonstrations), 2018 (nueva ventana)
- Mistral AI: "Mistral NeMo", presentación del tokenizer Tekken, 18 de julio de 2024 (nueva ventana)
FAQ: el token en los LLM
¿Qué es un token?
Un token es la unidad de texto manipulada por un LLM: una palabra frecuente, un trozo de palabra, un signo de puntuación o un número. Cada token corresponde a un número en el diccionario del modelo.
¿Es un token una palabra?
No necesariamente. Las palabras muy frecuentes suelen formar un solo token, mientras que las palabras raras se dividen en fragmentos. En nuestro ejemplo, "photosynthèse" da tres tokens y "simplement" uno. El espacio que precede a una palabra generalmente se incluye en el token.
¿Cuántos tokens se necesitan para una palabra o una página?
Eso depende de la lengua, del texto y del tokenizer. En francés, a menudo se cuentan entre 1,3 y 2 tokens por palabra. Nuestra frase de ejemplo cuenta con 5 palabras para 9 tokens con Tekken, y 13 con el tokenizer de Mistral 7B.
¿Quién decide la división en tokens?
El tokenizer, un componente distinto de la red de neuronas. Su diccionario se construye antes del entrenamiento, por ejemplo con el método del byte-pair encoding, que fusiona repetidamente los pares de caracteres más frecuentes del corpus. Después permanece fijado.
¿Por qué el mismo texto no tiene el mismo número de tokens de un modelo a otro?
Porque cada modelo tiene su propio diccionario, de tamaño y contenido diferentes. Un diccionario más grande acorta los textos, uno más pequeño los alarga. Los números de los tokens no son, por tanto, comparables de un modelo a otro.
¿Por qué los servicios de IA cuentan en tokens?
Porque el token es la unidad de cálculo del modelo. La ventana de contexto (la cantidad de texto que el modelo puede leer de una vez) y la facturación de muchos servicios se miden en tokens, y el tiempo de cálculo aumenta con su número.
¿Tiene sentido un token?
No por sí mismo. Su número no es más que una dirección en el diccionario. El sentido aparece en la etapa siguiente, el embedding, que sustituye cada número por un vector de miles de números aprendidos durante el entrenamiento, y luego en las capas de atención que relacionan los tokens entre sí.
¿Por qué un LLM tiene dificultades para contar las letras de una palabra?
Porque no "ve" las letras: manipula tokens. No tiene acceso a las letras de "photosynthèse", solo a los tres fragmentos _photos, ynth y èse.
 El recorrido del prompt a la respuesta: entre bastidores de un LLM
 El token: la unidad fundamental de los grandes modelos de lenguaje
 Los diferentes tipos de aprendizaje de las IA
 IA Agentica: Cuando las máquinas se vuelven autónomas
 Lo que la IA no puede hacer
 Inteligencia artificial y astronomía: Comprender el papel de los asistentes IA
 Herramientas de IA: ¿cómo elegir?

 IA Generativa vs AGI: ¿Dónde termina la imitación y dónde comienza la conciencia?
 Redes artificiales vs. redes biológicas: Dos sistemas, una arquitectura común
 Cerebro Humano e Inteligencias Artificiales: Similitudes y Diferencias
 AlphaGo contra AlphaGo Zero: Una Revolución en la Inteligencia Artificial
 El Próximo Paso para las Máquinas Inteligentes
 El primer paso hacia el surgimiento de la vida
 De la Neurona Biológica a la Neurona Formal: Simplificación del Cerebro
 Inteligencia artificial: la explosión del gigantismo
 ¡Cuando la inteligencia artificial se vuelve loca!
 Cómo las máquinas se vuelven inteligentes
 Inteligencia artificial: ¿amenaza real u oportunidad para la humanidad?
 ¿Cómo las máquinas entienden, interpretan y generan el lenguaje de forma similar a los humanos?
 ¿Cómo funciona una red neuronal artificial?