


Das Token: die grundlegende Einheit großer Sprachmodelle
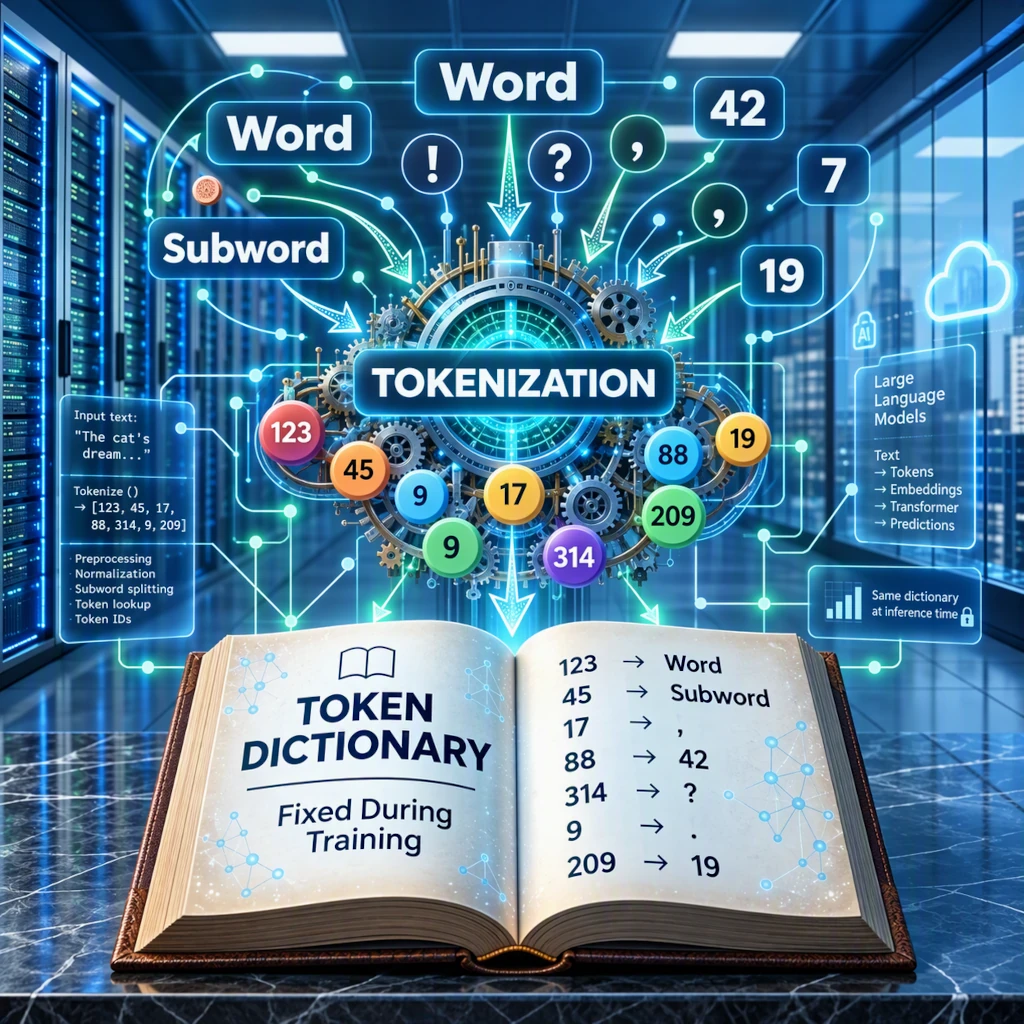
Veranschaulichung des Tokenisierungsprozesses in der Cloud: Umwandlung von Wörtern, Wortteilen und Satzzeichen in numerische Tokens, die in einem Trainingswörterbuch referenziert sind.
Bildquelle: astronoo.com (neues Fenster): KI-generiertes Bild, gemeinfrei.
Wissenschaftliche Zusammenfassung
Dieser Artikel beschreibt das Token, die elementare Texteinheit, die von einem großen Sprachmodell (LLM) verarbeitet wird. Vor jeder Berechnung wird der Text von einem Tokenizer in Fragmente zerlegt (ganze Wörter, Wortteile, Satzzeichen, Zahlen), die jeweils einer Nummer in einem vor dem Training festgelegten Wörterbuch zugeordnet sind. Dieses Wörterbuch wird aus den in einem sehr großen Korpus beobachteten Häufigkeiten aufgebaut, beispielsweise durch Byte-Pair-Encoding. Das Beispiel „Explique-moi la photosynthèse simplement." wird vom Tekken-Tokenizer von Mistral in 9 Tokens und vom Tokenizer von Mistral 7B in 13 Tokens zerlegt: die Zerlegung hängt vom Modell ab. Der Artikel untersucht, was diese Segmentierung verrät, ihre Rolle für die Kontextlänge, die Rechenkosten und die Grenzen des Modells, und dann den Übergang von der Nummer zum Vektor durch das Embedding.
Was ist ein Token, und warum liest eine KI keine Wörter?
Ein Textfragment, das in eine Nummer umgewandelt wird
Ein Token ist ein Textfragment: ein ganzes Wort, ein Wortteil, ein Satzzeichen oder eine Zahl. Ein LLM erhält niemals Buchstaben oder Wörter, sondern eine Folge von Nummern, von denen jede ein Token in einem Wörterbuch mit mehreren zehntausend Einträgen bezeichnet.
Mit dem Tekken-Tokenizer von Mistral wird der Satz „Explique-moi la photosynthèse simplement." zu 9 Tokens: Expl | ique | -moi | _la | _photos | ynth | èse | _simplement | . (das Symbol _ steht für ein Leerzeichen, das an das folgende Token angehängt ist). Das seltene Wort „photosynthèse" wird aus drei Fragmenten rekonstruiert, während „simplement" ein einziges Token bildet. Das Token ist also die Recheneinheit des Modells und nicht das Wort.
Auch interessant
Setzen Sie Ihre Erkundung des Universums mit diesen Themen fort:
Das Token: die Grundeinheit eines LLM
Ein Stück Text, kein Wort
Ein LLM liest weder Buchstaben noch Wörter: es liest Tokens. Ein Token ist ein Textfragment, das ein ganzes Wort, ein Wortteil, ein Satzzeichen oder eine Zahl sein kann. Jedes Token entspricht einer Nummer in einem vor dem Training festgelegten Wörterbuch. Nehmen wir als Prompt den Satz „Explique-moi la photosynthèse simplement."
| Tokenizer | Wörterbuch (Tokens) | Tokens für den Satz | Zerlegung von „photosynthèse" |
|---|---|---|---|
| Tekken (Mistral NeMo) | ≈ 131.000 | 9 | 3: _photos + ynth + èse |
| GPT-4o (o200k_base) | ≈ 200.000 | 9 | 3: _photos + ynth + èse |
| Grok (xAI) | nicht bekannt gegeben | 9 | 3: _photos + ynth + èse |
| DeepSeek V3 | ≈ 129.000 | 10 | 3: _photos + ynth + èse |
| Gemma 3 (Google) | ≈ 262.000 | 10 | 3: _photos + ynth + èse |
| GPT-4 (cl100k_base) | ≈ 100.000 | 11 | 4: _photos + ynth + è + se |
| Llama 3 und 3.1 (Meta) | ≈ 128.000 | 11 | 4: _photos + ynth + è + se |
| Qwen3 (Alibaba) | ≈ 152.000 | 11 | 4: _photos + ynth + è + se |
| Mistral 7B (SentencePiece) | 32.768 | 13 | 4: _photos + yn + th + èse |
Das Symbol _ steht für ein Leerzeichen, das an das folgende Token angehängt ist. Die Wörterbuchgrößen sind gerundet. Ein großes Wörterbuch neigt dazu, Texte zu verkürzen, aber das ist nicht systematisch: Gemma 3 (≈ 262.000 Tokens) erzeugt 10 Tokens für diesen Satz, gegenüber 9 bei Tekken (≈ 131.000). Die Zerlegung hängt auch von den Sprachen und dem Korpus ab, die zum Aufbau des Wörterbuchs verwendet wurden.
Was der Vergleich verrät
Die acht Tokenizer der Tabelle lesen denselben Satz, zerlegen ihn aber nicht auf dieselbe Weise. Diese Unterschiede zeigen, was ein Token wirklich ist.
- „photosynthèse" hat in keinem Wörterbuch einen eigenen Eintrag: dieses seltene Wort wird aus drei oder vier Fragmenten rekonstruiert. Tekken, GPT-4o, DeepSeek und Gemma 3 zerlegen es in drei (
_photos,ynth,èse), während GPT-4, Llama 3 und Qwen3 auch die Endung inèundsetrennen. - „simplement" bildet in allen Tokenizern außer dem von Mistral 7B ein einziges Token, einschließlich des Leerzeichens. Dessen kleineres Wörterbuch zerlegt es in
_simpleundment. - „Explique" wird von allen Tokenizern in zwei Teile zerlegt (
Expl,ique), obwohl es sich um ein häufiges Verb handelt: die Zerlegung folgt den Statistiken des Korpus, nicht der Grammatik. - „-moi" erfährt drei verschiedene Behandlungen: ein einziges Token bei Tekken und GPT-4o,
-mundoibei DeepSeek, GPT-4, Llama 3 und Qwen3, oder-undmoibei Gemma 3. Mistral 7B zerlegt es in drei Tokens. Der Schlusspunkt bildet dagegen immer ein eigenes Token. - Die Gesamtzahl schwankt zwischen 9 und 13 Tokens. Die Größe des Wörterbuchs allein erklärt das nicht: Gemma 3, mit dem größten Wörterbuch der Tabelle, erzeugt 10 Tokens gegenüber 9 bei Tekken.
Ein Token ist also keine stabile sprachliche Einheit: es hängt vom Wörterbuch des jeweiligen Modells ab. Nur wenige Punkte sind konstant, wie das an das folgende Wort angehängte Leerzeichen, isolierte Satzzeichen oder die Zerlegung von „Explique" in Expl und ique.
Warum diese Zerlegung?
Das Wörterbuch wird vor dem Training durch ein Verfahren wie das Byte-Pair-Encoding aufgebaut: man geht von den Zeichen aus und verschmilzt dann wiederholt die häufigsten Paare des Korpus. Häufige Sequenzen werden zu ganzen Tokens, seltene Sequenzen bleiben in Stücken. Es ist ein Kompromiss: ein großes Wörterbuch verkürzt die Texte, belastet aber das Modell, ein kleines Wörterbuch verlängert die zu verarbeitenden Sequenzen.
Derselbe Text wird also von einem Modell zum anderen nicht gleich zerlegt. Der SentencePiece-Tokenizer von Mistral 7B, dessen Wörterbuch etwa 32.000 Tokens umfasst, erzeugt 13 Tokens für denselben Satz statt 9. In der Praxis werden das Kontextfenster und die Abrechnung von KI-Diensten in Tokens gemessen, und Sprachen, die im Korpus weniger vertreten sind, benötigen oft mehr davon, um dasselbe zu sagen.
Vom Token zur Nummer
Das Modell erhält nur die Liste der Nummern: 60.795, 2.508, 33.001, 1.427, 17.159, 20.602, 24.380, 37.507, 1.046. Diese Nummern sind einfache Adressen im Wörterbuch und haben für sich genommen keine Bedeutung. Erst im nächsten Schritt, dem Embedding, wird jede durch einen Vektor aus Tausenden von während des Trainings erlernten Zahlen ersetzt. Das Modell „sieht" also niemals die Buchstaben von „photosynthèse", was seine Schwierigkeiten erklärt, die Buchstaben eines Wortes zu zählen.
Das Embedding: von der Nummer zum Vektor
Eine Nummer hat keine Bedeutung
Nach der Tokenisierung verfügt das Modell über eine Liste von Nummern. Die Nummer 17.159, die in unserem Beispiel das Token _photos bezeichnet, ist jedoch nur eine Adresse im Wörterbuch: sie ist nicht näher an 17.160 als an 90.000. Um zu rechnen, braucht das Modell eine Darstellung, in der die Nähe eine Ähnlichkeit der Verwendung widerspiegelt. Das ist die Rolle des Embeddings.
Eine Tabelle erlernter Vektoren
Das Embedding ist eine riesige Tabelle, die eine Zeile pro Token des Wörterbuchs enthält. Jede Zeile ist ein Vektor, d. h. eine Liste von Tausenden von Zahlen. Um von der Nummer zum Vektor zu gelangen, liest das Modell einfach die entsprechende Zeile:
_photos (Nummer 17.159) → [0,021 ; −0,134 ; 0,087 ; … ; 0,052]
Diese Werte sind fiktiv und die reale Liste umfasst beispielsweise 4.096 Zahlen. Sie sind nicht von Menschen geschrieben: es sind Koeffizienten, die während des Trainings angepasst werden, genau wie die der Attention. Für ein Wörterbuch mit 131.072 Tokens und Vektoren mit 4.096 Zahlen repräsentiert diese Tabelle allein etwa 537 Millionen Koeffizienten.
Vektoren, die sich je nach Verwendung annähern
Im Laufe des Trainings erhalten Tokens, die in ähnlichen Kontexten verwendet werden, benachbarte Vektoren. Der Vektor von _simplement kommt so einem vergleichbaren Adverb näher als einem Eigennamen. Dieser Raum hat Tausende von Dimensionen: man kann ihn nicht zeichnen, aber man kann darin Abstände und Winkel messen.
Der Vektor eines Tokens ist immer derselbe, unabhängig von seiner Umgebung. Ein Fragment wie ynth hat für sich genommen keine Bedeutung: es ist der nächste Schritt, die Attention, die es mit _photos und èse in Beziehung setzt, um „photosynthèse" zu rekonstruieren.
Die Reihenfolge der Tokens
Da dasselbe Token überall denselben Vektor ergibt, muss auch seine Position im Satz angegeben werden, denn „die Katze frisst die Maus" bedeutet nicht dasselbe wie „die Maus frisst die Katze". Je nach Modell werden diese Informationen zu den Vektoren hinzugefügt oder, heute meist, in Form einer Rotation innerhalb der Attention-Schichten angewendet.
Was das Modell erhält
Die 9 Nummern unseres Beispiels werden so zu 9 Vektoren, d. h. einer Tabelle mit 9 Zeilen und 4.096 Spalten, also 36.864 Zahlen. Diese Matrix, und nicht mehr der Text, gelangt in die Transformer-Blöcke.
| Rang | Token | Nummer | Dim. 1 | Dim. 2 | Dim. 3 | Dim. 4 | … | Dim. 4.096 |
|---|---|---|---|---|---|---|---|---|
| 1 | Expl | 60.795 | 0,0130 | 0,0121 | −0,0297 | −0,0022 | … | 0,0085 |
| 2 | ique | 2.508 | 0,0064 | −0,0154 | −0,0113 | 0,0039 | … | −0,0185 |
| 3 | -moi | 33.001 | −0,0031 | −0,0255 | 0,0001 | −0,0199 | … | 0,0013 |
| 4 | _la | 1.427 | 0,0207 | 0,0212 | 0,0177 | −0,0262 | … | 0,0086 |
| 5 | _photos | 17.159 | −0,0090 | −0,0208 | 0,0028 | 0,0111 | … | 0,0343 |
| 6 | ynth | 20.602 | −0,0043 | 0,0203 | −0,0563 | −0,0060 | … | −0,0005 |
| 7 | èse | 24.380 | −0,0103 | 0,0161 | −0,0043 | 0,0160 | … | 0,0167 |
| 8 | _simplement | 37.507 | −0,0164 | −0,0030 | −0,0016 | −0,0035 | … | −0,0138 |
| 9 | . | 1.046 | −0,0134 | 0,0071 | −0,0151 | −0,0090 | … | 0,0133 |
Es werden nur 5 Spalten von 4.096 angezeigt, d. h. 9 × 4.096 = 36.864 Zahlen insgesamt. Diese Werte sind illustrativ: sie haben die Größenordnung derer eines realen Embeddings (kleine Zahlen, positiv oder negativ, in der Größenordnung eines Hundertstels), ohne aus einem bestimmten Modell extrahiert zu sein. In einem realen Modell sind sie nicht auf das Intervall von −1 bis 1 beschränkt.
Referenzen
- Wikipedia: Byte pair encoding (neues Fenster)
- Kudo, T. und Richardson, J.: „SentencePiece: A simple and language independent subword tokenizer and detokenizer for Neural Text Processing", EMNLP (System Demonstrations), 2018 (neues Fenster)
- Mistral AI: „Mistral NeMo", Vorstellung des Tekken-Tokenizers, 18. Juli 2024 (neues Fenster)
FAQ: Das Token in LLM
Was ist ein Token?
Ein Token ist die Texteinheit, die von einem LLM verarbeitet wird: ein häufiges Wort, ein Wortteil, ein Satzzeichen oder eine Zahl. Jedes Token entspricht einer Nummer im Wörterbuch des Modells.
Ist ein Token ein Wort?
Nicht unbedingt. Sehr häufige Wörter bilden oft ein einziges Token, während seltene Wörter in Fragmente zerlegt werden. In unserem Beispiel ergibt „photosynthèse" drei Tokens und „simplement" eines. Das Leerzeichen vor einem Wort ist in der Regel im Token enthalten.
Wie viele Tokens braucht man für ein Wort oder eine Seite?
Das hängt von der Sprache, dem Text und dem Tokenizer ab. Im Französischen zählt man oft zwischen 1,3 und 2 Tokens pro Wort. Unser Beispielsatz hat 5 Wörter für 9 Tokens mit Tekken und 13 mit dem Tokenizer von Mistral 7B.
Wer entscheidet die Zerlegung in Tokens?
Der Tokenizer, eine vom neuronalen Netz verschiedene Komponente. Sein Wörterbuch wird vor dem Training aufgebaut, beispielsweise mit der Methode des Byte-Pair-Encoding, die wiederholt die häufigsten Zeichenpaare des Korpus verschmilzt. Danach bleibt es eingefroren.
Warum hat derselbe Text nicht dieselbe Anzahl von Tokens von einem Modell zum anderen?
Weil jedes Modell sein eigenes Wörterbuch mit unterschiedlicher Größe und unterschiedlichem Inhalt hat. Ein größeres Wörterbuch verkürzt die Texte, ein kleineres verlängert sie. Die Token-Nummern sind daher von einem Modell zum anderen nicht vergleichbar.
Warum rechnen KI-Dienste in Tokens ab?
Weil das Token die Recheneinheit des Modells ist. Das Kontextfenster (die Textmenge, die das Modell auf einmal lesen kann) und die Abrechnung vieler Dienste werden in Tokens gemessen, und die Rechenzeit steigt mit ihrer Anzahl.
Hat ein Token eine Bedeutung?
Nicht für sich genommen. Seine Nummer ist nur eine Adresse im Wörterbuch. Die Bedeutung entsteht im nächsten Schritt, dem Embedding, das jede Nummer durch einen Vektor aus Tausenden von während des Trainings erlernten Zahlen ersetzt, und dann in den Attention-Schichten, die die Tokens miteinander verbinden.
Warum hat ein LLM Schwierigkeiten, die Buchstaben eines Wortes zu zählen?
Weil es die Buchstaben nicht „sieht": es manipuliert Tokens. Es hat keinen Zugang zu den Buchstaben von „photosynthèse", nur zu den drei Fragmenten _photos, ynth und èse.
 Der Weg vom Prompt zur Antwort: hinter den Kulissen eines LLM
 Das Token: die grundlegende Einheit großer Sprachmodelle
 Die verschiedenen Lernarten der KI
 Agentische KI: Wenn Maschinen autonom werden
 Was KI nicht kann
 Künstliche Intelligenz und Astronomie: Die Rolle der KI-Assistenten verstehen
 KI-Tools: Wie wählt man aus?

 Generative KI vs AGI: Wo endet Nachahmung, wo beginnt Bewusstsein?
 Künstliche Netzwerke vs. biologische Netzwerke: Zwei Systeme, eine gemeinsame Architektur
 Menschliches Gehirn und künstliche Intelligenzen: Ähnlichkeiten und Unterschiede
 AlphaGo gegen AlphaGo Zero: Eine Revolution der künstlichen Intelligenz
 Der nächste Schritt intelligenter Maschinen
 Der erste Schritt zur Entstehung des Lebens
 Vom biologischen Neuron zum formalen Neuron: Vereinfachung des Gehirns
 Künstliche Intelligenz: Die Explosion des Gigantismus
 Wenn künstliche Intelligenz verrückt wird!
 Wie Maschinen intelligent werden
 Künstliche Intelligenz: reale Bedrohung oder Chance für die Menschheit?
 Wie Maschinen Sprache ähnlich wie Menschen verstehen, interpretieren und erzeugen
 Wie funktioniert ein künstliches neuronales Netzwerk?