


トークン:大規模言語モデルの基本単位
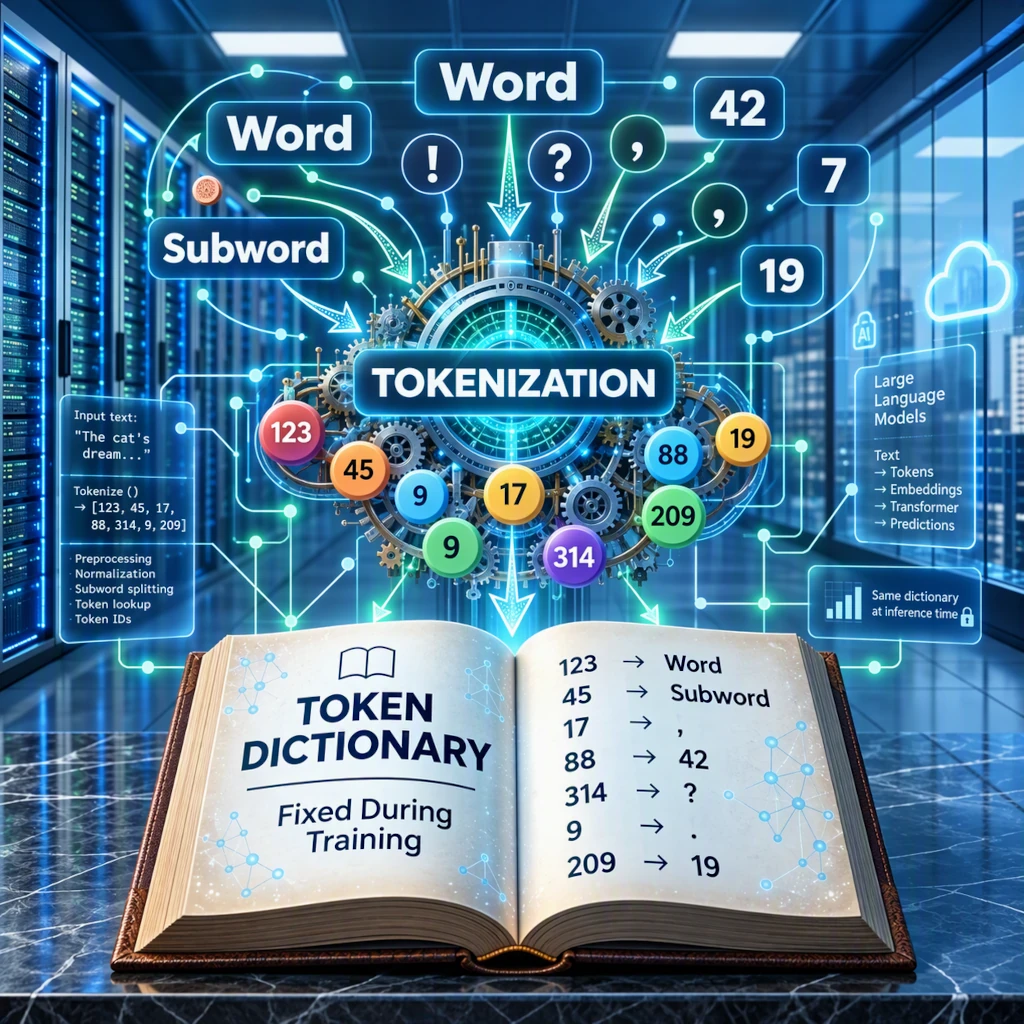
クラウドにおけるトークン化プロセスの図:単語、単語の一部、句読点が、トレーニング辞書に登録された数値トークンに変換される。
画像出典:astronoo.com(新しいウィンドウ):AI生成画像、パブリックドメイン。
科学的要約
本記事では、大規模言語モデル(LLM)が操作するテキストの基本単位であるトークンについて説明します。計算の前に、テキストはトークナイザーによって断片(単語全体、単語の一部、句読点、数字)に分割され、それぞれがトレーニング前に固定された辞書内の番号に対応付けられます。この辞書は、非常に大きなコーパスで観察された頻度から、たとえばバイトペアエンコーディングによって構築されます。「Explique-moi la photosynthèse simplement.」という例は、MistralのTekkenトークナイザーでは9トークン、Mistral 7Bのトークナイザーでは13トークンに分割されます。分割はモデルに依存します。本記事では、この分割が何を明らかにするか、コンテキスト長、計算コスト、モデルの限界におけるその役割、そして埋め込みによる番号からベクトルへの移行を検討します。
トークンとは何か、なぜAIは単語を読まないのか?
番号に変換されたテキストの断片
トークンとはテキストの断片です:単語全体、単語の一部、句読点、または数字です。LLMは決して文字や単語を受け取るのではなく、数万のエントリを持つ辞書内のトークンを指定する一連の番号を受け取ります。
MistralのTekkenトークナイザーでは、「Explique-moi la photosynthèse simplement.」という文は9トークンになります:Expl | ique | -moi | _la | _photos | ynth | èse | _simplement | .(記号 _ はスペースを表し、それに続くトークンに付加されます)。珍しい単語「photosynthèse」は3つの断片から再構成されますが、「simplement」は1つのトークンを形成します。したがって、トークンはモデルの計算単位であり、単語ではありません。
こちらもおすすめ
宇宙の探検をさらに深めるためのテーマをご紹介します:
トークン:LLMの基本単位
単語ではなく、テキストの断片
LLMは文字も単語も読みません:トークンを読みます。 トークンとはテキストの断片であり、単語全体、単語の一部、句読点、または数字である場合があります。 各トークンは、トレーニング前に固定された辞書内の番号に対応します。 プロンプトとして「Explique-moi la photosynthèse simplement.」という文を考えてみましょう。
| トークナイザー | 辞書(トークン) | 文のトークン数 | 「photosynthèse」の分割 |
|---|---|---|---|
| Tekken(Mistral NeMo) | ≈ 131,000 | 9 | 3:_photos + ynth + èse |
| GPT-4o(o200k_base) | ≈ 200,000 | 9 | 3:_photos + ynth + èse |
| Grok(xAI) | 非公開 | 9 | 3:_photos + ynth + èse |
| DeepSeek V3 | ≈ 129,000 | 10 | 3:_photos + ynth + èse |
| Gemma 3(Google) | ≈ 262,000 | 10 | 3:_photos + ynth + èse |
| GPT-4(cl100k_base) | ≈ 100,000 | 11 | 4:_photos + ynth + è + se |
| Llama 3および3.1(Meta) | ≈ 128,000 | 11 | 4:_photos + ynth + è + se |
| Qwen3(Alibaba) | ≈ 152,000 | 11 | 4:_photos + ynth + è + se |
| Mistral 7B(SentencePiece) | 32,768 | 13 | 4:_photos + yn + th + èse |
記号 _ はスペースを表し、後に続くトークンに付加されます。辞書のサイズは丸められています。大きな辞書はテキストを短くする傾向がありますが、常にそうとは限りません:Gemma 3(≈ 262,000トークン)はこの文に対して10トークンを生成し、Tekken(≈ 131,000)の9トークンに対して多くなっています。分割は、辞書の構築に使用された言語とコーパスにも依存します。
比較が明らかにするもの
表の8つのトークナイザーは同じ文を読みますが、同じようには分割しません。これらの違いは、トークンが実際に何であるかを示しています。
- 「photosynthèse」はどの辞書にも独自のエントリを持ちません:この珍しい単語は3つまたは4つの断片から再構成されます。Tekken、GPT-4o、DeepSeek、Gemma 3は3つに分割し(
_photos、ynth、èse)、GPT-4、Llama 3、Qwen3は語尾をさらにèとseに分けます。 - 「simplement」は、Mistral 7Bのものを除くすべてのトークナイザーで、スペース文字を含めて1つのトークンを形成します。より小さな辞書を持つMistral 7Bは、それを
_simpleとmentに分割します。 - 「Explique」は、一般的な動詞であるにもかかわらず、すべてのトークナイザーによって2つに分割されます(
Expl、ique):分割は文法ではなく、コーパスの統計に従います。 - 「-moi」は3つの異なる処理を受けます:TekkenとGPT-4oでは1つのトークン、DeepSeek、GPT-4、Llama 3、Qwen3では
-mとoi、Gemma 3では-とmoi。Mistral 7Bはそれを3つのトークンに分割します。最後のピリオドは常に別のトークンを形成します。 - 合計は9から13トークンの間で変動します。辞書のサイズだけではこれを説明できません:表の中で最大の辞書を持つGemma 3は、Tekkenの9に対して10トークンを生成します。
したがって、トークンは安定した言語単位ではありません:各モデルの辞書に依存します。後に続く単語に付加されるスペース、孤立した句読点、「Explique」のExplとiqueへの分割など、いくつかの点だけが一定です。
なぜこのように分割するのか?
辞書はトレーニング前にバイトペアエンコーディングなどの方法で構築されます:文字から始めて、コーパス内で最も頻繁なペアを繰り返し融合します。一般的なシーケンスはトークン全体になり、珍しいシーケンスは断片のまま残ります。これはトレードオフです:大きな辞書はテキストを短くしますがモデルを重くし、小さな辞書は処理するシーケンスを長くします。
したがって、同じテキストでもモデルによって分割が異なります。辞書が約32,000トークンであるMistral 7BのSentencePieceトークナイザーは、同じ文に対して9ではなく13トークンを生成します。実際には、コンテキストウィンドウとAIサービスの課金はトークンで測定され、コーパスにあまり含まれていない言語は同じことを言うのにより多くのトークンを必要とすることがよくあります。
トークンから番号へ
モデルが受け取るのは番号のリストだけです:60,795、2,508、33,001、1,427、17,159、20,602、24,380、37,507、1,046。これらの番号は辞書内の単なるアドレスであり、それ自体には何の意味もありません。次のステップである埋め込みで、それぞれがトレーニング中に学習された数千の数のベクトルに置き換えられます。したがって、モデルは「photosynthèse」の文字を決して「見る」ことはなく、これが単語の文字を数えるのが苦手な理由を説明しています。
埋め込み:番号からベクトルへ
番号には意味がない
トークン化の後、モデルは番号のリストを持っています。しかし、私たちの例でトークン_photosを指定する番号17,159は、辞書内の単なるアドレスです:17,160に近いわけでも、90,000に近いわけでもありません。計算するために、モデルは近さが使用の類似性を反映する表現を必要とします。これが埋め込みの役割です。
学習されたベクトルのテーブル
埋め込みは、辞書のトークンごとに1行を含む巨大なテーブルです。各行はベクトル、つまり数千の数のリストです。番号からベクトルへ移行するには、モデルは対応する行を読むだけです:
_photos(番号17,159)→ [0.021 ; −0.134 ; 0.087 ; … ; 0.052]
これらの値は架空のものであり、実際のリストはたとえば4,096の数を含みます。それらは人間によって書かれたものではありません:アテンションの係数と同様に、トレーニング中に調整された係数です。131,072トークンの辞書と4,096の数のベクトルの場合、このテーブルだけで約5億3,700万の係数を表します。
使用に応じて近づくベクトル
トレーニングの過程で、類似したコンテキストで使用されるトークンは隣接するベクトルを受け取ります。したがって、_simplementのベクトルは、固有名詞よりも比較可能な副詞のベクトルに近くなります。この空間は数千の次元を持ちます:描くことはできませんが、その中で距離や角度を測定することはできます。
トークンのベクトルは、その周囲が何であれ常に同じです。ynthのような断片はそれ自体では意味を持ちません:次のステップであるアテンションが、それを_photosやèseと関連付けて「photosynthèse」を再構成します。
トークンの順序
同じトークンがどこでも同じベクトルを与えるため、文中での位置も示す必要があります。なぜなら「猫がネズミを食べる」は「ネズミが猫を食べる」と同じ意味ではないからです。モデルによって、この情報はベクトルに追加されるか、今日では最も一般的に、アテンション層の内部で回転の形で適用されます。
モデルが受け取るもの
私たちの例の9つの番号は、このように9つのベクトル、つまり9行4,096列のテーブル、すなわち36,864の数になります。テキストではなく、この行列がTransformerブロックに入ります。
| 順位 | トークン | 番号 | 次元1 | 次元2 | 次元3 | 次元4 | … | 次元4,096 |
|---|---|---|---|---|---|---|---|---|
| 1 | Expl | 60,795 | 0.0130 | 0.0121 | −0.0297 | −0.0022 | … | 0.0085 |
| 2 | ique | 2,508 | 0.0064 | −0.0154 | −0.0113 | 0.0039 | … | −0.0185 |
| 3 | -moi | 33,001 | −0.0031 | −0.0255 | 0.0001 | −0.0199 | … | 0.0013 |
| 4 | _la | 1,427 | 0.0207 | 0.0212 | 0.0177 | −0.0262 | … | 0.0086 |
| 5 | _photos | 17,159 | −0.0090 | −0.0208 | 0.0028 | 0.0111 | … | 0.0343 |
| 6 | ynth | 20,602 | −0.0043 | 0.0203 | −0.0563 | −0.0060 | … | −0.0005 |
| 7 | èse | 24,380 | −0.0103 | 0.0161 | −0.0043 | 0.0160 | … | 0.0167 |
| 8 | _simplement | 37,507 | −0.0164 | −0.0030 | −0.0016 | −0.0035 | … | −0.0138 |
| 9 | . | 1,046 | −0.0134 | 0.0071 | −0.0151 | −0.0090 | … | 0.0133 |
4,096列のうち5列のみが表示されています。つまり、合計で9 × 4,096 = 36,864の数です。これらの値は例示的です:実際の埋め込みの値(100分の1のオーダーの小さな正または負の数)の桁数を持ちますが、特定のモデルから抽出されたものではありません。実際のモデルでは、−1から1の範囲に限定されません。
参考文献
FAQ:LLMにおけるトークン
トークンとは何ですか?
トークンとは、LLMが操作するテキストの単位です:頻繁な単語、単語の一部、句読点、または数字です。各トークンはモデルの辞書内の番号に対応します。
トークンは単語ですか?
必ずしもそうではありません。非常に頻繁な単語はしばしば1つのトークンを形成しますが、珍しい単語は断片に分割されます。私たちの例では、「photosynthèse」は3つのトークンを与え、「simplement」は1つを与えます。単語の前のスペースは通常トークンに含まれます。
単語やページにはいくつのトークンが必要ですか?
それは言語、テキスト、トークナイザーに依存します。フランス語では、しばしば単語あたり1.3から2トークンが数えられます。私たちの例文は、Tekkenで5語に対して9トークン、Mistral 7Bのトークナイザーで13トークンです。
トークンへの分割は誰が決めるのですか?
トークナイザーであり、ニューラルネットワークとは別のコンポーネントです。その辞書はトレーニング前に、たとえばバイトペアエンコーディング法で構築され、コーパス内で最も頻繁な文字ペアを繰り返し融合します。その後、凍結されたままになります。
なぜ同じテキストでもモデルによってトークン数が異なるのですか?
各モデルが独自の辞書を持ち、サイズと内容が異なるからです。大きな辞書はテキストを短くし、小さな辞書は長くします。したがって、トークン番号はモデル間で比較できません。
なぜAIサービスはトークンで数えるのですか?
トークンがモデルの計算単位だからです。コンテキストウィンドウ(モデルが一度に読むことができるテキストの量)と多くのサービスの課金はトークンで測定され、計算時間はその数とともに増加します。
トークンには意味がありますか?
それ自体では意味を持ちません。その番号は辞書内の単なるアドレスです。意味は次のステップである埋め込みで現れ、各番号をトレーニング中に学習された数千の数のベクトルに置き換え、次にトークン同士を結びつけるアテンション層で現れます。
なぜLLMは単語の文字を数えるのが苦手なのですか?
文字を「見る」ことができないからです:トークンを操作します。「photosynthèse」の文字にはアクセスできず、3つの断片_photos、ynth、èseだけにアクセスできます。
 プロンプトから応答までの道のり:LLMの舞台裏
 トークン:大規模言語モデルの基本単位
 AIのさまざまな学習タイプ
 エージェンティックAI:マシンが自律性を獲得するとき
 AIができないこと
 人工知能と天文学:AIアシスタントの役割を理解する
 AIツールの選び方

 生成AI vs AGI:模倣の終わり、意識の始まりはどこか?
 人工ネットワーク vs 生物学的ネットワーク:2つのシステム、共通のアーキテクチャ
 人間の脳と人工知能:類似点と相違点
 AlphaGo vs AlphaGo Zero:人工知能の革命
 知的機械の次のステップ
 生物学的ニューロンから形式ニューロンへ:脳の単純化
 人工知能:巨大化の爆発
 人工知能が狂ったとき!
 機械はいかにして知能を得るのか
 人工知能:人類にとっての真の脅威か、それとも機会か?
 機械は人間と同様に言語を理解し、解釈し、生成する方法
 人工ニューラルネットワークの仕組み