


Le token : l’unité fondamentale des grands modèles de langage
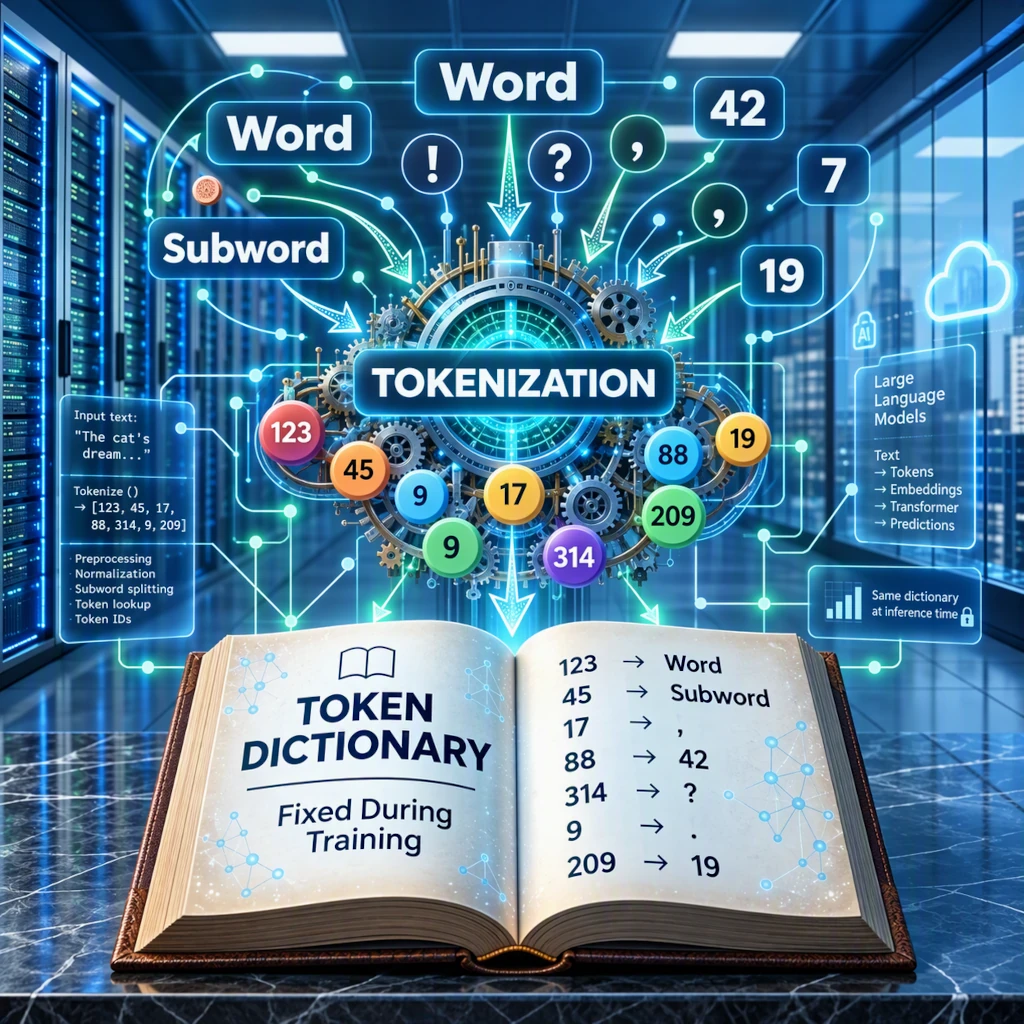
Illustration du processus de tokenisation dans le cloud : transformation des mots, parties de mots et ponctuations en jetons numériques (tokens) référencés dans un dictionnaire d'entraînement.
Source image : astronoo.com (nouvelle fenêtre) : image générée par IA, domaine public.
Résumé scientifique
Cet article décrit le token, l'unité élémentaire de texte manipulée par un grand modèle de langage (LLM). Avant tout calcul, le texte est découpé par un tokenizer en fragments (mots entiers, morceaux de mots, ponctuation, nombres), chacun associé à un numéro dans un dictionnaire fixé avant l'entraînement. Ce dictionnaire est construit à partir des fréquences observées dans un très grand corpus, par exemple par byte-pair encoding. L'exemple « Explique-moi la photosynthèse simplement. » est découpé en 9 tokens par le tokenizer Tekken de Mistral et en 13 par celui de Mistral 7B : la découpe dépend du modèle. L'article examine ce que révèle cette segmentation, son rôle dans la longueur du contexte, le coût de calcul et les limites du modèle, puis le passage du numéro au vecteur par le plongement.
Qu'est-ce qu'un token, et pourquoi une IA ne lit-elle pas des mots ?
Un fragment de texte transformé en numéro
Un token est un fragment de texte : un mot entier, une partie de mot, un signe de ponctuation ou un nombre. Un LLM ne reçoit jamais de lettres ni de mots, mais une suite de numéros, chacun désignant un token dans un dictionnaire de plusieurs dizaines de milliers d'entrées.
Avec le tokenizer Tekken de Mistral, la phrase « Explique-moi la photosynthèse simplement. » devient 9 tokens : Expl | ique | -moi | _la | _photos | ynth | èse | _simplement | . (le symbole _ représente une espace, rattachée au token qui la suit). Le mot rare « photosynthèse » est reconstitué à partir de trois fragments, alors que « simplement » forme un seul token. Le token est donc l'unité de calcul du modèle, et non le mot.
À découvrir aussi
Poursuivez votre exploration de l'Univers avec ces sujets :
Le token : l'unité de base d'un LLM
Un morceau de texte, pas un mot
Un LLM ne lit ni des lettres ni des mots : il lit des tokens. Un token est un fragment de texte, qui peut être un mot entier, une partie de mot, un signe de ponctuation ou un nombre. Chaque token correspond à un numéro dans un dictionnaire fixé avant l'entraînement. Prenons comme prompt la phrase « Explique-moi la photosynthèse simplement. »
| Tokenizer | Dictionnaire (tokens) | Tokens pour la phrase | Découpe de « photosynthèse » |
|---|---|---|---|
| Tekken (Mistral NeMo) | ≈ 131 000 | 9 | 3 : _photos + ynth + èse |
| GPT-4o (o200k_base) | ≈ 200 000 | 9 | 3 : _photos + ynth + èse |
| Grok (xAI) | non communiqué | 9 | 3 : _photos + ynth + èse |
| DeepSeek V3 | ≈ 129 000 | 10 | 3 : _photos + ynth + èse |
| Gemma 3 (Google) | ≈ 262 000 | 10 | 3 : _photos + ynth + èse |
| GPT-4 (cl100k_base) | ≈ 100 000 | 11 | 4 : _photos + ynth + è + se |
| Llama 3 et 3.1 (Meta) | ≈ 128 000 | 11 | 4 : _photos + ynth + è + se |
| Qwen3 (Alibaba) | ≈ 152 000 | 11 | 4 : _photos + ynth + è + se |
| Mistral 7B (SentencePiece) | 32 768 | 13 | 4 : _photos + yn + th + èse |
Le symbole _ représente une espace, rattachée au token qui suit. Les tailles de dictionnaire sont arrondies. Un grand dictionnaire tend à raccourcir les textes, mais ce n'est pas systématique : Gemma 3 (≈ 262 000 tokens) produit 10 tokens pour cette phrase, contre 9 pour Tekken (≈ 131 000). La découpe dépend aussi des langues et du corpus utilisés pour construire le dictionnaire.
Ce que révèle la comparaison
Les huit tokenizers du tableau lisent la même phrase, mais ne la découpent pas de la même façon. Ces différences montrent ce qu'est vraiment un token.
- « photosynthèse » n'a d'entrée propre dans aucun dictionnaire : ce mot rare est reconstitué à partir de trois ou quatre fragments. Tekken, GPT-4o, DeepSeek et Gemma 3 le coupent en trois (
_photos,ynth,èse), tandis que GPT-4, Llama 3 et Qwen3 séparent aussi la fin enèetse. - « simplement » forme un seul token, le caractère 'espace' compris, dans tous les tokenizers sauf celui de Mistral 7B. Son dictionnaire, plus petit, le coupe en
_simpleetment. - « Explique » est coupé en deux (
Expl,ique) par tous les tokenizers, bien qu'il s'agisse d'un verbe courant : la découpe suit les statistiques du corpus, pas la grammaire. - « -moi » reçoit trois traitements différents : un seul token chez Tekken et GPT-4o,
-metoichez DeepSeek, GPT-4, Llama 3 et Qwen3, ou encore-etmoichez Gemma 3. Mistral 7B le découpe en trois tokens. Le point final, lui, forme toujours un token à part. - Le total varie de 9 à 13 tokens. La taille du dictionnaire ne suffit pas à l'expliquer : Gemma 3, avec le plus grand dictionnaire du tableau, produit 10 tokens contre 9 pour Tekken.
Un token n'est donc pas une unité linguistique stable : il dépend du dictionnaire de chaque modèle. Seuls quelques points sont constants, comme l'espace rattachée au mot qui la suit, la ponctuation isolée ou la coupure de « Explique » en Expl et ique.
Pourquoi découper ainsi ?
Le dictionnaire est construit avant l'entraînement par une méthode comme le byte-pair encoding : on part des caractères, puis on fusionne de façon répétée les paires les plus fréquentes du corpus. Les séquences courantes deviennent des tokens entiers, les séquences rares restent en morceaux. C'est un compromis : un grand dictionnaire raccourcit les textes mais alourdit le modèle, un petit dictionnaire allonge les séquences à traiter.
Le même texte n'est donc pas découpé de la même façon d'un modèle à l'autre. Le tokenizer SentencePiece de Mistral 7B, dont le dictionnaire compte environ 32 000 tokens, produit 13 tokens pour la même phrase au lieu de 9. En pratique, la fenêtre de contexte et la facturation des services d'IA se mesurent en tokens, et les langues moins présentes dans le corpus en demandent souvent davantage pour dire la même chose.
Du token au nombre
Le modèle ne reçoit que la liste des numéros : 60 795, 2 508, 33 001, 1 427, 17 159, 20 602, 24 380, 37 507, 1 046. Ces numéros sont de simples adresses dans le dictionnaire et n'ont aucun sens par eux-mêmes. C'est à l'étape suivante, le plongement, que chacun est remplacé par un vecteur de milliers de nombres appris pendant l'entraînement. Le modèle ne « voit » donc jamais les lettres de « photosynthèse », ce qui explique ses difficultés à compter les lettres d'un mot.
Le plongement : du numéro au vecteur
Un numéro n'a pas de sens
Après la tokenisation, le modèle dispose d'une liste de numéros. Or le numéro 17 159, qui désigne le token _photos dans notre exemple, n'est qu'une adresse dans le dictionnaire : il n'est pas plus proche de 17 160 que de 90 000. Pour calculer, le modèle a besoin d'une représentation où la proximité reflète une ressemblance d'usage. C'est le rôle du plongement (embedding en anglais).
Une table de vecteurs appris
Le plongement est une immense table qui contient une ligne par token du dictionnaire. Chaque ligne est un vecteur, c'est-à-dire une liste de milliers de nombres. Pour passer du numéro au vecteur, le modèle lit simplement la ligne correspondante :
_photos (numéro 17 159) → [0,021 ; −0,134 ; 0,087 ; … ; 0,052]
Ces valeurs sont fictives et la liste réelle compte, par exemple, 4 096 nombres. Ils ne sont pas écrits par des humains : ce sont des coefficients ajustés pendant l'entraînement, au même titre que ceux de l'attention. Pour un dictionnaire de 131 072 tokens et des vecteurs de 4 096 nombres, cette table représente à elle seule environ 537 millions de coefficients.
Des vecteurs qui se rapprochent selon l'usage
Au fil de l'entraînement, les tokens employés dans des contextes semblables reçoivent des vecteurs voisins. Le vecteur de _simplement se retrouve ainsi plus proche de celui d'un adverbe comparable que de celui d'un nom propre. Cet espace compte des milliers de dimensions : on ne peut pas le dessiner, mais on peut y mesurer des distances et des angles.
Le vecteur d'un token est toujours le même, quel que soit son entourage. Un fragment comme ynth n'a pas de sens à lui seul : c'est l'étape suivante, l'attention, qui le met en relation avec _photos et èse pour reconstituer « photosynthèse ».
L'ordre des tokens
Comme le même token donne le même vecteur partout, il faut aussi indiquer sa position dans la phrase, car « le chat mange la souris » n'a pas le même sens que « la souris mange le chat ». Selon les modèles, cette information est ajoutée aux vecteurs ou, le plus souvent aujourd'hui, appliquée sous forme de rotation à l'intérieur des couches d'attention.
Ce que reçoit le modèle
Les 9 numéros de notre exemple deviennent ainsi 9 vecteurs, soit un tableau de 9 lignes et 4 096 colonnes, c'est-à-dire 36 864 nombres. C'est cette matrice, et non plus du texte, qui entre dans les blocs Transformer.
| Rang | Token | Numéro | Dim. 1 | Dim. 2 | Dim. 3 | Dim. 4 | … | Dim. 4 096 |
|---|---|---|---|---|---|---|---|---|
| 1 | Expl | 60 795 | 0,0130 | 0,0121 | −0,0297 | −0,0022 | … | 0,0085 |
| 2 | ique | 2 508 | 0,0064 | −0,0154 | −0,0113 | 0,0039 | … | −0,0185 |
| 3 | -moi | 33 001 | −0,0031 | −0,0255 | 0,0001 | −0,0199 | … | 0,0013 |
| 4 | _la | 1 427 | 0,0207 | 0,0212 | 0,0177 | −0,0262 | … | 0,0086 |
| 5 | _photos | 17 159 | −0,0090 | −0,0208 | 0,0028 | 0,0111 | … | 0,0343 |
| 6 | ynth | 20 602 | −0,0043 | 0,0203 | −0,0563 | −0,0060 | … | −0,0005 |
| 7 | èse | 24 380 | −0,0103 | 0,0161 | −0,0043 | 0,0160 | … | 0,0167 |
| 8 | _simplement | 37 507 | −0,0164 | −0,0030 | −0,0016 | −0,0035 | … | −0,0138 |
| 9 | . | 1 046 | −0,0134 | 0,0071 | −0,0151 | −0,0090 | … | 0,0133 |
Seules 5 colonnes sur 4 096 sont affichées, soit 9 × 4 096 = 36 864 nombres au total. Ces valeurs sont illustratives : elles ont l'ordre de grandeur de celles d'un plongement réel (de petits nombres, positifs ou négatifs, de l'ordre du centième), sans être extraites d'un modèle précis. Dans un vrai modèle, elles ne sont pas limitées à l'intervalle de −1 à 1.
Références
- Wikipédia : Byte pair encoding (nouvelle fenêtre)
- Kudo, T. et Richardson, J. : « SentencePiece: A simple and language independent subword tokenizer and detokenizer for Neural Text Processing », EMNLP (System Demonstrations), 2018 (nouvelle fenêtre)
- Mistral AI : « Mistral NeMo », présentation du tokenizer Tekken, 18 juillet 2024 (nouvelle fenêtre)
FAQ : Le token dans les LLM
Qu'est-ce qu'un token ?
Un token est l'unité de texte manipulée par un LLM : un mot fréquent, un morceau de mot, un signe de ponctuation ou un nombre. Chaque token correspond à un numéro dans le dictionnaire du modèle.
Un token est-il un mot ?
Pas forcément. Les mots très fréquents forment souvent un seul token, tandis que les mots rares sont découpés en fragments. Dans notre exemple, « photosynthèse » donne trois tokens et « simplement » un seul. L'espace qui précède un mot est généralement incluse dans le token.
Combien de tokens faut-il pour un mot ou une page ?
Cela dépend de la langue, du texte et du tokenizer. En français, on compte souvent entre 1,3 et 2 tokens par mot. Notre phrase d'exemple compte 5 mots pour 9 tokens avec Tekken, et 13 avec le tokenizer de Mistral 7B.
Qui décide de la découpe en tokens ?
Le tokenizer, un composant distinct du réseau de neurones. Son dictionnaire est construit avant l'entraînement, par exemple avec la méthode du byte-pair encoding, qui fusionne de façon répétée les paires de caractères les plus fréquentes du corpus. Il reste ensuite figé.
Pourquoi le même texte n'a-t-il pas le même nombre de tokens d'un modèle à l'autre ?
Parce que chaque modèle a son propre dictionnaire, de taille et de contenu différents. Un dictionnaire plus grand raccourcit les textes, un plus petit les allonge. Les numéros des tokens ne sont donc pas comparables d'un modèle à l'autre.
Pourquoi les services d'IA comptent-ils en tokens ?
Parce que le token est l'unité de calcul du modèle. La fenêtre de contexte (la quantité de texte que le modèle peut lire d'un coup) et la facturation de nombreux services se mesurent en tokens, et le temps de calcul augmente avec leur nombre.
Un token a-t-il un sens ?
Pas par lui-même. Son numéro n'est qu'une adresse dans le dictionnaire. Le sens apparaît à l'étape suivante, le plongement, qui remplace chaque numéro par un vecteur de milliers de nombres appris pendant l'entraînement, puis dans les couches d'attention qui relient les tokens entre eux.
Pourquoi un LLM a-t-il du mal à compter les lettres d'un mot ?
Parce qu'il ne « voit » pas les lettres : il manipule des tokens. Il n'a pas accès aux lettres de « photosynthèse », seulement aux trois fragments _photos, ynth et èse.
 Le trajet du prompt à la réponse : dans les coulisses d'un LLM
 Le token : l’unité fondamentale des grands modèles de langage
 Les différents types d'apprentissage des IA
 IA Agentique : Quand les machines deviennent autonomes
 Ce que les IA ne savent pas faire
 Intelligence artificielle et astronomie : Comprendre le rôle des assistants IA
 Outils d’intelligence artificielle : comment choisir ?

 IA Générative vs AGI: Où s’arrête l’imitation, où commence la conscience?
 Réseaux artificiels vs réseaux biologiques: Deux systèmes, une architecture commune
 Cerveau Humain et Intelligences Artificielles: Similitudes et Différences
 AlphaGo contre AlphaGo Zero: Une Révolution dans l'Intelligence Artificielle
 La prochaine étape des machines intelligentes
 Du Neurone Biologique au Neurone Formel: Simplification du Cerveau
 Intelligence artificielle: l'explosion du gigantisme
 Quand l'intelligence artificielle devient folle!
 Comment les machines deviennent intelligentes
 Intelligence artificielle : menace réelle ou opportunité pour l'humanité ?
 Comment les machines comprennent, interprètent et génèrent un langage de manière similaire à celle des humains?
 Comment fonctionne un réseau de neurones artificiels?